

Python类型注解基础语法:变量、函数参数与返回值写法
详解Python类型注解的基础语法,包括变量注解、函数参数注解和返回值注解的写法,配合完整示例帮助理解实际用法。
Python从3.5版本开始支持类型注解(Type Hints),允许开发者在代码中标明变量的类型、函数参数的类型和返回值的类型。类型注解不会影响程序运行——Python解释器不会根据注解做类型检查——但它能让代码意图更清晰,配合mypy等静态检查工具还可以在运行前发现类型错误。本文将依次讲解变量注解、函数参数注解和返回值注解的具体写法,并说明常见的组合类型和容易出错的地方。
变量类型注解
变量注解的语法很直接:在变量名后面加冒号和类型名,再跟赋值语句。这个语法在Python 3.6及以上版本可用。
name: str = "Alice"
age: int = 30
height: float = 1.72
is_active: bool = True
冒号后面的 str、int 等就是类型注解。赋值号右边的值才是变量真正存储的内容。即使你写了 age: int = "三十",Python也不会报错——注解只是一种标记,不做强制检查。
变量注解也可以只声明类型而不赋值,这在类的属性定义中比较常见:
class User:
    name: str
    age: int

    def __init__(self, name: str, age: int):
        self.name = name
        self.age = age
这里类体中的 name: str 和 age: int 没有赋值,它们告诉阅读代码的人(以及静态检查工具)这个类的实例会有哪些属性、分别是什么类型。
函数参数类型注解
函数参数的注解写在参数名后面,同样用冒号分隔:
def greet(name: str, times: int) -> None:
    for _ in range(times):
        print(f"Hello, {name}!")
这段代码表明 name 应该接收一个字符串,times 应该接收一个整数。调用时如果传入了不匹配的类型,程序仍然能运行(前提是实际操作不出错),但mypy等工具会给出警告。
带默认值的参数
当参数有默认值时,注解写在参数名和等号之间:
def connect(host: str, port: int = 3306, timeout: float = 5.0) -> None:
    print(f"Connecting to {host}:{port}, timeout={timeout}s")
顺序是:参数名、冒号、类型、等号、默认值。注意冒号和等号周围的空格写法——PEP 8建议冒号后面有一个空格,等号两边各一个空格,与没有注解时默认值参数等号不加空格的惯例不同。
*args和**kwargs的注解
对于可变参数,注解的是每个单独元素的类型,而不是整个元组或字典的类型:
def log(*messages: str, **config: int) -> None:
    for msg in messages:
        print(msg)
    for key, value in config.items():
        print(f"{key} = {value}")
这里 *messages: str 表示每个位置参数都应该是字符串,**config: int 表示每个关键字参数的值都应该是整数。不需要写成 Tuple[str, ...] 或 Dict[str, int],Python会自动理解。
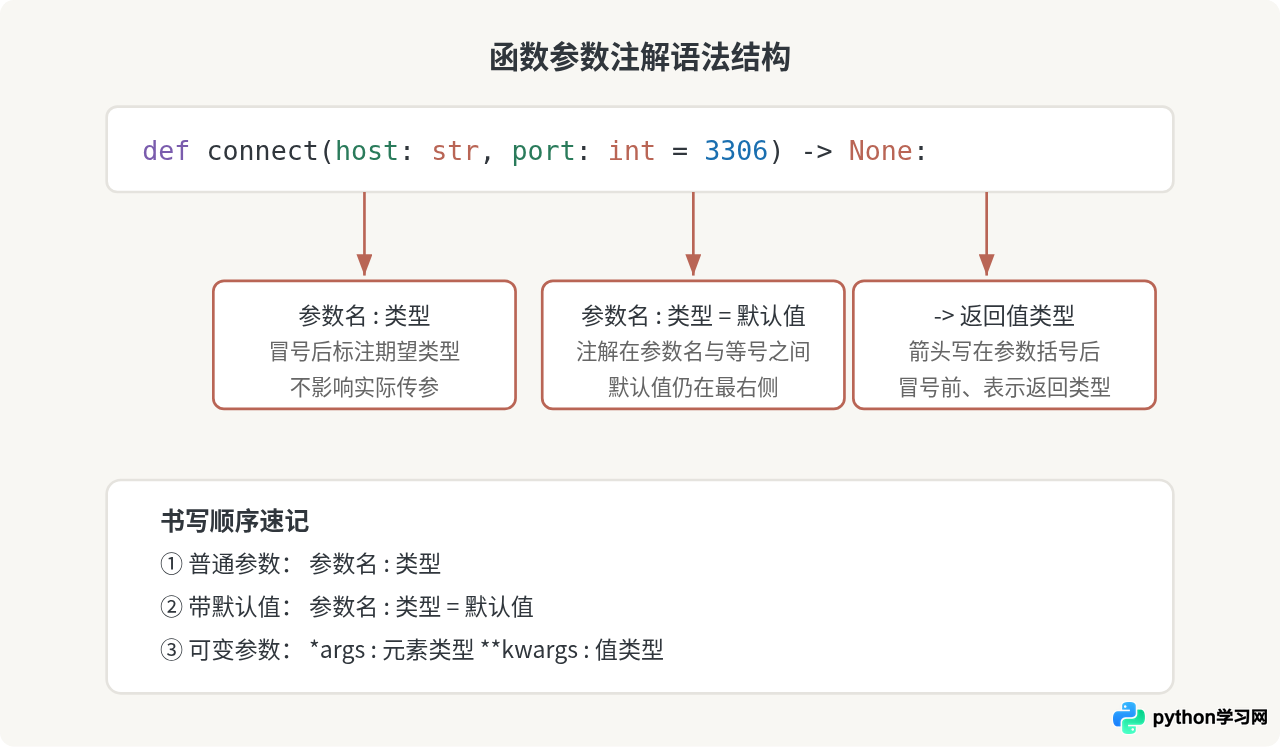
图1:函数定义中参数注解与返回值注解的语法位置
返回值类型注解
返回值注解用箭头 -> 写在参数列表的右括号和冒号之间:
def add(a: int, b: int) -> int:
    return a + b

def get_user_info(user_id: int) -> dict:
    return {"id": user_id, "name": "unknown"}
如果函数没有return语句或者只写了 return(不带值),返回值类型应该标注为 None:
def save_log(content: str) -> None:
    with open("app.log", "a") as f:
        f.write(content + "\n")
返回值注解是整个函数签名中最容易遗漏的部分。加上它之后,调用者不需要阅读函数体就能知道函数返回什么类型的数据,在大型项目中尤其有用。
常用的组合类型
实际代码中,变量和参数的类型经常不只是简单的 int 或 str。Python的 typing 模块提供了多种组合类型。
容器类型
Python 3.9以上可以直接使用内置类型作为泛型,不需要从typing导入:
# Python 3.9+
names: list[str] = ["Alice", "Bob"]
scores: dict[str, int] = {"Alice": 95, "Bob": 87}
point: tuple[float, float] = (3.14, 2.72)
unique_ids: set[int] = {1, 2, 3}
Python 3.8及更早版本需要从typing模块导入对应的大写版本:
# Python 3.8 及更早版本
from typing import List, Dict, Tuple, Set

names: List[str] = ["Alice", "Bob"]
scores: Dict[str, int] = {"Alice": 95, "Bob": 87}
可选类型和联合类型
当一个值可能是某个类型或者 None 时,使用 Optional:
from typing import Optional

def find_user(user_id: int) -> Optional[str]:
    users = {1: "Alice", 2: "Bob"}
    return users.get(user_id)  # 可能返回str,也可能返回None
Optional[str] 等价于 Union[str, None]。如果一个参数可能是多种类型,用 Union:
from typing import Union

def format_id(value: Union[int, str]) -> str:
    return str(value).zfill(6)
Python 3.10以上可以用竖线语法代替 Union,写起来更简洁:
# Python 3.10+
def format_id(value: int | str) -> str:
    return str(value).zfill(6)

def find_user(user_id: int) -> str | None:
    users = {1: "Alice", 2: "Bob"}
    return users.get(user_id)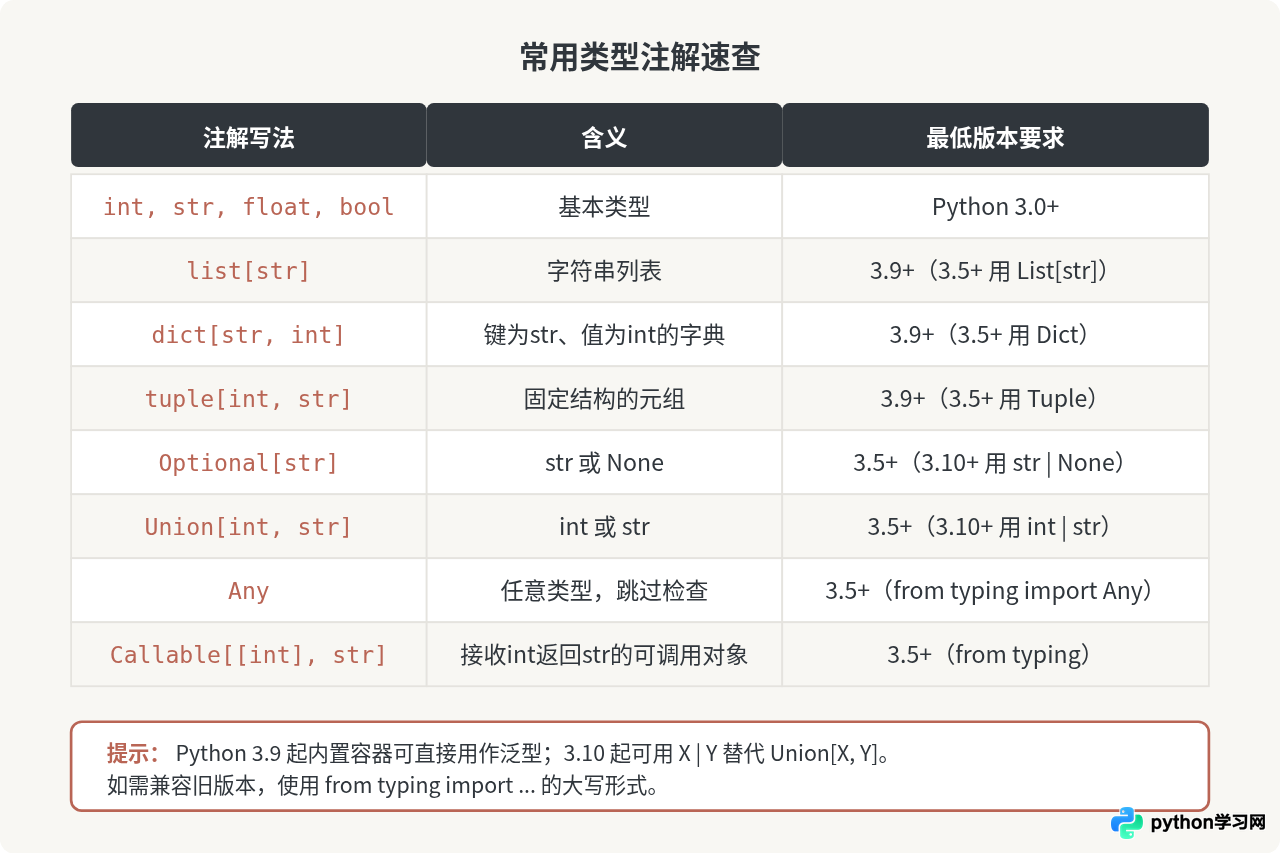
图2:常用类型注解的写法、含义及版本要求对照
一个完整的实例
下面的例子把变量注解、参数注解和返回值注解放在一起,模拟一个简单的成绩统计场景:
from typing import Optional


def calculate_average(scores: list[float]) -> Optional[float]:
    """计算平均分,空列表返回None"""
    if not scores:
        return None
    total: float = sum(scores)
    count: int = len(scores)
    return total / count


def format_result(name: str, avg: Optional[float]) -> str:
    """格式化输出结果"""
    if avg is None:
        return f"{name}: 暂无成绩"
    return f"{name}: 平均分 {avg:.1f}"


# 使用示例
student_name: str = "张三"
math_scores: list[float] = [85.5, 92.0, 78.5, 96.0]

average: Optional[float] = calculate_average(math_scores)
result: str = format_result(student_name, average)
print(result)
运行这段代码的输出:
# 示例输出
张三: 平均分 88.0注意几个细节:calculate_average 的返回值标注为 Optional[float],因为空列表时会返回 None;函数内部的 total 和 count 也加了注解,虽然不是必需的,但在复杂函数中有助于阅读;调用处的 average 变量也标注了类型,与函数返回值保持一致。
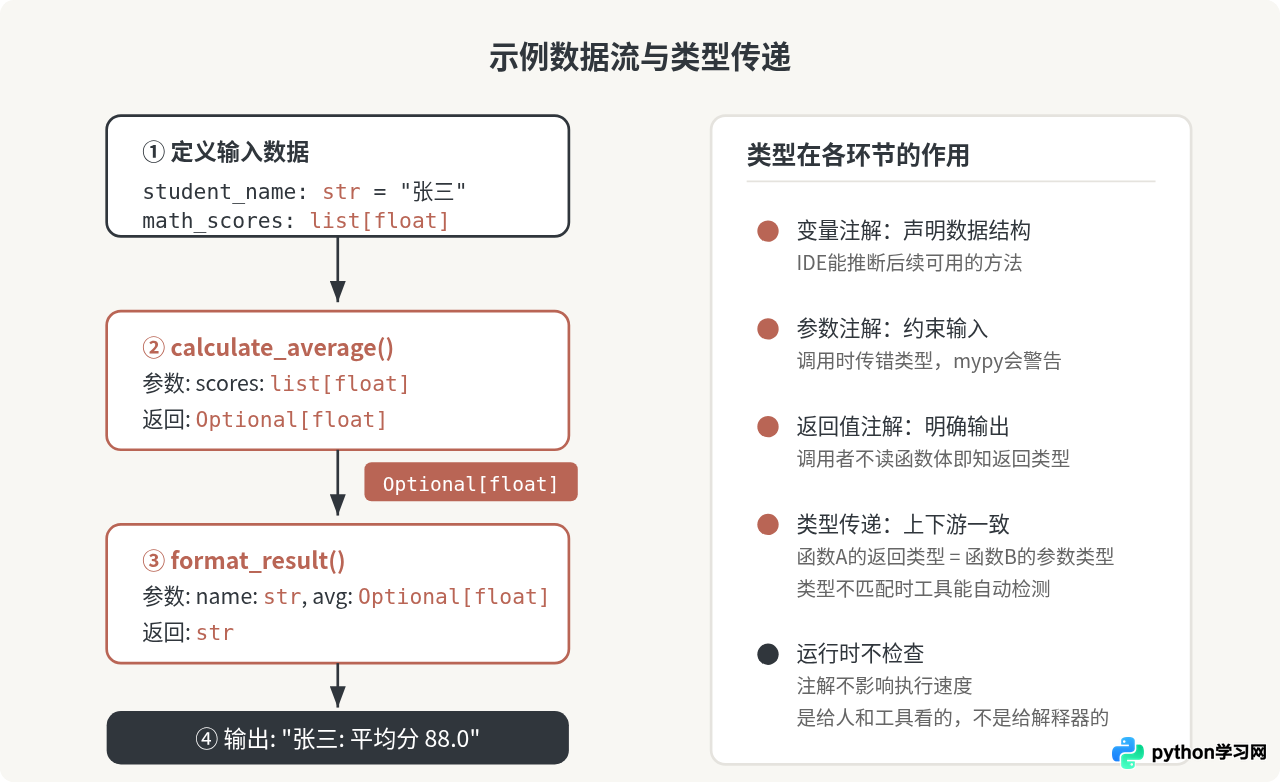
图3:成绩统计示例中数据流动与类型在各环节的作用
容易犯的错误和注意事项
类型注解的语法不复杂,但初学时有几个地方容易出错。
1. 混淆注解和赋值
写 x: int 只是声明了类型,并没有创建变量。如果在声明之后直接使用 x,会得到 NameError:
x: int
print(x) # NameError: name 'x' is not defined必须赋值之后才能使用:x: int = 0。
2. 可变默认值问题
这不是类型注解特有的问题,但在加了注解之后更容易被忽视:
# 错误写法——所有调用共享同一个列表
def append_item(item: str, lst: list[str] = []) -> list[str]:
    lst.append(item)
    return lst

# 正确写法
def append_item(item: str, lst: Optional[list[str]] = None) -> list[str]:
    if lst is None:
        lst = []
    lst.append(item)
    return lst
3. 注解不等于类型检查
这一点值得反复强调:Python解释器不会根据注解拒绝执行代码。下面的代码完全可以运行:
age: int = "不是数字"  # Python不会报错
print(age.upper())    # 正常输出 "不是数字"(的大写形式无效果,但不报错)
要让注解真正发挥检查作用,需要配合静态类型检查工具。最常用的是mypy:
# 安装mypy
pip install mypy

# 检查某个文件
mypy your_script.py
mypy会读取代码中的注解,报告类型不一致的地方,但不会执行代码。
4. 版本兼容性
如果项目需要支持Python 3.8或更早版本,不能使用 list[str]、int | str 这些新语法。可以在文件开头加上:
from __future__ import annotations这行导入会让当前文件中的所有注解延迟求值(变成字符串),从而允许使用新语法而不触发运行时错误。但要注意,这只解决了语法层面的兼容性,如果在运行时通过 get_type_hints() 等函数解析注解,仍然可能出问题。
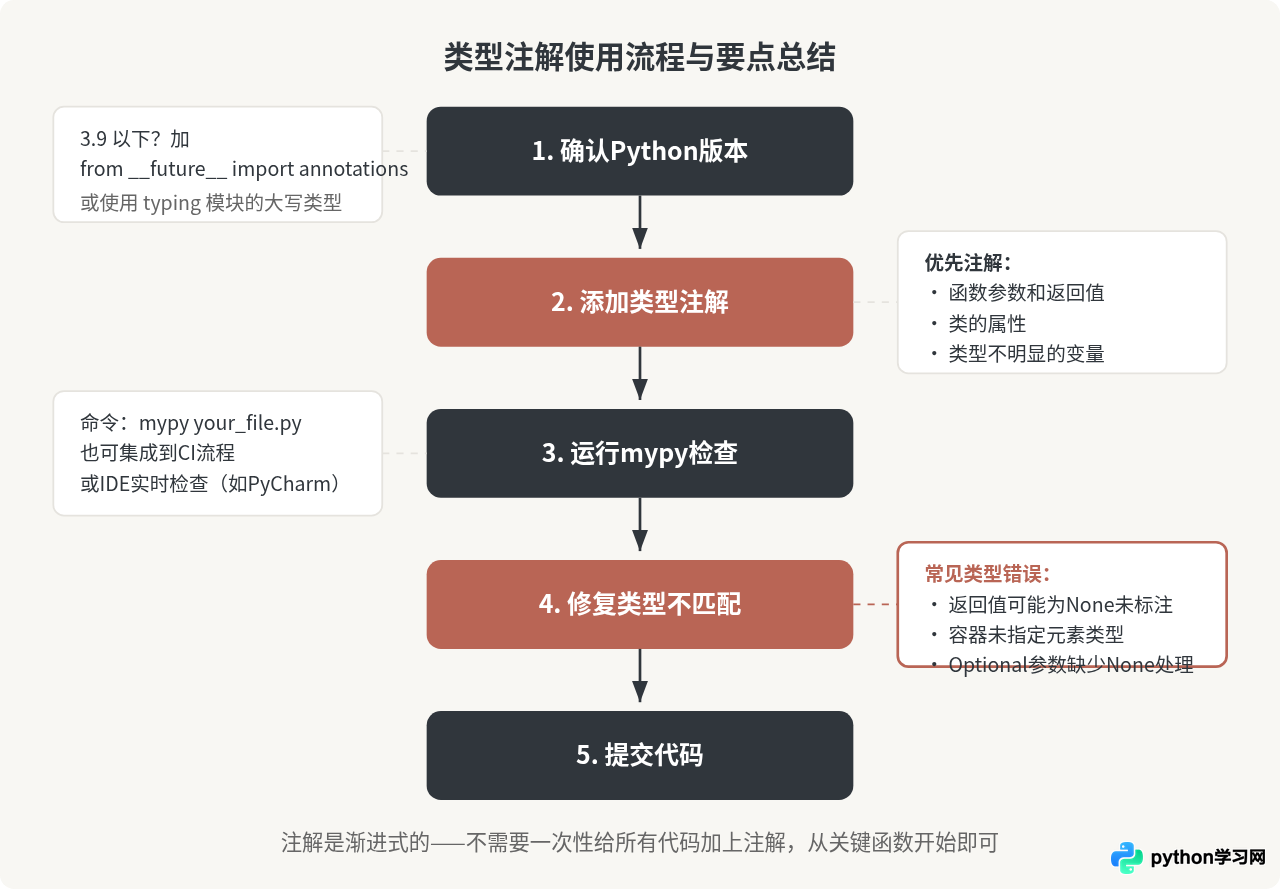
图4:在项目中引入类型注解的典型流程与各步骤要点
什么时候该加注解、加到什么程度
类型注解是可选的,也没有"必须给每一行都加注解"的要求。实际中比较合理的做法是:
- 函数签名优先——参数和返回值的注解价值最高。大部分IDE和静态检查工具主要依赖函数签名上的注解来推断整个调用链的类型。
- 类属性也值得加——尤其是
__init__中初始化的属性,注解后IDE的自动补全会准确很多。 - 局部变量通常不需要——如果从赋值就能看出类型(比如
count = 0),加注解反而显得冗余。只在类型不明显或者赋值来自复杂表达式时才有必要标注。 - 渐进添加——不需要把整个项目一次性全部加上注解。可以从新写的代码、核心模块或者出过bug的地方开始,逐步扩展覆盖范围。
类型注解的本质是一种文档化手段,它用形式化的语法把原本只存在于开发者脑中的类型约定写进了代码。写得好的注解能减少团队沟通成本、降低重构风险,但过度使用(比如给每个显而易见的局部变量都加上注解)反而会让代码变得嘈杂。把握好这个度,就能从类型注解中获得最大的收益。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









