

大模型应用开发入门:从API调用到第一个Python Demo

许多开发者面对“大模型应用开发”这一概念时,第一反应往往是庞大的参数量、昂贵的显卡集群或是深奥的Transformer架构。这种认知偏差导致大量具备工程能力的程序员止步于门槛之外,误以为只有算法专家才能涉足这一领域。
事实上,对于绝大多数应用场景而言,我们不需要从头训练一个模型,而是需要学会如何“使用”模型。大模型正在从一种研究客体转变为一种基础设施,就像数据库或云服务一样。真正的开发重心,已经从模型权重的调整,转移到了如何设计提示词、如何处理上下文以及如何将模型的输出结构化地融入业务逻辑中。
大模型应用开发的本质,是构建一个高效的“翻译层”:将用户的需求转化为模型能理解的指令,再将模型的自由文本转化为程序可处理的数据。 本文将跳过数学推导,直接通过Python环境下的API调用,展示如何从零开始构建第一个大模型应用Demo。
准备阶段:密钥管理与环境隔离
在编写任何代码之前,首要任务是获得访问权限并建立安全的开发环境。目前主流的大模型服务商(如OpenAI、Anthropic或国内的文心一言、通义千问等)均提供基于HTTP的API接口。获取API Key是第一步,但这串字符等同于你的账户余额和权限凭证,绝不能硬编码在代码文件中。
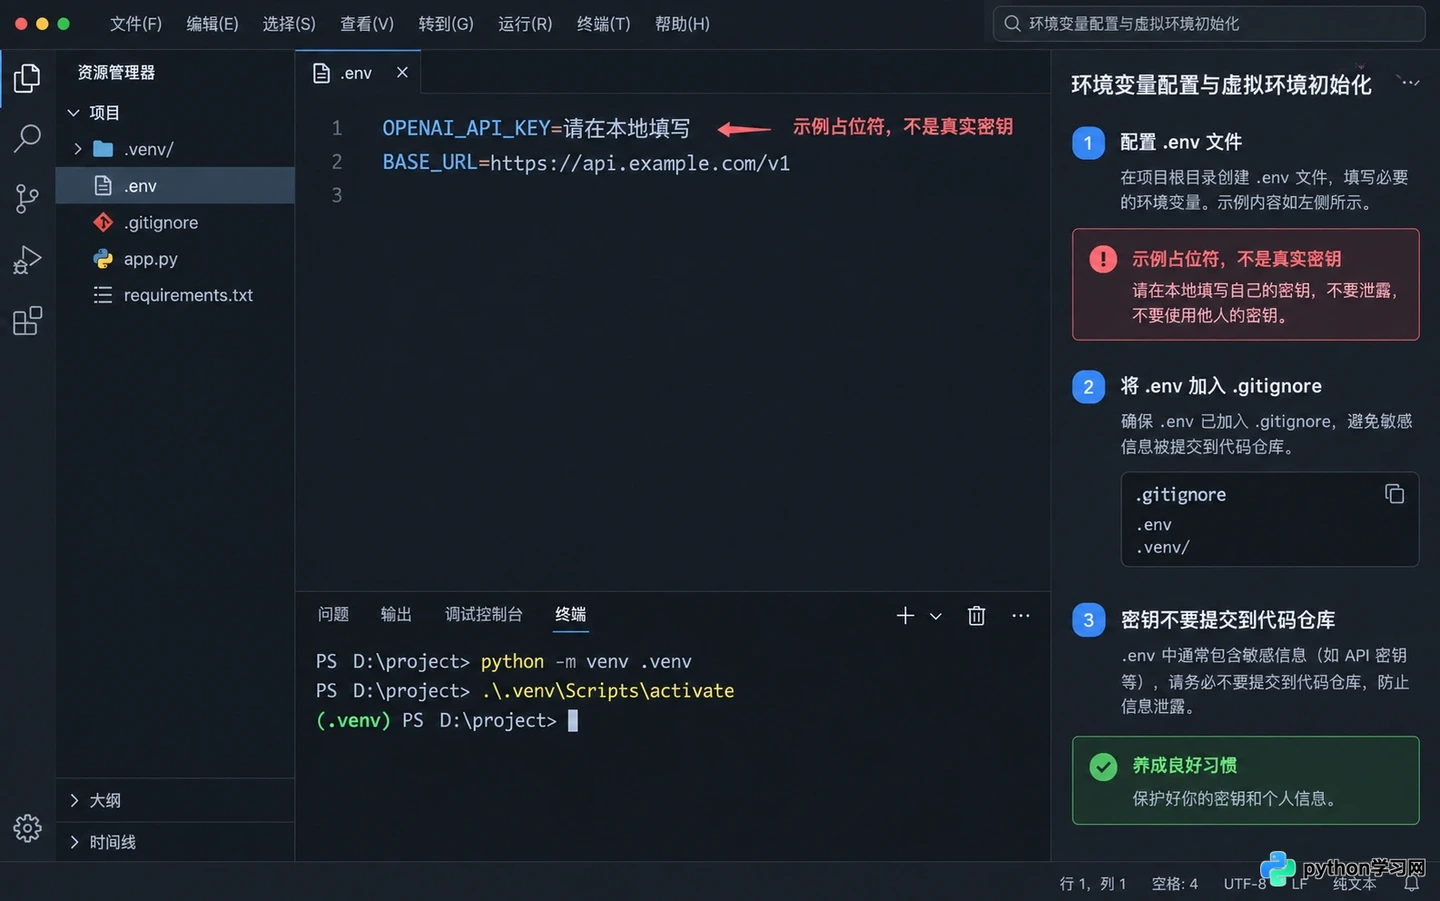
环境变量配置与虚拟环境初始化
建议创建一个独立的.env文件来存储敏感信息,并使用python-dotenv库进行加载。这种做法不仅符合安全规范,也便于在不同环境(开发、测试、生产)间切换配置。同时,为了避免依赖冲突,务必使用虚拟环境。在终端中执行以下命令初始化项目:
mkdir llm-demo
cd llm-demo
python -m venv venv
source venv/bin/activate  # Windows下使用 venv\Scripts\activate
pip install openai python-dotenv
在项目根目录创建.env文件,填入你的API密钥:
OPENAI_API_KEY=sk-your-api-key-here
BASE_URL=https://api.example.com/v1  # 如果使用兼容OpenAI接口的其他服务商
这种分离配置的方式,确保了即使代码被上传至公开仓库,核心凭证依然安全。对于初学者而言,选择一个兼容OpenAI SDK的服务商可以大幅降低学习成本,因为大多数教程和社区资源都基于这一标准接口。
核心交互:从自然语言到结构化响应
传统的软件开发依赖于确定的输入输出,而大模型的核心特征是概率性与生成性。第一个Demo的目标不是构建复杂的界面,而是验证“发送请求-接收响应”这一链路的通畅,并观察模型对指令的遵循程度。
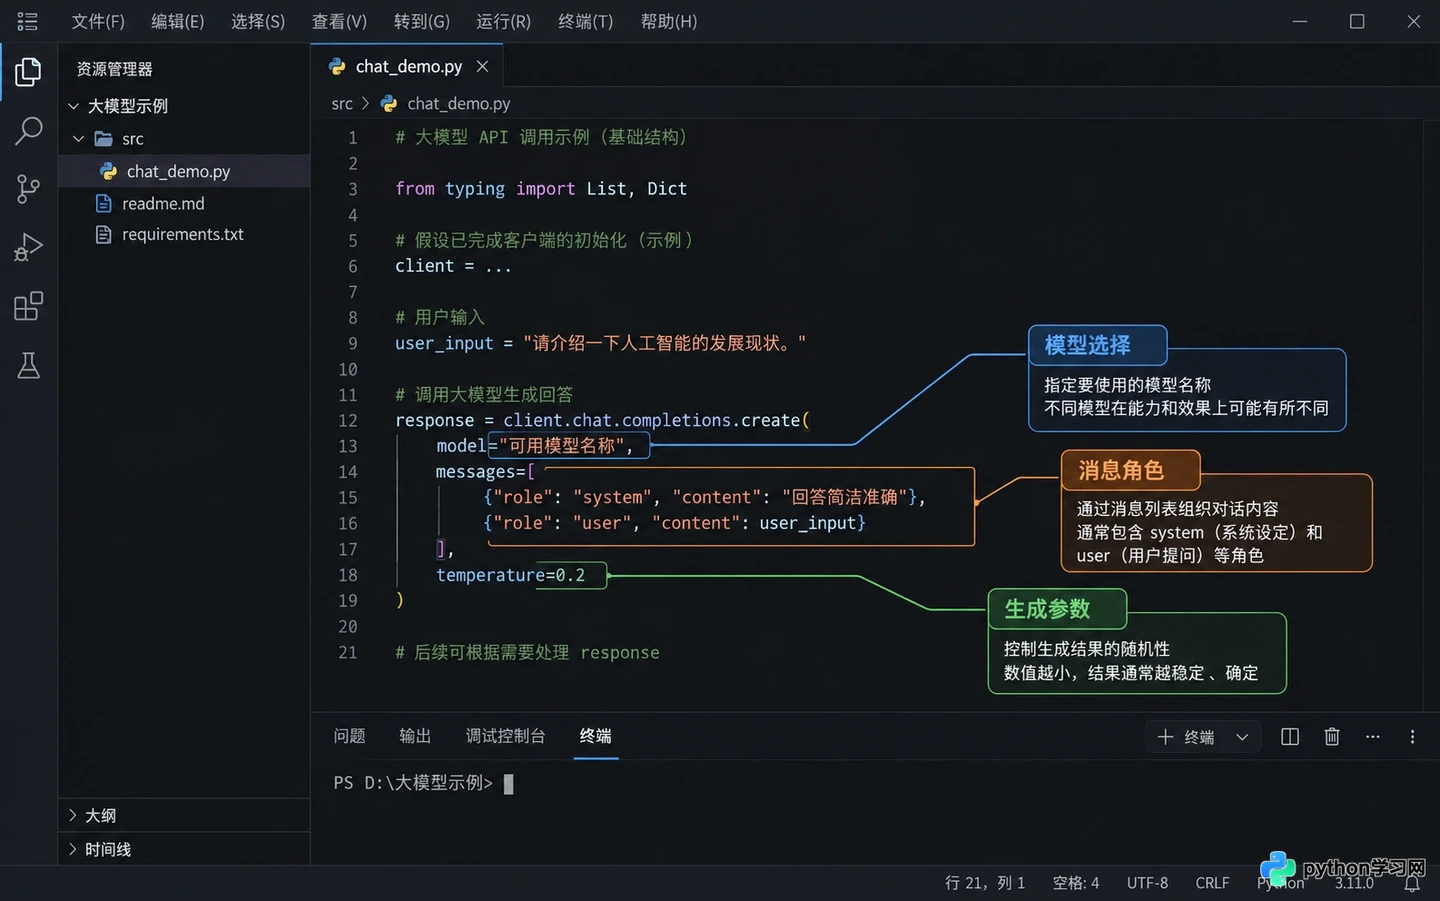
基础API调用代码结构
创建一个名为app.py的文件,编写最基础的对话逻辑。这里的关键在于理解messages列表的结构:它不仅仅包含用户的问题,还包含了系统设定(System Prompt),用于定义模型的角色和行为边界。
import os
from dotenv import load_dotenv
from openai import OpenAI

# 加载环境变量
load_dotenv()

client = OpenAI(
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url=os.getenv("BASE_URL", "https://api.openai.com/v1")
)

def chat_with_bot(user_input):
    try:
        response = client.chat.completions.create(
            model="gpt-3.5-turbo",  # 或替换为其他可用模型
            messages=[
                {"role": "system", "content": "你是一个乐于助人的编程助手,回答需简洁准确。"},
                {"role": "user", "content": user_input}
            ],
            temperature=0.7,
            max_tokens=500
        )
        return response.choices[0].message.content
    except Exception as e:
        return f"发生错误: {str(e)}"

if __name__ == "__main__":
    print("欢迎使用简易大模型Demo,输入'quit'退出。")
    while True:
        user_query = input("\n请输入问题: ")
        if user_query.lower() == 'quit':
            break
        reply = chat_with_bot(user_query)
        print(f"AI回复: {reply}")
这段代码展示了大模型应用开发中最基本的三个要素:角色设定、温度参数(Temperature)和令牌限制(Max Tokens)。温度参数控制了输出的随机性,数值越低,结果越确定;数值越高,创意越强。在需要准确信息的场景下,通常建议将温度设置在0.2到0.5之间。
运行脚本后,你将看到一个简单的命令行交互界面。此时,你不仅是在调用一个接口,更是在体验“提示词工程”的雏形:系统消息中的每一句话都在潜移默化地影响模型的语气和专业度。
进阶控制:让输出变得可解析
如果大模型只返回自由文本,它在传统软件系统中的价值将大打折扣。真正的应用开发难点,在于如何让模型输出JSON、XML或其他结构化数据,以便后端程序可以直接解析和使用。
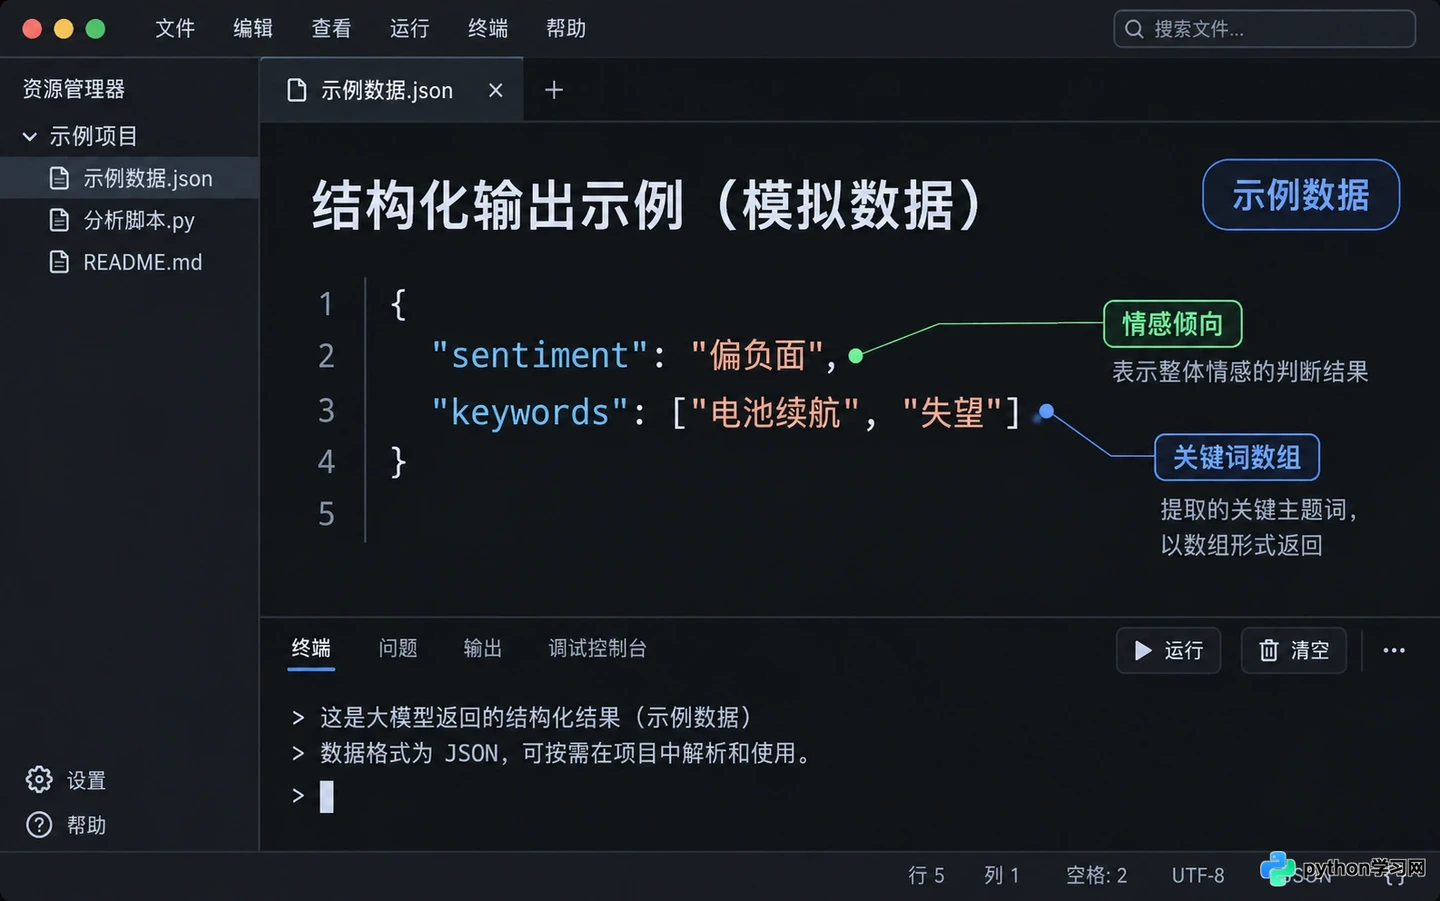
结构化JSON输出示例
假设我们需要开发一个功能:提取用户评论中的情感倾向和关键词。如果不加约束,模型可能会输出一段长篇大论的分析。通过强制要求JSON格式,我们可以将非结构化数据转化为结构化数据。
修改chat_with_bot函数中的系统提示词:
def extract_sentiment(text):
    prompt = f"""
    请分析以下文本的情感倾向,并提取关键主题。
    请严格仅返回JSON格式,不要包含任何其他解释性文字。
    格式示例:{{"sentiment": "positive/negative/neutral", "keywords": ["词1", "词2"]}}

    待分析文本:{text}
    """

    response = client.chat.completions.create(
        model="gpt-3.5-turbo",
        messages=[
            {"role": "system", "content": "你是一个数据提取专家,只输出合法的JSON字符串。"},
            {"role": "user", "content": prompt}
        ],
        temperature=0.1,  # 低温度以保证格式稳定
        response_format={"type": "json_object"} # 部分API支持此参数强制JSON输出
    )

    content = response.choices[0].message.content
    import json
    try:
        return json.loads(content)
    except json.JSONDecodeError:
        return {"error": "解析失败", "raw": content}

# 测试
result = extract_sentiment("这款笔记本性能很强,但是电池续航实在太短了,有点失望。")
print(result)
在这个场景中,我们将温度降至0.1,以最大程度减少模型“发挥”的可能性,确保输出格式的稳定性。虽然现代模型对JSON的支持越来越好,但在生产环境中,仍建议在代码层增加重试机制和校验逻辑,以应对偶尔出现的格式错误。
结构化输出的意义在于打通了大模型与传统数据库、前端展示之间的壁垒。 一旦模型能够稳定输出JSON,它就可以作为后端的一个智能微服务,为搜索推荐、内容分类、自动化报表等场景提供动力。
边界与局限:并非万能的黑盒
尽管上述Demo展示了大模型应用的便捷性,但开发者必须清醒认识到其局限性。首先,大模型存在“幻觉”问题,即可能自信地编造事实。因此,在涉及医疗、法律或金融建议的场景中,必须引入人工审核或引用权威知识库(RAG技术)进行佐证。
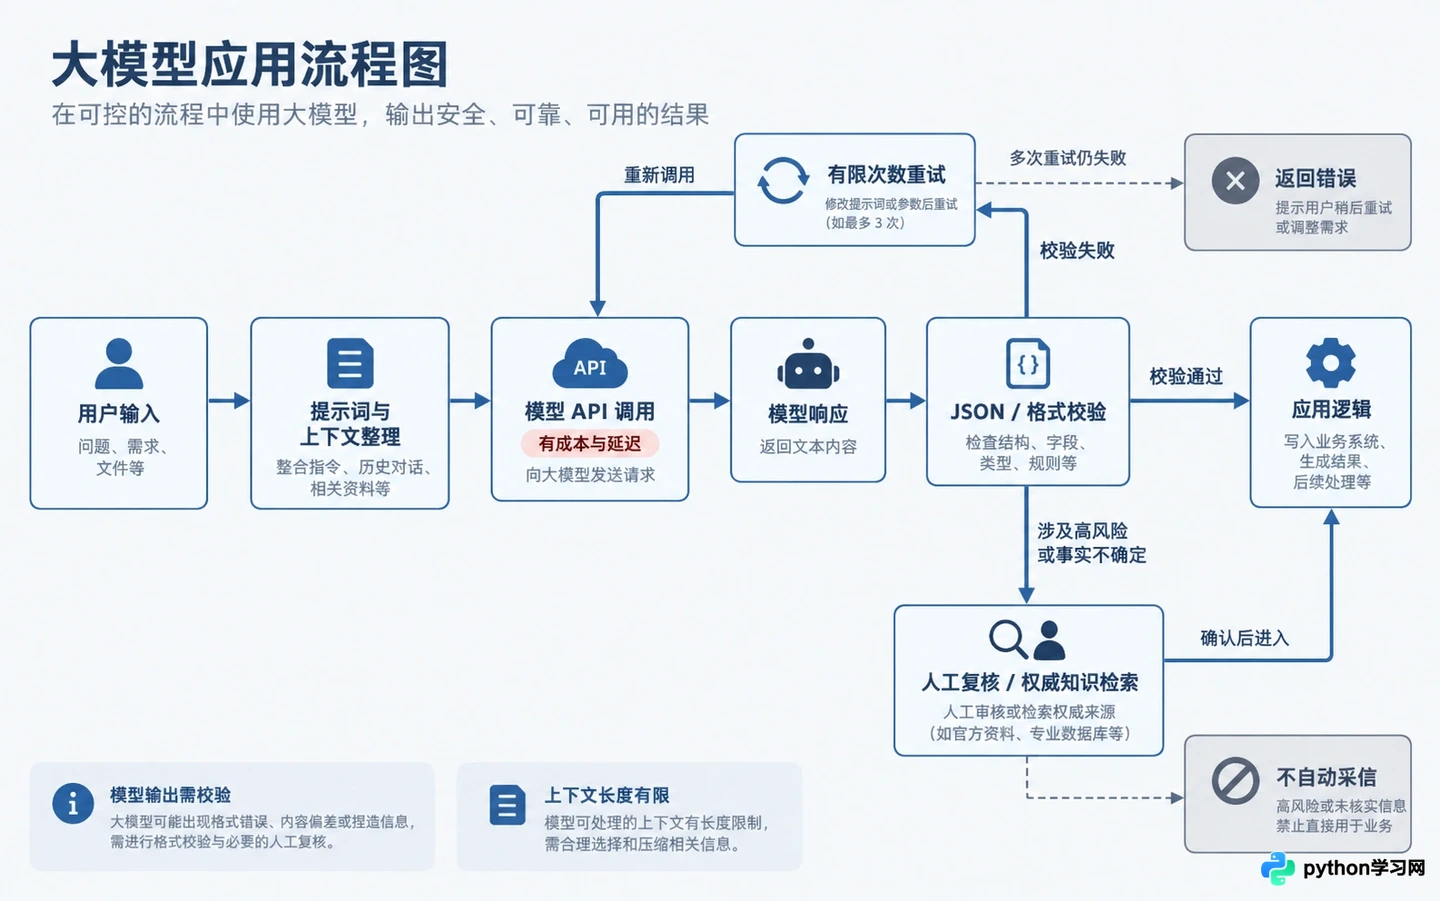
应用开发中的边界与校验流程
其次,API调用是有成本和延迟的。每一次对话都消耗Token,复杂的逻辑链可能导致响应时间长达数秒。在设计用户体验时,需要考虑异步加载、流式输出(Streaming)等技术手段,避免用户因等待而产生焦虑。
最后,上下文窗口是有限的。虽然现代模型支持数万甚至数十万的Token,但随着对话轮次增加,早期的信息可能会被遗忘或稀释。有效的应用开发需要设计合理的上下文管理策略,例如定期总结历史对话、滑动窗口机制等。
大模型应用开发不再是少数人的特权,而是一种新的编程范式。它要求开发者从“编写逻辑”转向“设计约束”,从“控制流程”转向“引导概率”。通过掌握API调用、提示词设计和结构化输出这三项基本技能,你已经具备了构建智能应用的基石。接下来的路,取决于你如何将这种能力嵌入到具体的业务痛点之中,而不是仅仅停留在聊天机器人的层面。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









