

LangChain、AutoGen等主流AI智能体开发框架盘点

构建AI智能体(AI Agent)不再是单纯调用大模型API,而是需要一套能够管理记忆、规划任务并调用工具的基础设施。对于开发者而言,直接在底层拼接Prompt和逻辑不仅维护成本高,且难以扩展。使用成熟的开发框架可以将复杂的交互逻辑封装为标准组件,让开发者专注于业务流的设计而非底层通信协议。
目前市面上主流的框架各有侧重:有的擅长单链路的复杂推理,有的专精于多智能体的自主协商。理解它们的核心差异,是构建稳定智能体应用的第一步。
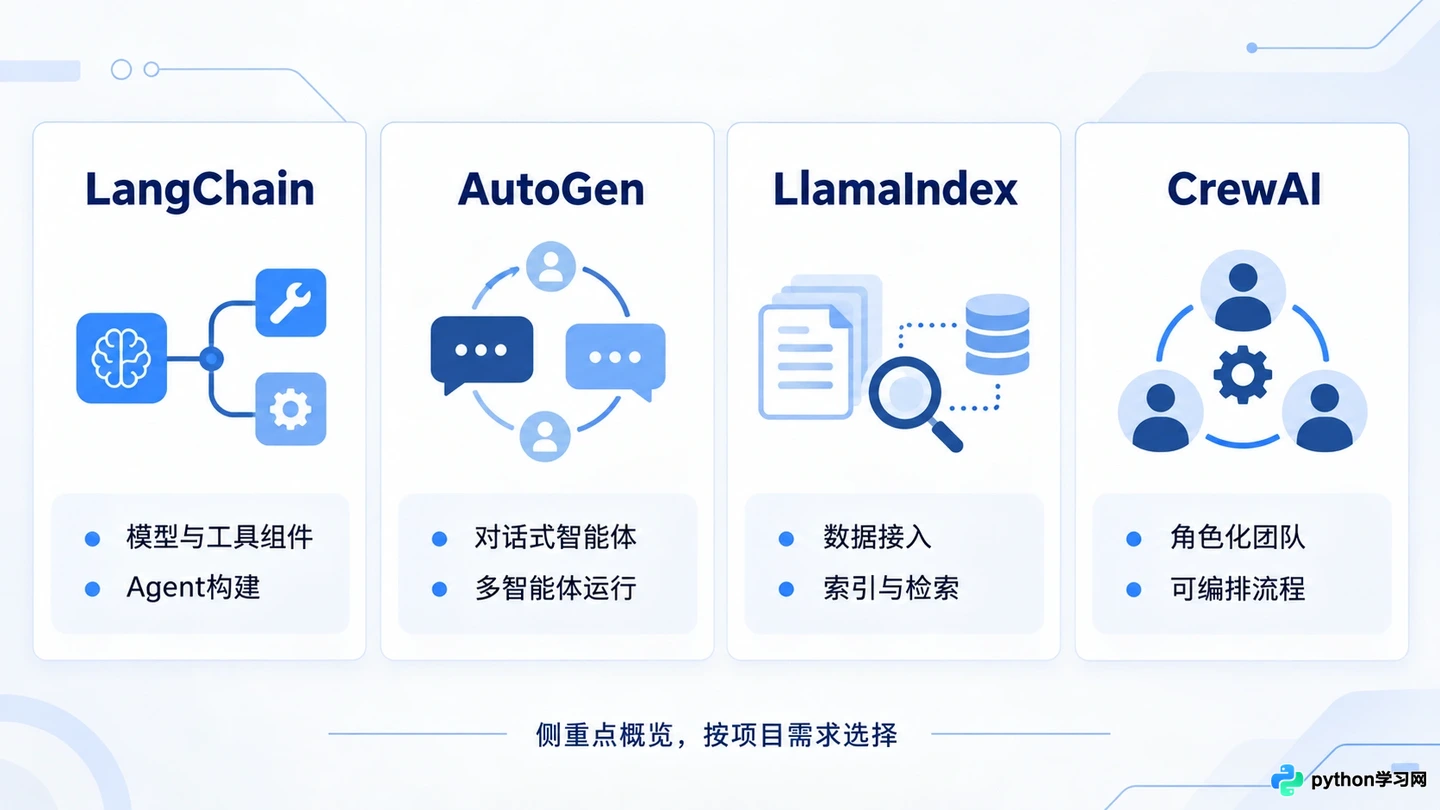
主流AI智能体框架的核心定位对比
1. LangChain:模块化组装的标准件
LangChain 是目前生态最丰富的框架,其核心理念是将大模型应用拆解为“链”(Chains)。它提供了标准化的接口来连接模型、提示词模板、输出解析器和外部数据源。
在 LangChain 中,构建一个智能体的基本单元是 Agent 和 Tool。开发者定义好工具函数后,LangChain 会自动根据用户输入决定调用哪个工具。这种模式适合处理需要多次调用外部API或数据库的单线程任务。
以下是一个使用 LangChain 创建简单代理的示例,它可以根据问题选择使用搜索工具或计算器:
from langchain.agents import initialize_agent, Tool
from langchain.llms import OpenAI

# 定义简单的工具
def search_func(query):
    return f"搜索结果: {query}"

def calculator_func(expression):
    return eval(expression)

# 注册工具
tools = [
    Tool(
        name="Search",
        func=search_func,
        description="用于回答事实性问题"
    ),
    Tool(
        name="Calculator",
        func=calculator_func,
        description="用于数学计算"
    )
]

# 初始化代理
llm = OpenAI(temperature=0)
agent = initialize_agent(tools, llm, agent_type="zero-shot-react-description")

# 运行
result = agent.run("今天北京天气如何?另外计算一下25乘以4的结果。")
print(result)
这段代码展示了 LangChain 的典型工作流:定义工具 -> 初始化LLM -> 创建Agent -> 执行。它的优势在于组件极其丰富,几乎可以连接任何第三方服务,但缺点是随着链路变长,调试难度会显著增加。
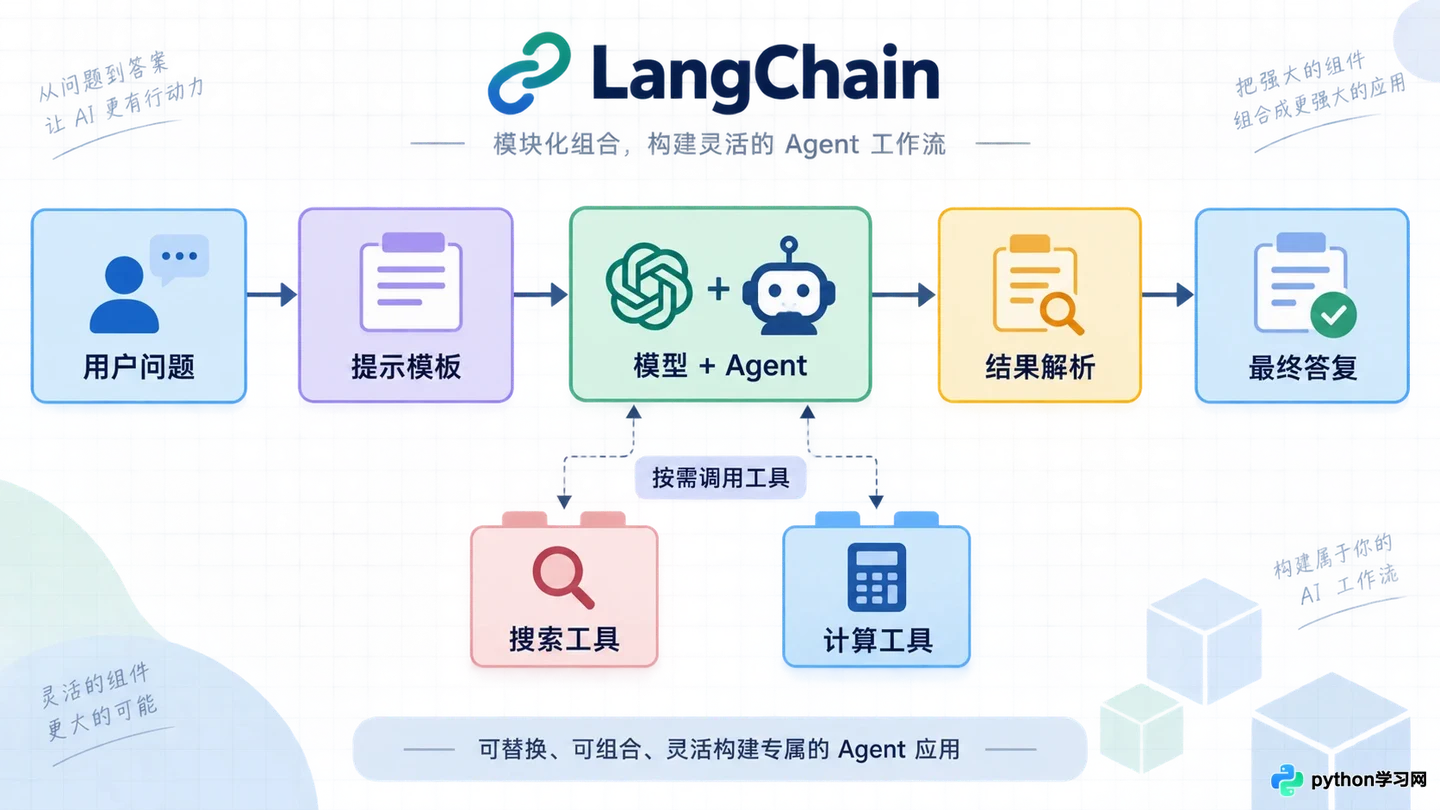
1. LangChain:模块化组装的标准件
2. AutoGen:多智能体对话的协作网
与 LangChain 的“中心化控制”不同,Microsoft 推出的 AutoGen 强调“去中心化”的多智能体协作。在 AutoGen 中,你可以创建多个具有不同角色的智能体(如程序员、产品经理、测试员),让它们通过对话自动解决复杂问题。
AutoGen 的核心概念是 ConversableAgent。智能体之间可以互相发送消息,并根据预设的代码执行环境自动运行生成的代码。这使得它在处理需要代码生成、执行和验证的任务时表现卓越。
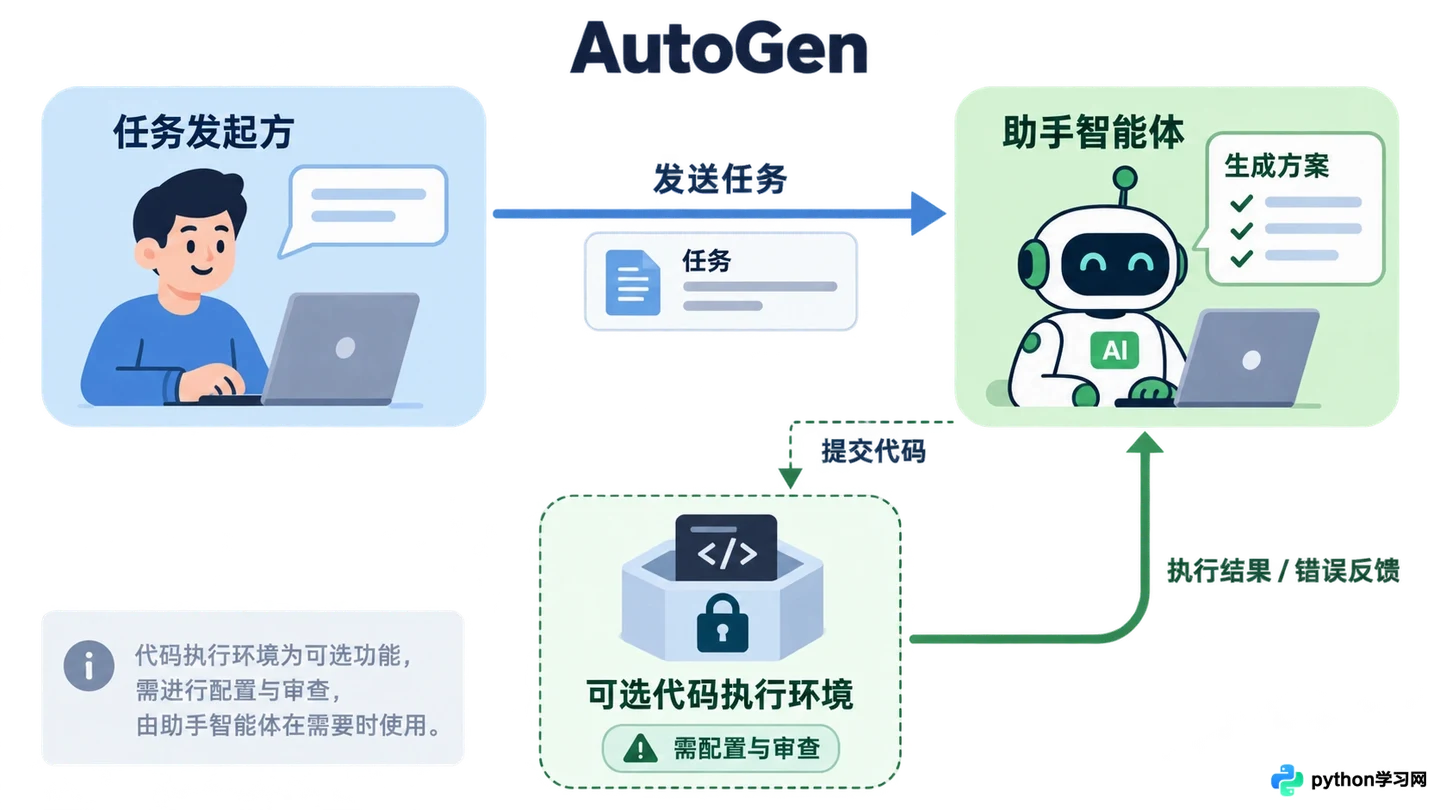
AutoGen中用户代理与助手代理的交互循环
下面展示如何配置两个智能体进行协作,其中一个负责写代码,另一个负责执行和反馈:
import autogen

config_list = [
    {
        'model': 'gpt-4',
        'api_key': 'your-api-key'
    }
]

# 创建用户代理(通常用于发起任务)
user_proxy = autogen.UserProxyAgent(
   name="UserProxy",
   code_execution_config={"work_dir": "coding"},
   human_input_mode="TERMINATE"
)

# 创建助手代理(负责生成代码)
code_assistant = autogen.AssistantAgent(
    name="CodeAssistant",
    llm_config={"config_list": config_list}
)

# 启动对话
user_proxy.initiate_chat(
    code_assistant,
    message="请绘制一个正弦波图像并保存为png文件。"
)
在上述流程中,CodeAssistant 会生成 Python 代码,UserProxy 会在本地沙箱中执行该代码并将结果返回给助手。如果出错,助手会根据错误信息重新生成代码,直到任务完成。这种闭环反馈机制是 AutoGen 区别于其他框架的最大特点。
3. LlamaIndex:数据索引与检索的专家
如果你的智能体主要任务是回答基于私有文档的问题,那么 LlamaIndex 是比 LangChain 更垂直的选择。它最初名为 GPT Index,专注于解决大模型与私有数据之间的连接问题。
LlamaIndex 提供了强大的数据加载器、索引结构和查询引擎。它不仅仅是一个检索增强生成(RAG)库,更是一个数据框架,能够高效地处理非结构化数据并将其转化为大模型可理解的上下文。
使用 LlamaIndex 构建问答智能体的过程非常直观:
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

# 加载数据
documents = SimpleDirectoryReader('data').load_data()

# 构建索引
index = VectorStoreIndex.from_documents(documents)

# 创建查询引擎
query_engine = index.as_query_engine()

# 执行查询
response = query_engine.query("公司去年的财务报表重点是什么?")
print(response)
LlamaIndex 的优势在于其对数据结构的精细控制。你可以选择不同的索引策略(如树状索引、关键词表索引)来优化检索精度。对于需要高精度知识检索的智能体,它是首选的基础设施。
4. CrewAI:角色扮演的流程编排
CrewAI 是一个较新的框架,它结合了 LangChain 的灵活性和 AutoGen 的多智能体理念,但更注重“流程”和“角色”的定义。它允许开发者以声明式的方式定义智能体的角色、目标、背景故事以及任务依赖关系。
在 CrewAI 中,核心概念是 Crew(团队)、Agent(成员)和 Task(任务)。这种结构非常适合模拟真实世界的工作流,例如市场调研、内容创作流水线等。
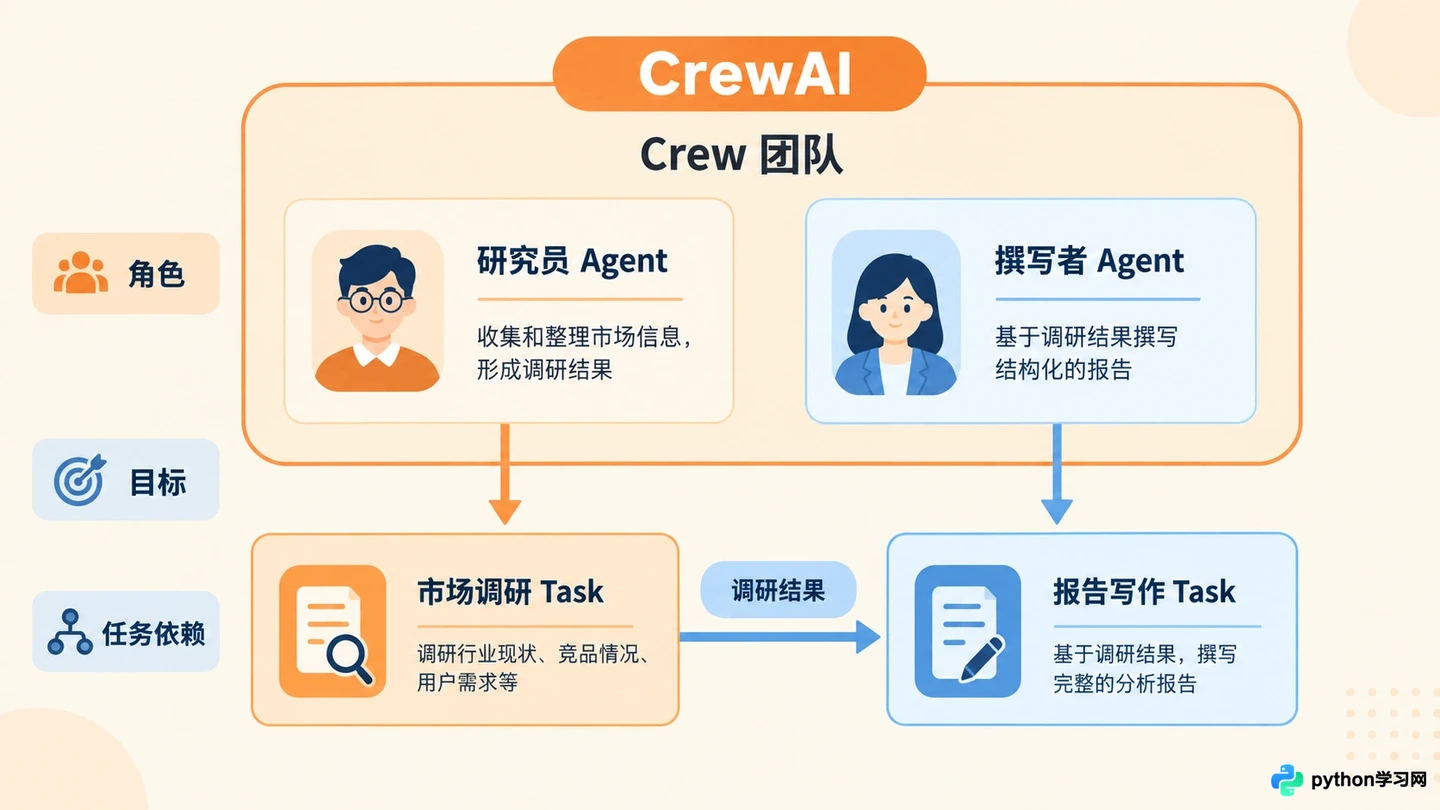
CrewAI中Agent角色定义与任务分配结构
以下是一个定义市场调研团队的示例:
from crewai import Agent, Task, Crew

# 定义角色
researcher = Agent(
  role='高级研究员',
  goal='挖掘最新的市场趋势',
  backstory='你是一位拥有10年经验的市场分析师,擅长从杂乱数据中发现规律。',
  verbose=True
)

writer = Agent(
  role='内容撰写专家',
  goal='撰写引人入胜的市场报告',
  backstory='你擅长将复杂的数据转化为通俗易懂的文章。',
  verbose=True
)

# 定义任务
task1 = Task(
  description='调研人工智能在教育领域的应用现状',
  agent=researcher
)

task2 = Task(
  description='根据调研结果写一篇博客文章',
  agent=writer
)

# 组建团队并执行
crew = Crew(
  agents=[researcher, writer],
  tasks=[task1, task2],
  verbose=2
)

result = crew.kickoff()
CrewAI 的代码可读性极高,它将业务逻辑从代码实现中剥离出来,使得非技术人员也能参与智能体流程的设计。它支持顺序执行和层级执行两种模式,能够灵活应对不同的业务需求。
5. 框架选型的关键判断
在实际项目中,往往不需要局限于单一框架。LangChain 可以作为底层的工具调用层,LlamaIndex 负责数据处理,而 AutoGen 或 CrewAI 负责上层的任务编排。
如果只是构建一个简单的问答机器人或单步工具调用应用,LangChain 或 LlamaIndex 足够轻量且社区支持最好。如果任务涉及复杂的代码生成、自我修正或多角色辩论,AutoGen 的异步对话机制更具优势。而对于需要严格遵循业务流程、强调角色分工的企业级应用,CrewAI 的结构化设计能降低维护成本。
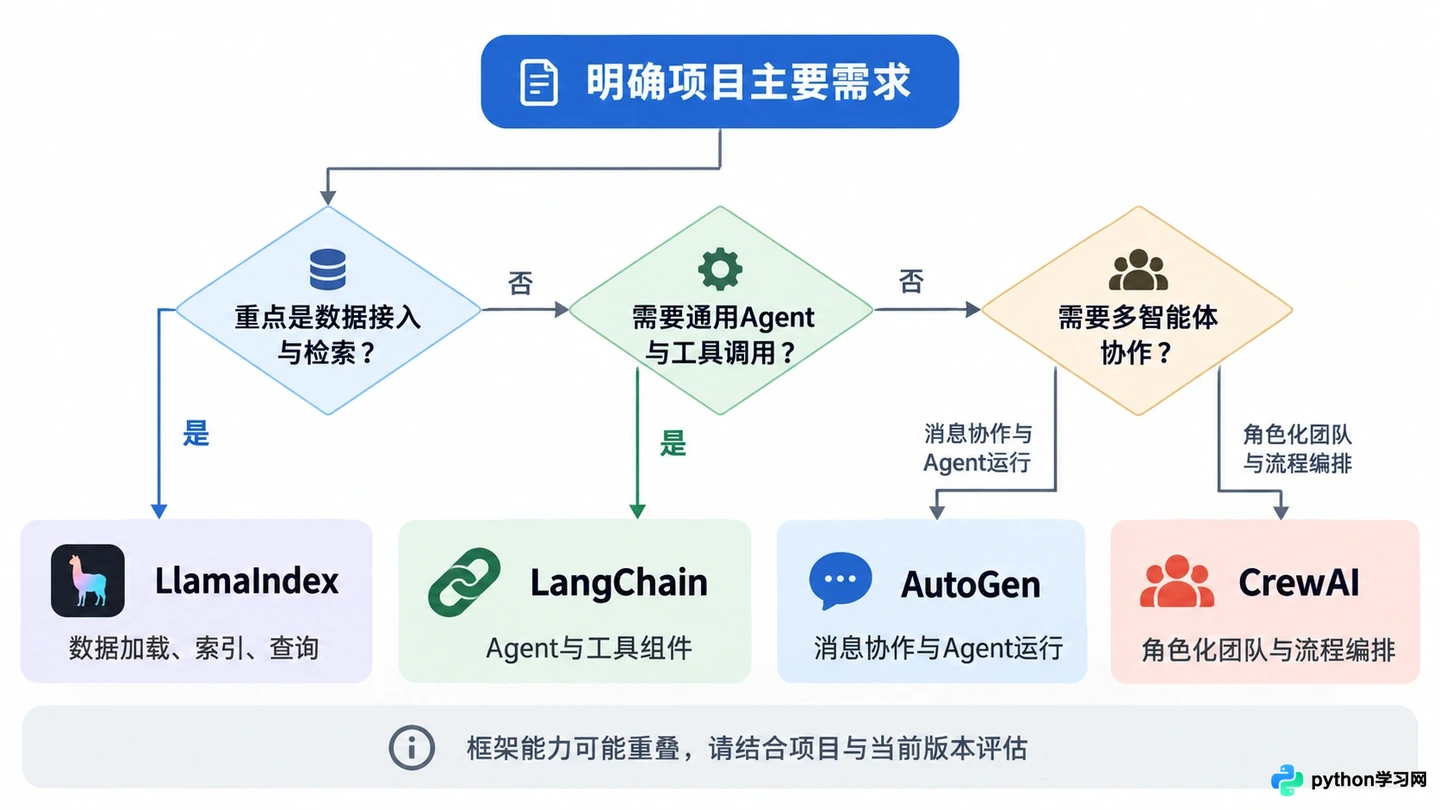
根据项目需求选择合适框架的决策路径
最终的选择应取决于你的智能体是需要“思考”(推理规划)还是“协作”(多角色互动)。建议先从最小可行性产品(MVP)入手,使用 LangChain 快速验证工具调用的可行性,再根据复杂度决定是否引入多智能体协作框架。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









