

Python LangChain框架中大模型组件的初始化配置指南

在大语言模型(LLM)驱动的应用开发中,大模型组件是整个交互链条的计算大脑与输入输出枢纽。在 Python LangChain 体系下,正确完成模型组件的初始化配置,不仅关乎 API 密钥的安全与接口连通,还直接决定了模型的推理温度、流式输出、请求超时与异常重试等核心运行时表现。本文将围绕 LangChain 的官方推荐架构,详细讲解大模型组件的核心抽象、环境准备、基础与进阶参数调优,以及多提供商组件初始化的标准实践与排错方法。
一、LangChain 大模型组件的抽象架构
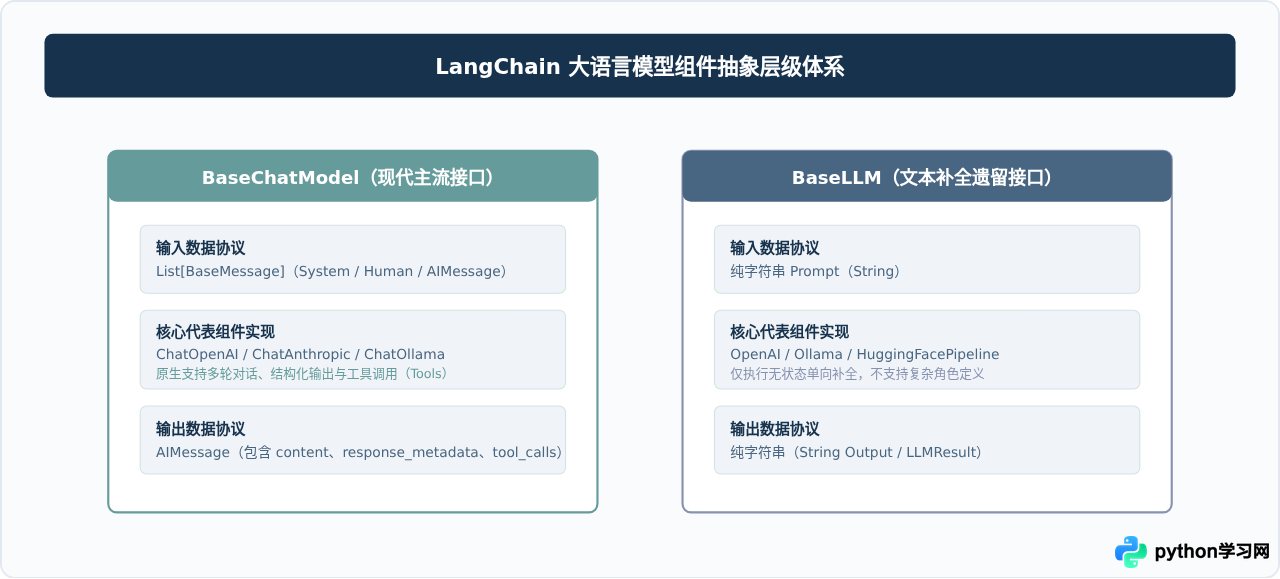
在开始编写代码前,需要明确 LangChain 对大语言模型的两层基本抽象:BaseLLM 与 BaseChatModel。虽然二者均继承自统一的基类 BaseLanguageModel,但在现代应用中,两者的定位与输入输出协议有着根本区别:
- BaseLLM(纯文本补全模型):接收纯字符串(String Prompt)作为输入,返回纯字符串补全结果。主要用于早期 GPT-3 阶段的纯补全接口,在当前以对话为核心的开发场景中已逐步过渡为遗留接口。
- BaseChatModel(对话消息模型):接收结构化消息列表(List of
BaseMessage,如SystemMessage、HumanMessage、AIMessage)作为输入,返回封装了回复文本与元数据(Token 消耗、终止原因等)的AIMessage。这是当前 LangChain 生态中最核心、最常用的组件类型。
二、环境准备与配置流水线
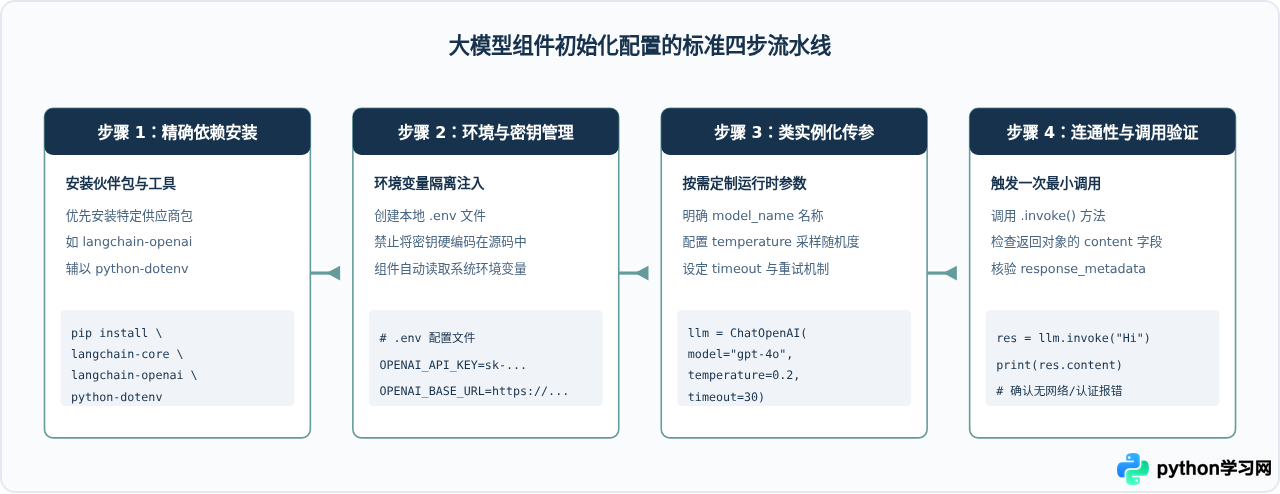
自 LangChain 0.1/0.2 版本后,官方采用了模块化解耦架构:核心逻辑由 langchain-core 提供,而各个模型厂商的接入逻辑被拆分到专属的伙伴包中(如 langchain-openai、langchain-anthropic 等)。这种架构大幅精简了依赖体积,并提高了各厂商新特性的发布速度。
1. 依赖安装
执行以下命令安装基础组件与 OpenAI 专用伙伴包:
# 核心包与专用厂商包安装
pip install langchain-core langchain-openai python-dotenv
2. 环境变量隔离(推荐做法)
LangChain 的大模型类在初始化时,会自动检测标准命名的环境变量(如 OPENAI_API_KEY、OPENAI_BASE_URL、ANTHROPIC_API_KEY 等)。如果在实例化对象时没有显式传入密钥,组件将回退到读取系统环境变量。
在项目根目录下创建 .env 文件:
# .env 文件配置
OPENAI_API_KEY=sk-proj-xxxxxxxxxxxxxxxxxxxxxxxx
# 如果使用第三方合规代理或网关,需配置 BASE_URL;官方直连可省略此项
OPENAI_BASE_URL=https://api.openai.com/v1api_key="..." 字符串中。将 .env 文件加入 .gitignore,并在应用启动入口通过 python-dotenv 载入,是业界通用的安全工程准则。
三、核心初始化参数深度剖析
在调用大模型构造函数时,开发者通常需要根据业务场景调整配置。这些参数直接影响底层 HTTP 请求的 Payload 构建与连接池行为。
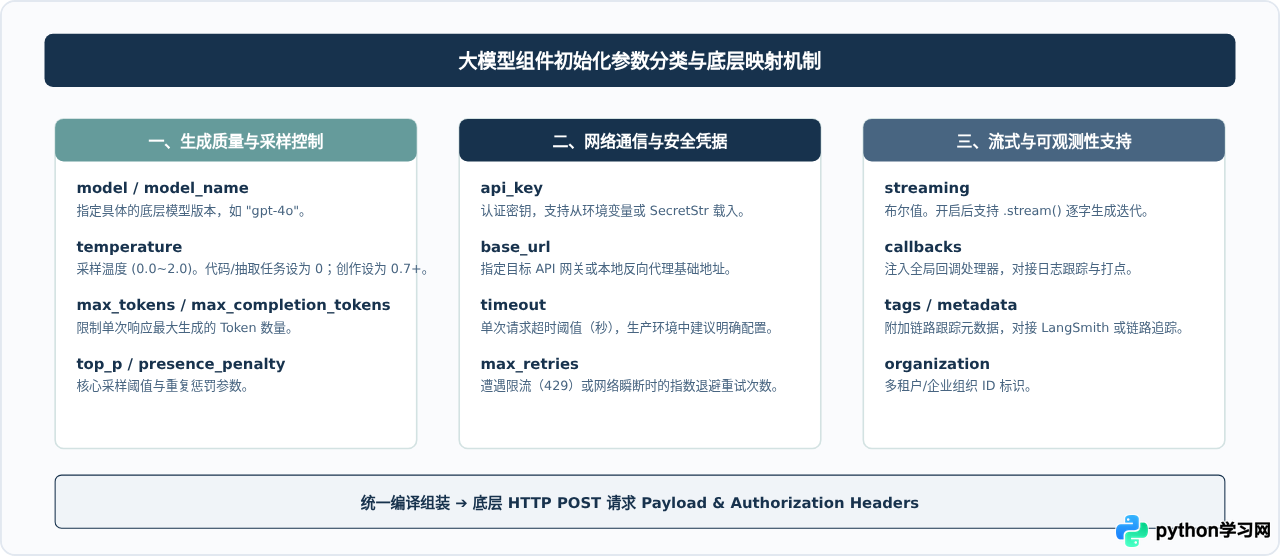
以下是具备生产健壮性的参数初始化标准代码:
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.messages import HumanMessage, SystemMessage

# 1. 加载本地 .env 文件中的环境变量
load_dotenv()

# 2. 规范初始化 ChatOpenAI 组件
chat_model = ChatOpenAI(
    model="gpt-4o",                # 目标模型名称
    temperature=0.2,               # 确定性较高、兼顾表达自然
    max_tokens=2048,               # 限制单次回复上限
    timeout=30.0,                  # 超时截断,避免连接池假死
    max_retries=3,                 # 遇到 429 或连接闪断时自动重试 3 次
    streaming=True                 # 启用流式传输支持
)

# 3. 构造消息并执行调用
messages = [
    SystemMessage(content="你是一名专业的 Python 技术顾问。"),
    HumanMessage(content="请用两句话解释 LangChain 中 ChatModel 的作用。")
]

response = chat_model.invoke(messages)
print(response.content)
四、主流模型提供商的初始化实操
除标准 OpenAI 直连外,在企业落地中经常会遇到自建网关代理、本地私有化大模型或 Anthropic 等多样化的接入需求。以下逐一展示对应配置方案:
1. 自定义网关代理或第三方中转服务
很多企业会在内网部署 API 统一网关,或者通过第三方中转商进行统一计费。此时只需在初始化时覆盖 base_url 即可,其余代码无需任何改动:
from langchain_openai import ChatOpenAI

# 指向企业内部网关代理
proxy_model = ChatOpenAI(
    model="gpt-4o-mini",
    api_key="your-custom-key-or-token",
    base_url="https://api.internal-gateway.com/v1",  # 注意路径末尾的 /v1
    temperature=0.1
)
2. 本地私有化模型(Ollama / vLLM)
在离线或对数据隐私要求严格的场景下,本地部署的开源模型(如 Qwen、Llama 等)是常见选择。针对 Ollama,LangChain 提供了专门的 ChatOllama:
# 依赖安装:pip install langchain-community
from langchain_community.chat_models import ChatOllama

# 初始化本地 Ollama 实例(无需 API 密钥)
local_model = ChatOllama(
    model="qwen2.5:7b",
    base_url="http://localhost:11434",
    temperature=0.3
)

local_res = local_model.invoke("你好,请简要介绍你自己。")
print(local_res.content)
如果本地服务是通过 vLLM 等工具以兼容 OpenAI API 规范暴露的 HTTP 接口,则可以直接复用 ChatOpenAI 类,将 base_url 设置为本地地址,并传入虚拟的 api_key="none" 即可。
五、初始化常见故障排查与决策总结
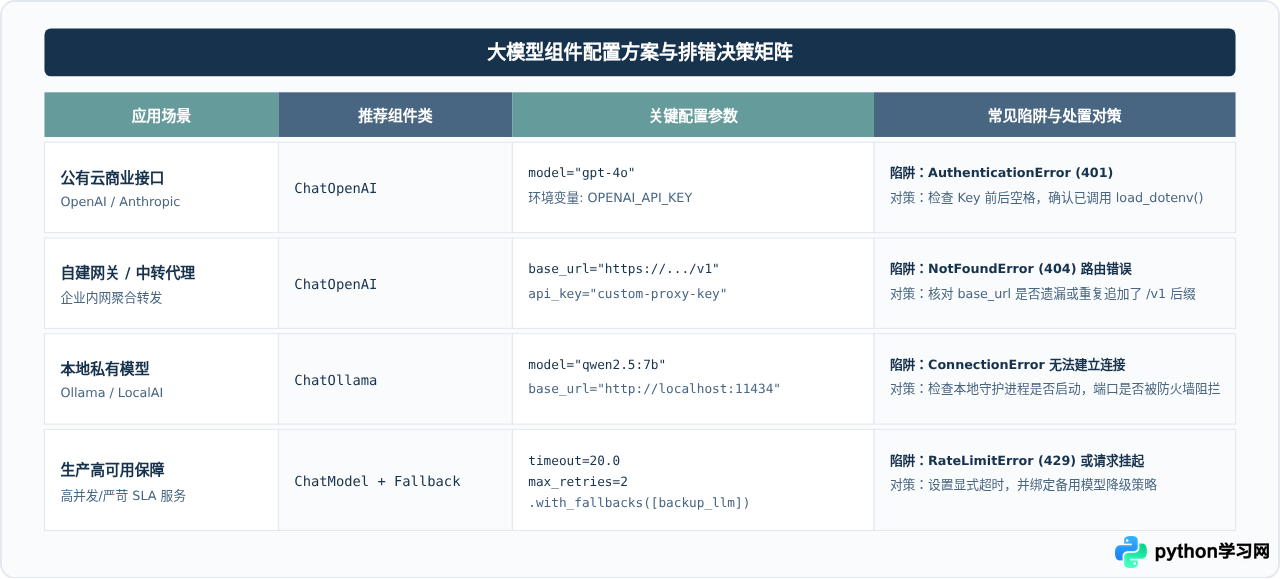
在初始化大模型组件时,开发者经常会遇到各类运行时报错。理解这些问题的本质原因,有助于快速定位修复。
常见排错细节说明
- BaseURL 重复拼接
/v1导致 404:不同厂商或中转平台的网关路由规则不同。如果所使用的库在内部请求时会自动追加/chat/completions,而提供的base_url已经带有或缺少/v1,容易拼出/v1/v1/...。当遇到 404 错误时,优先检查 HTTP 请求日志中的完整拼接 URL。 - 连接长时间挂起(Hang 住):默认情况下,若未指定
timeout,某些异常网络状态可能导致客户端线程长时间阻塞。生产环境必须显式传入timeout=30.0(单位秒),确保故障能在规定时间内触发熔断或重试。 - 多模型降级容灾配置:为了防止主模型提供商服务宕机,推荐使用 LangChain 提供的
.with_fallbacks()机制:# 容灾备用配置示例 primary_llm = ChatOpenAI(model="gpt-4o", timeout=15) backup_llm = ChatOpenAI(model="gpt-4o-mini", timeout=15) # 当主模型发生超时或错误时,自动尝试备用模型 reliable_llm = primary_llm.with_fallbacks([backup_llm])
通过清晰划分环境依赖、遵循环境变量隔离原则、严谨配置运行时参数并结合降级容灾机制,开发者即可在 Python LangChain 中构建出稳定、安全且易于维护的大模型应用底层接入层。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









