

Python实现大模型流式输出(Stream)的配置方法
详细介绍在Python中实现大语言模型流式输出(Stream)的配置方法与原理,涵盖参数设置、分块迭代读取、输出缓冲区刷新、异步流式处理及常见问题排查。
在调用大语言模型(LLM)API 时,流式输出(Stream)是一种让模型在生成 Token 的同时实时向客户端传送数据的技术方案。通过在请求中配置 stream=True 并配合 Python 的迭代器与标准输出刷新,可以让读者或终端用户无需等待全文生成即可逐字阅读响应内容,从而将首字等待时间(TTFT,Time To First Token)从数秒甚至数十秒压缩至几百毫秒。本文直接以 Python 为实现语言,讲解大模型流式输出的底层机制、核心代码配置、无缓冲渲染及异常与 Token 统计的规范处理方式。
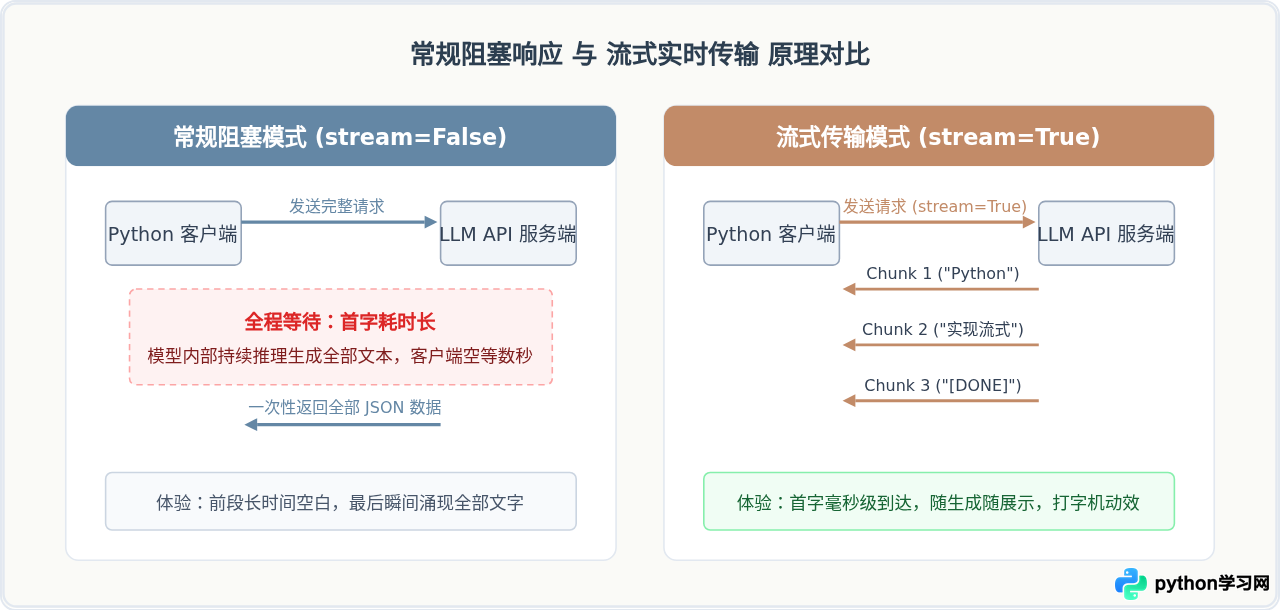
一、非流式阻塞响应与流式传输的机制差异
理解流式输出的前提是认识大模型生成文本的自回归特性。大模型是一次生成一个或少量 Token。在传统的阻塞式(非流式)请求中,服务端必须等待模型将全部回答生成完毕后,打包成一个完整的 JSON 响应体统一返回给客户端。在此期间,Python 客户端一直处于网络阻塞等待状态;如果回答内容长达上千字,用户界面就会出现明显的停滞或白屏现象。
流式输出则依托于 Server-Sent Events(SSE)或 HTTP 分块传输编码(Chunked Transfer Encoding)协议。当 Python 发起带有 stream=True 参数的请求时,服务端会建立一条单向持久连接。每当模型生成一段增量文本片段(Chunk),服务端便立即以事件流的形式推送到客户端。Python 端接收到该数据包后,直接将其解析并输出,形成如打字机般的连续输出效果。
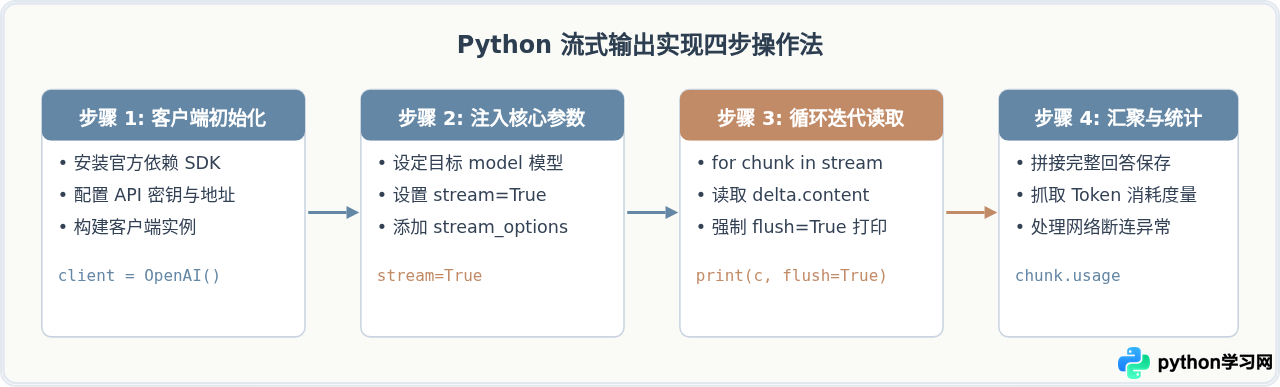
二、Python 实现流式输出的操作步骤流程
在 Python 中实现流式输出需要经历四个关键技术环节:环境准备与客户端实例化、请求参数流式启用、生成器分块迭代与无缓冲打印、以及连接收尾与异常保护。只要严格按照这套步骤组织代码,就能在终端或 Web 后端中稳定接入流式交互。
1. 安装环境依赖
目前业界绝大多数国产及开源大模型(如通义千问、DeepSeek、智谱 GLM、月之暗面等)均提供与 OpenAI 规范完全兼容的 API 接口。因此推荐使用官方维护的 openai Python 库进行调用:
pip install --upgrade openai2. 核心调用示例代码
下面的代码展示了在 Python 中配置流式输出的完整标准写法。请重点注意 stream=True 和 print(..., end="", flush=True) 的配合使用:
import os
from openai import OpenAI

# 1. 初始化客户端(读取环境变量或传入参数)
client = OpenAI(
    api_key=os.environ.get("OPENAI_API_KEY", "your-api-key-here"),
    base_url=os.environ.get("OPENAI_BASE_URL", "https://api.openai.com/v1"),
)

def chat_with_stream(prompt: str):
    try:
        # 2. 发起请求并开启流式开关
        stream_response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[
                {"role": "system", "content": "你是一位耐心详尽的技术导师。"},
                {"role": "user", "content": prompt}
            ],
            stream=True,  # 核心开关:设置为 True 开启流式响应
            stream_options={"include_usage": True}  # 在流末尾包含 Token 消耗信息
        )

        full_content_list = []
        token_usage = None

        print("AI 回复: ", end="", flush=True)

        # 3. 遍历生成器,按分块获取数据
        for chunk in stream_response:
            # 捕获末尾附带的 token 统计
            if hasattr(chunk, "usage") and chunk.usage is not None:
                token_usage = chunk.usage

            # 校验并提取当前 chunk 中的文本增量
            if chunk.choices and len(chunk.choices) > 0:
                delta = chunk.choices[0].delta
                content = delta.content
                if content:
                    # 关键操作:无换行输出并强制刷新缓冲区
                    print(content, end="", flush=True)
                    full_content_list.append(content)

        print("\n")  # 全部输出完毕后补打换行

        # 4. 如需将完整结果存库或后续逻辑使用,进行拼接
        complete_reply = "".join(full_content_list)
        if token_usage:
            print(f"[消耗统计] 提示词: {token_usage.prompt_tokens}, 补全: {token_usage.completion_tokens}, 总计: {token_usage.total_tokens}")

        return complete_reply

    except Exception as e:
        print(f"\n[请求异常]: {e}")
        return None

if __name__ == "__main__":
    chat_with_stream("请用三句话解释Python装饰器的作用机制。")
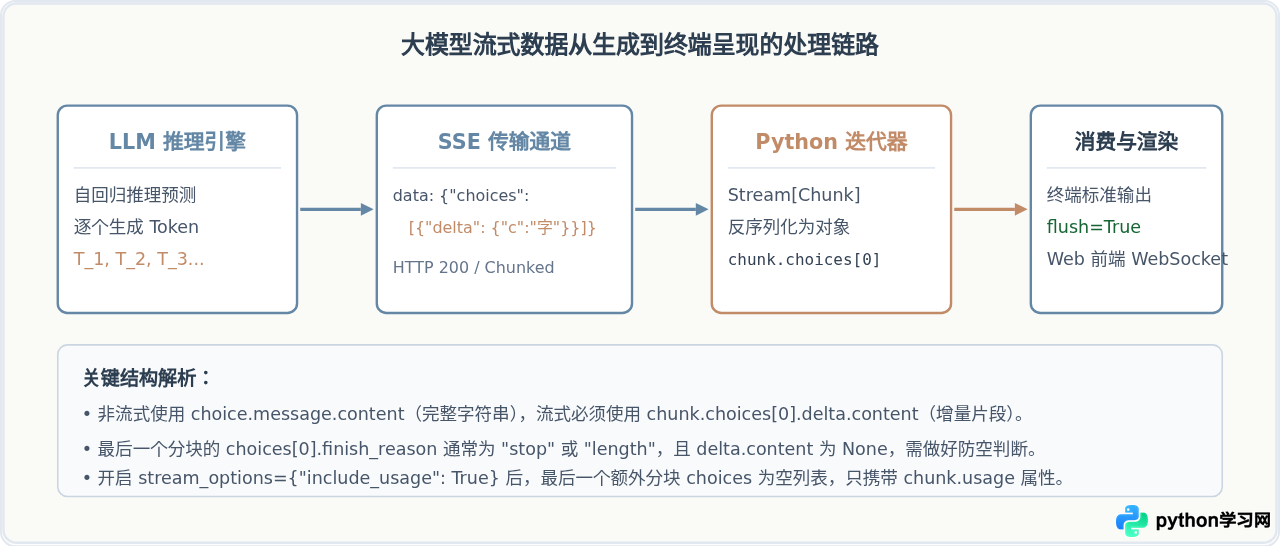
三、流式传输数据链路与内部数据结构剖析
很多开发者在初次编写流式代码时,容易混淆返回对象的实际形态。当 stream=False 时,client.chat.completions.create() 返回的是一个完整的 ChatCompletion 对象;而当 stream=True 时,返回的是一个 Python 生成器(Stream[ChatCompletionChunk])。
四、进阶场景:异步流式与原生 HTTP 消费
1. 异步编程架构(AsyncOpenAI)
在 FastAPI、Tornado 等高性能异步 Web 框架中,使用同步阻塞的 for chunk in response: 会导致 Python 的事件循环被长时间挂起。正确的做法是使用 AsyncOpenAI 客户端搭配 async for 语法进行非阻塞迭代:
import asyncio
import os
from openai import AsyncOpenAI

async def async_stream_demo():
    client = AsyncOpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

    stream = await client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": "请用Python写一个二分查找函数。"}],
        stream=True,
    )

    # 异步逐块读取,释放事件循环给其他并发协程
    async for chunk in stream:
        if chunk.choices:
            text = chunk.choices[0].delta.content or ""
            if text:
                print(text, end="", flush=True)

if __name__ == "__main__":
    asyncio.run(async_stream_demo())
2. 原生 requests / httpx 实现(无 SDK 依赖)
如果因内网环境限制无法安装 openai SDK,可以使用标准 requests 库解析底层的 SSE 数据流。核心是在请求时传入 stream=True,并通过 iter_lines() 逐行过滤 data: 前缀:
import json
import os
import requests

url = "https://api.openai.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer {os.environ.get('OPENAI_API_KEY')}",
    "Content-Type": "application/json",
}
payload = {
    "model": "gpt-4o-mini",
    "messages": [{"role": "user", "content": "你好"}],
    "stream": True,
}

# 关键:requests.post 中必须声明 stream=True
with requests.post(url, headers=headers, json=payload, stream=True) as resp:
    for raw_line in resp.iter_lines(decode_unicode=True):
        if not raw_line:
            continue
        # SSE 规范以 "data: " 作为消息行开头
        if raw_line.startswith("data: "):
            data_body = raw_line[6:].strip()
            if data_body == "[DONE]":
                break  # 服务端宣告传输终结
            try:
                chunk_json = json.loads(data_body)
                choices = chunk_json.get("choices", [])
                if choices:
                    content = choices[0].get("delta", {}).get("content", "")
                    if content:
                        print(content, end="", flush=True)
            except json.JSONDecodeError:
                pass
五、流式输出配置的核心避坑指南与总结
在实际落地大模型流式输出时,往往会遇到以下典型陷阱:
- 文字成段喷发而非逐字显示:这是因为 Python 标准输出存在行缓冲(Line Buffering)。如果省略了
flush=True,解释器会等到缓冲区填满或检测到换行符时才一次性向屏幕刷出,导致流式效果失效。 - NoneType 报错与属性异常:最后一块或者包含工具调用(Tool Calls)的块中,
delta.content的值通常为None。切勿直接对delta.content调用字符串方法(如.strip()),必须使用delta.content or ""或显式判空。 - Token 统计丢失问题:早期 OpenAI 规范中流式响应不返回
usage计数。务必在创建请求时显式添加stream_options={"include_usage": True},并在循环体最后检查独立的 usage 消息块。
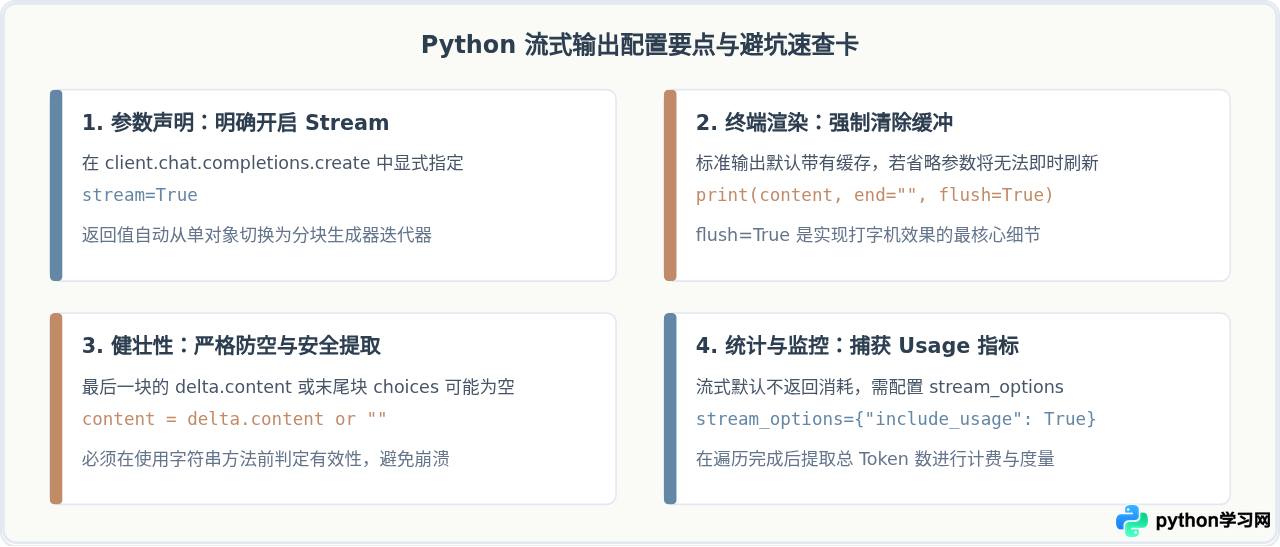
stream=True 开关、安全提取 delta.content,并配合 flush=True 释放输出缓冲区,即可构建出响应敏捷、体验流畅的大模型交互应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









