

Python 100例进阶挑战:递归、排序等数据结构难题深度解析
深入解析Python进阶挑战中的核心难点,涵盖递归调用栈与记忆化优化、快速排序与归并排序分治机制、树与链表数据结构实战,提供完整可运行代码与等距图解。
很多初学者在完成基础语法的练习题后,遇到“Python 100例”后半部分的递归推导、复合排序以及链表与树结构题时,常常会陷入“看得懂题意,却写不出代码”或“递归一跑就栈溢出”的困境。基础阶段训练的是流程控制与内置类型的使用,而进阶挑战考察的是状态建模、内存调用栈认知以及算法的时空复杂度控制。本文直接聚焦递归、高效排序以及衍生数据结构中最具代表性的典型难题,通过拆解底层执行过程、代码实现与常见陷阱,帮助读者建立系统性的解题思维。
一、递归思维的核心:基准条件与系统调用栈
递归并不是一种神秘的语法技巧,其实质是函数自我调用并借助系统“执行栈”(Call Stack)来暂存计算上下文的过程。理解递归的关键不在于人脑去单步模拟每一层递归展开,而在于明确两个核心要素:基准条件(Base Case)与递推关系(Recursive Step)。如果基准条件缺失或条件永远无法触碰,程序就会无限压栈,最终触发 Python 的 RecursionError: maximum recursion depth exceeded 异常。
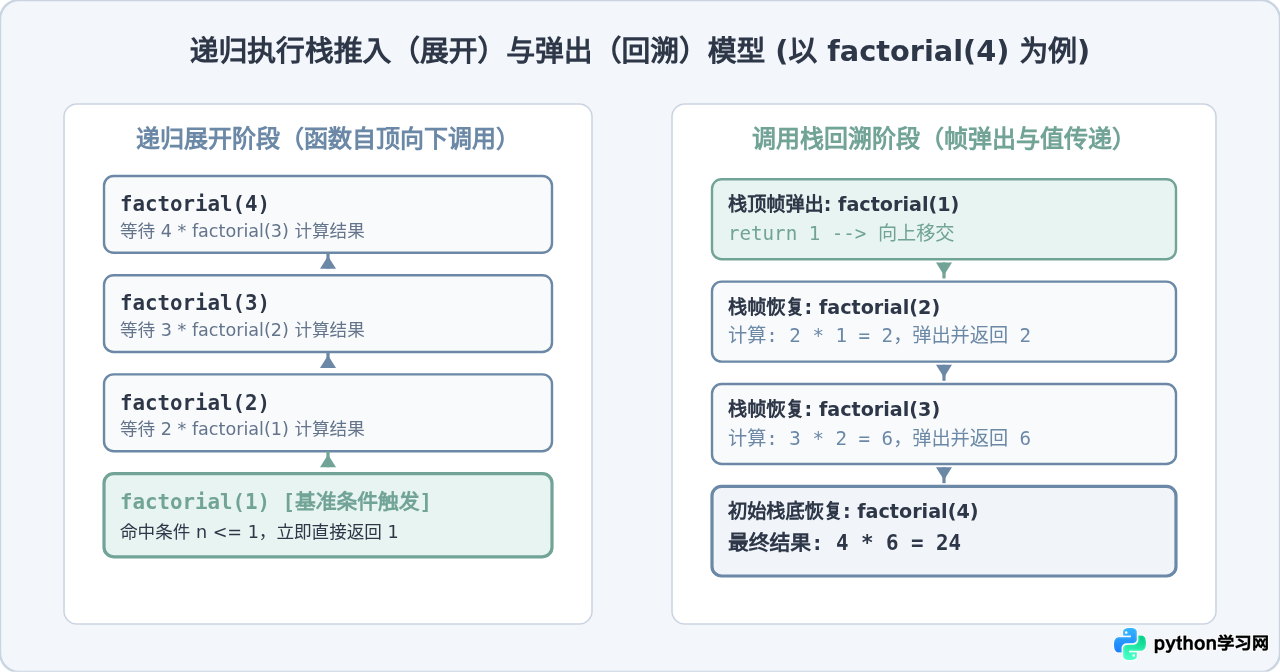
典型难题解析:汉诺塔(Tower of Hanoi)的步数与路径输出
在 Python 100例中,汉诺塔问题是检验是否真正掌握递归建模的试金石。问题要求将 n 个盘子从 A 柱借助 B 柱移动到 C 柱,且大盘永远不能压在小盘上方。
很多读者试图推算每一步具体应该怎么走,这是典型的迭代顺向思维,很容易在第 4 步后迷失方向。递归解法则从宏观视角审视目标:若要将最大的第 n 号盘移到目标柱 C,必须经历三个逻辑阶段:
- 将上面的
n - 1个盘子从 A 柱移动到暂存柱 B(借助 C 柱); - 将 A 柱底部的第
n号盘直接移动到 C 柱; - 将暂存在 B 柱上的
n - 1个盘子从 B 柱移动到 C 柱(借助 A 柱)。
编写出的实现代码结构精炼且逻辑对称:
def hanoi(n, source, target, auxiliary):
    """
    汉诺塔递归求解
    :param n: 当前需要移动的盘子数
    :param source: 起始柱
    :param target: 目标柱
    :param auxiliary: 辅助暂存柱
    """
    # 基准条件:只有一个盘子时,直接从起点移到目标柱
    if n == 1:
        print(f"步骤: 将盘 1 从 {source} 移动到 {target}")
        return

    # 阶段 1: 将上面的 n-1 个盘子移到辅助柱
    hanoi(n - 1, source, auxiliary, target)

    # 阶段 2: 将最大的第 n 号盘移到目标柱
    print(f"步骤: 将盘 {n} 从 {source} 移动到 {target}")

    # 阶段 3: 将辅助柱上的 n-1 个盘子移到目标柱
    hanoi(n - 1, auxiliary, target, source)

# 执行示例 (测试 n=3)
if __name__ == "__main__":
    print("--- 汉诺塔 3 盘移动步骤 ---")
hanoi(3, 'A', 'C', 'B')sys.getrecursionlimit() 查询)。在处理深度超过该阈值的递归问题时,除了使用 sys.setrecursionlimit() 临时提升外,更规范的做法是将递归改写为显式使用列表模拟栈的迭代解法,或者使用尾递归与循环转化。
二、高效排序进阶:从简单比较到分治架构
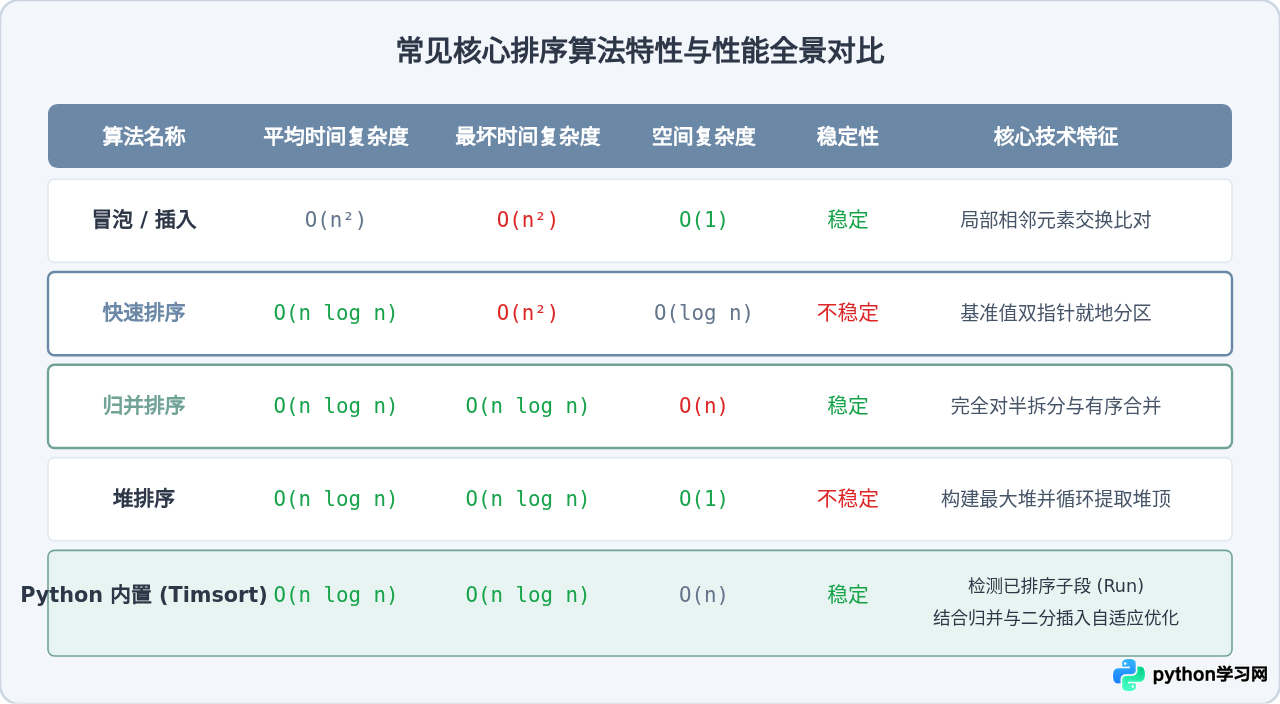
初学阶段接触的冒泡排序、选择排序和插入排序虽然容易理解,但在数据规模扩大时,其 $O(n^2)$ 的时间复杂度会导致耗时急剧上升。进阶挑战的重点是基于分治思想(Divide and Conquer)的高效排序:快速排序(QuickSort)与归并排序(MergeSort)。
1. 快速排序与就地双指针分区(In-Place Partition)
很多初学者在写 Python 快排时,喜欢用列表推导式写出类似 [x for x in arr if x < pivot] 的三行精简代码。虽然语法漂亮且容易记忆,但这破坏了快速排序的核心优势——就地分区(In-place Partition),每次递归都会额外开辟三个全新列表,导致空间复杂度退化为 $O(n)$ 甚至频繁触发垃圾回收。
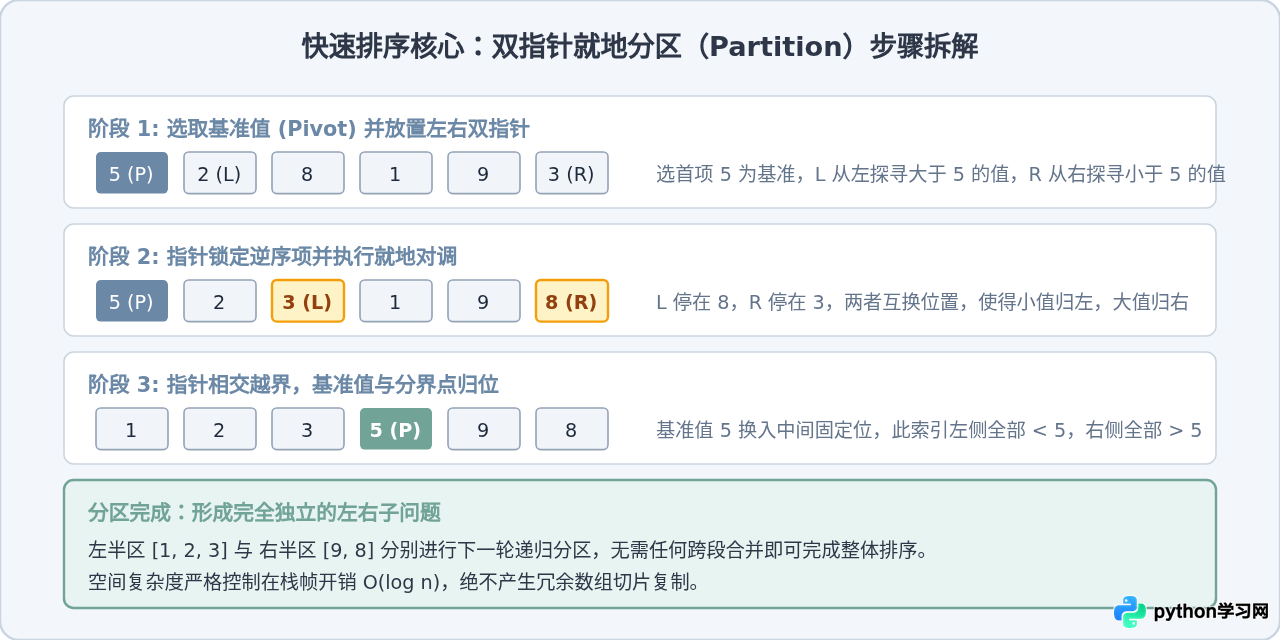
标准原地快速排序的工程化实现如下:
def quicksort_inplace(arr, low=0, high=None):
    """
    原地快速排序实现
    :param arr: 目标列表
    :param low: 排序起始索引
    :param high: 排序结束索引
    """
    if high is None:
        high = len(arr) - 1

    if low < high:
        # 获取分区后基准值的准确最终位置
        pivot_index = _partition(arr, low, high)
        # 对左右两侧子数组独立递归
        quicksort_inplace(arr, low, pivot_index - 1)
        quicksort_inplace(arr, pivot_index + 1, high)

def _partition(arr, low, high):
    pivot = arr[low]
    left = low + 1
    right = high

    while True:
        # 左指针向右推进,寻找大于 pivot 的项
        while left <= right and arr[left] <= pivot:
            left += 1
        # 右指针向左推进,寻找小于 pivot 的项
        while left <= right and arr[right] >= pivot:
            right -= 1

        if left <= right:
            arr[left], arr[right] = arr[right], arr[left]
        else:
            break

    # 将 pivot 放入交叉后的准确定位
    arr[low], arr[right] = arr[right], arr[low]
    return right

# 验证代码
if __name__ == "__main__":
    data = [29, 10, 14, 37, 14, 20, 7, 33]
    quicksort_inplace(data)
    print("排序结果:", data)
2. 归并排序的稳定性与分治合并
当排序要求具备稳定性(Stability)——即键值相同的元素在排序后的相对顺序保持不变时,快速排序便不再适用,归并排序是首选方案。归并排序无论数据初始顺序如何,均能保证严格的 $O(n \log n)$ 时间复杂度,其代价是合并有序段时需要 $O(n)$ 的辅助临时空间。
def mergesort(arr):
    """
    归并排序实现
    """
    if len(arr) <= 1:
        return arr

    mid = len(arr) // 2
    left_sorted = mergesort(arr[:mid])
    right_sorted = mergesort(arr[mid:])

    return _merge(left_sorted, right_sorted)

def _merge(left, right):
    result = []
    i = j = 0

    # 双指针同步遍历两个有序列表
    while i < len(left) and j < len(right):
        if left[i] <= right[j]:  # <= 保证相等元素的原始顺序不变(稳定性)
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1

    # 追加剩余元素
    result.extend(left[i:])
    result.extend(right[j:])
    return result
三、复合数据结构挑战:递归与树/图的结合
在 Python 100例的高难度题中,递归往往与树形结构或复杂图搜索结合出现。二叉树问题天然具有递归结构:一个二叉树的左子树和右子树本身依然是二叉树。处理这类问题的关键是定义好“每个节点要做的事情”,其余的交给递归展开。
经典难题:二叉树的最大深度与路径总和校验
以判断“是否存在根节点到叶子节点的路径,其所有节点值之和等于目标值 target_sum”为例,如果在每个节点都维护一个长列表记录完整路径,不仅编写繁琐,而且空间开销巨大。正确的解法是在向下递归时反向扣减当前节点值:
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def has_path_sum(root, target_sum):
    """
    判断二叉树是否存在符合目标和的根到叶路径
    """
    if not root:
        return False

    # 若当前为叶子节点,校验剩余值是否恰好等于该节点值
    if not root.left and not root.right:
        return root.val == target_sum

    # 向左右子树递归,扣除当前节点值
    remaining = target_sum - root.val
    return has_path_sum(root.left, remaining) or has_path_sum(root.right, remaining)
四、递归性能瓶颈攻坚:记忆化搜索与动态规划转化
普通递归最常见的缺陷在于重叠子问题导致的指数级耗时爆炸。经典例子是斐波那契数列计算:直接递归计算 fib(30) 会触发数百万次冗余调用。在进阶解题中,必须学会使用“记忆化(Memoization)”技术,将已计算过的状态缓存起来。
Python 标准库 functools.lru_cache 提供了装饰器级别的记忆化能力,能在不修改核心递归骨架的情况下将时间复杂度从 $O(2^n)$ 直接优化至 $O(n)$:
from functools import lru_cache
import time

# 未加缓存的朴素递归
def fib_naive(n):
    if n <= 1:
        return n
    return fib_naive(n - 1) + fib_naive(n - 2)

# 增加 LRU 缓存的递归
@lru_cache(maxsize=None)
def fib_memo(n):
    if n <= 1:
        return n
    return fib_memo(n - 1) + fib_memo(n - 2)

# 对比测试
if __name__ == "__main__":
    t0 = time.perf_counter()
    res1 = fib_naive(32)
    t1 = time.perf_counter()
    print(f"朴素递归 fib(32) = {res1}, 耗时: {t1 - t0:.4f} 秒")

    t2 = time.perf_counter()
    res2 = fib_memo(32)
    t3 = time.perf_counter()
    print(f"记忆化递归 fib(32) = {res2}, 耗时: {t3 - t2:.8f} 秒")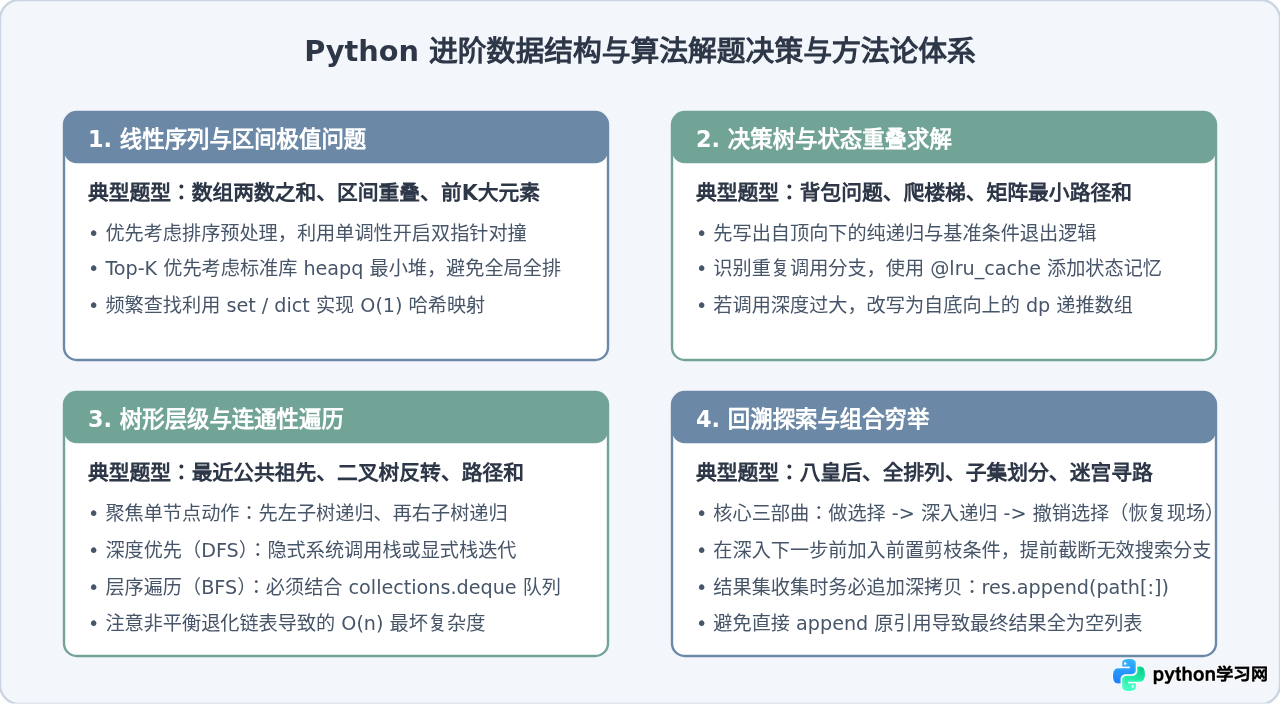
五、实战排错检查清单:写出健壮代码的 5 个关键点
在解答进阶算法题时,除了算法本身的正确性,以下 5 个容易被忽略的实现细节往往是导致测试用例无法通过的关键:
- 空边界与极值测试:函数入参为
[]、单元素数组或全重复元素时是否正常工作?原地快排对于全重复数组,如果指针跳过逻辑未妥善处理,极易退化为 $O(n^2)$。 - Python 切片是浅拷贝:在回溯算法中,使用
path.append(...)之后,将其存入全局列表时必须使用res.append(path[:])或res.append(list(path))。若直接传res.append(path),在回溯弹出元素后,结果集里最终只剩一堆空列表。 - 默认参数陷阱:不要在递归函数中使用可变对象作为默认参数(如
def solve(n, memo={}):)。在 Python 中,函数默认参数只在定义时求值一次,跨次调用会共享该字典,导致不同测试用例互相污染。 - 递归基准必须覆盖完全:编写树递归时,既要考虑
not root,也要考虑叶子节点not root.left and not root.right的判断时机,防止对None节点访问.val引发AttributeError。 - 浮点除法与整除:计算数组中间索引时必须使用整除运算符
mid = (low + high) // 2,避免产生 float 类型导致列表切片或下标报TypeError: list indices must be integers or slices, not float。
掌握递归展开与调用栈回溯的机理、深入理解原地分区与分治排序的时空权衡,并养成严谨的边界校验习惯,是彻底突破 Python 编程初阶瓶颈、应对各类复杂工程算法难题的坚实基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









