

Python经典算法实现:排序、搜索与动态规划代码示例
一、经典排序算法:快速排序与归并排序
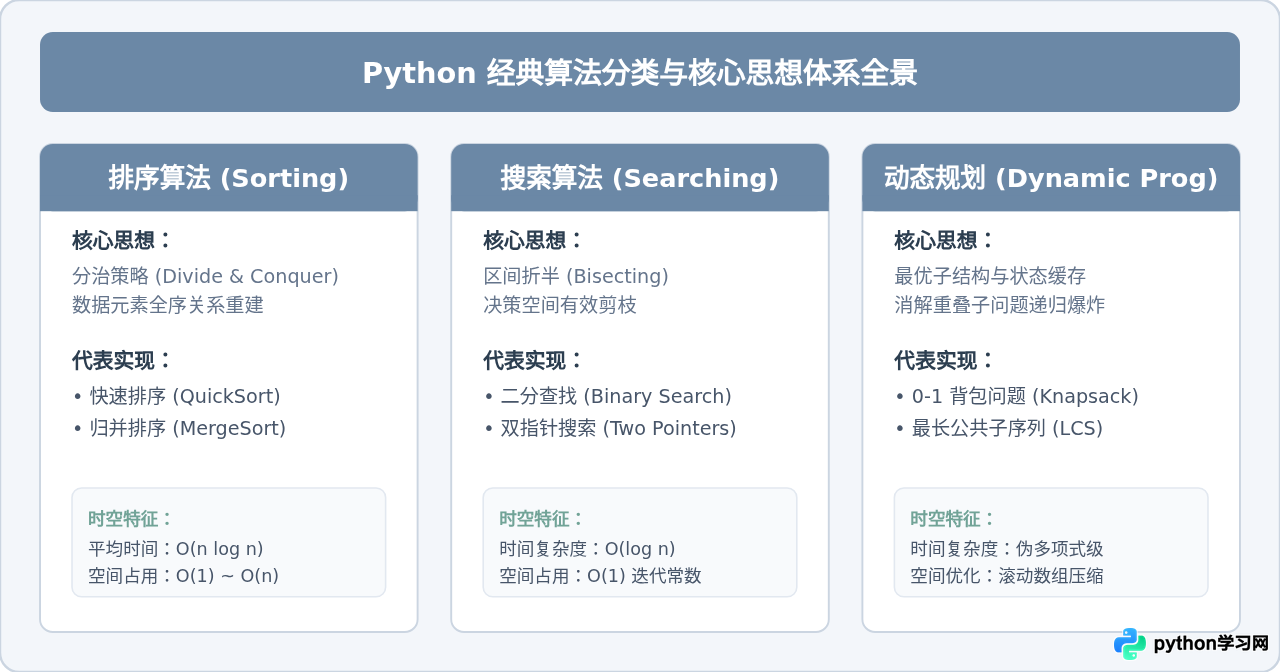
排序是将一组乱序数据按照特定单调规则(递增或递减)重新排列的运算过程。在实际工程与算法竞赛中,基于分治法(Divide and Conquer)的快速排序(QuickSort)和归并排序(MergeSort)应用最为广泛。两者均将庞大的全量数组拆解为独立的子数组,但在“划分”与“合并”的时机上存在本质区别。
1. 快速排序(QuickSort)原理与原地实现
快速排序通过选取一个基准元素(Pivot),通过单次分区操作(Partition)将原数组重新排布,使得基准左侧的所有元素均不大于基准,右侧所有元素均不小于基准。随后,基准的位置永久确定,程序仅需递归处理左右两个子区间。
def quick_sort(arr: list[int], low: int, high: int) -> None:
    """
    快速排序原地实现(双指针 Lomuto 分区方案)
    :param arr: 待排序列表
    :param low: 当前排序区间的起始下标
    :param high: 当前排序区间的结束下标
    """
    if low < high:
        # 获得基准分割点索引
        pivot_index = partition(arr, low, high)
        # 递归排序左半区间
        quick_sort(arr, low, pivot_index - 1)
        # 递归排序右半区间
        quick_sort(arr, pivot_index + 1, high)


def partition(arr: list[int], low: int, high: int) -> int:
    """
    分区函数:以末尾元素作为基准,调整数组并返回基准最终归位索引
    """
    pivot = arr[high]
    i = low - 1  # 小于等于 pivot 区域的右边界

    for j in range(low, high):
        if arr[j] <= pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]

    # 将基准元素放置在正确定位处
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1


# 示例执行代码
if __name__ == "__main__":
    test_data = [29, 10, 14, 37, 13]
    print(f"排序前: {test_data}")
    quick_sort(test_data, 0, len(test_data) - 1)
    print(f"排序后: {test_data}")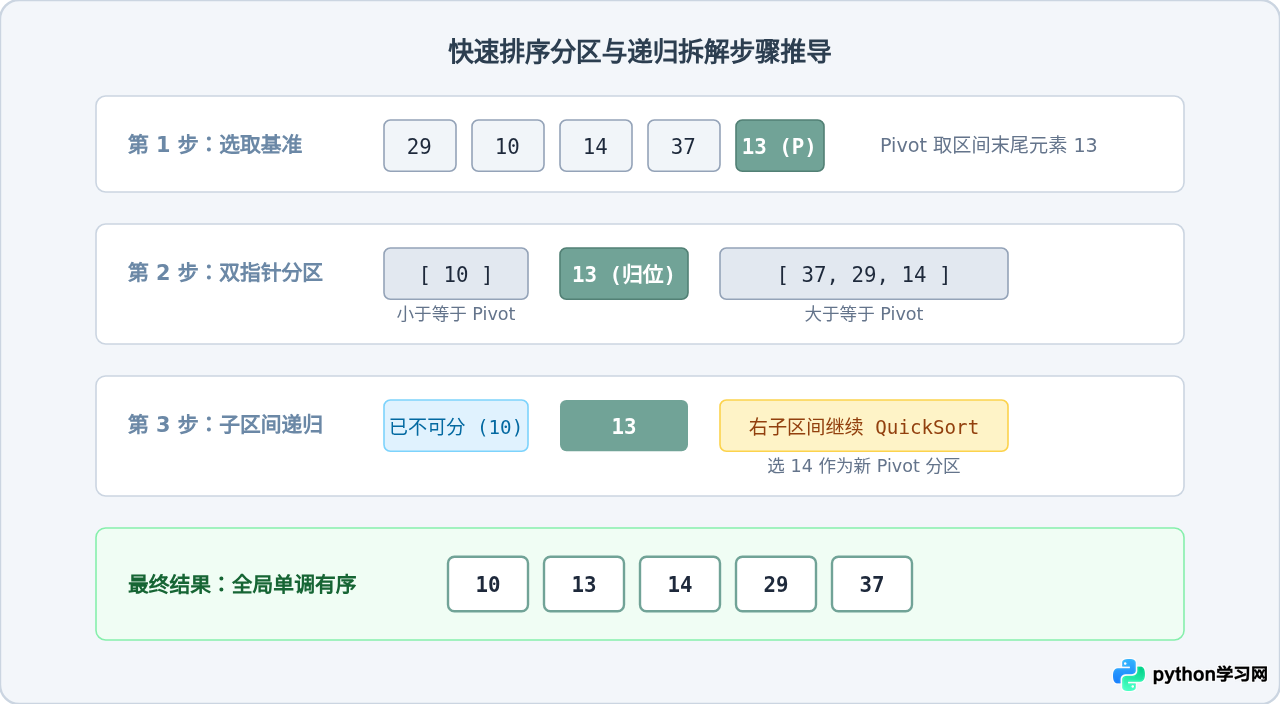
2. 归并排序(MergeSort)代码实现
归并排序则走相反的路线:它并不在下潜阶段调整元素,而是直接从中间将数组对半分裂,直到子数组长度为 1;随后在回溯上升阶段,通过双指针比较,将两个有序子列表合并为一个新的有序列表。这种思路保证了极其稳定的 O(n log n) 时间开销。
def merge_sort(arr: list[int]) -> list[int]:
    """
    归并排序实现(稳定排序,分治合并)
    :param arr: 输入列表
    :return: 全新排好序的列表
    """
    if len(arr) <= 1:
        return arr

    mid = len(arr) // 2
    left_half = merge_sort(arr[:mid])
    right_half = merge_sort(arr[mid:])

    return merge(left_half, right_half)


def merge(left: list[int], right: list[int]) -> list[int]:
    """双指针合并两个有序序列"""
    merged = []
    i = j = 0

    while i < len(left) and j < len(right):
        if left[i] <= right[j]:
            merged.append(left[i])
            i += 1
        else:
            merged.append(right[j])
            j += 1

    # 追加剩余元素
    merged.extend(left[i:])
    merged.extend(right[j:])
    return merged


if __name__ == "__main__":
    nums = [38, 27, 43, 3, 9, 82, 10]
    sorted_nums = merge_sort(nums)
    print(f"归并排序输入: {nums}")
print(f"归并排序输出: {sorted_nums}")O(n²)。工程中常使用“三数取中法”(首、中、尾中位值)或随机选取基准来规避这一退化风险。
二、经典搜索算法:二分搜索的精细控制
搜索算法旨在从数据集中快速定位目标值或确定其不存在。顺序线性搜索的时间复杂度为 O(n),当数据规模庞大时效率极低。如果待检索序列具备“单调有序”的先决条件,二分搜索(Binary Search)即可发挥巨大威力,每次判定排除一半候选空间,将时间压制在 O(log n)。
1. 二分搜索代码实现(迭代与递归版本)
二分搜索代码看似简短,但极易在循环终止条件、区间闭合方式以及索引防溢出上出现 Off-by-one 错误。以下为标准的闭区间 [left, right] 迭代与递归实现:
def binary_search_iterative(arr: list[int], target: int) -> int:
    """
    二分搜索(双指针迭代实现,双闭区间 [left, right])
    :param arr: 升序排列的整数列表
    :param target: 待查找目标值
    :return: 目标所在索引;若不存在则返回 -1
    """
    left = 0
    right = len(arr) - 1

    # 双闭区间下,left == right 仍是有意义的探测点
    while left <= right:
        # 防止较大数值下标相加溢出 (Python虽自动处理长整型,此为通用算法规范)
        mid = left + (right - left) // 2

        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            left = mid + 1   # 目标在右侧,收缩左边界
        else:
            right = mid - 1  # 目标在左侧,收缩右边界

    return -1


def binary_search_recursive(arr: list[int], target: int, left: int, right: int) -> int:
    """二分搜索(递归调用实现)"""
    if left > right:
        return -1

    mid = left + (right - left) // 2
    if arr[mid] == target:
        return mid
    elif arr[mid] < target:
        return binary_search_recursive(arr, target, mid + 1, right)
    else:
        return binary_search_recursive(arr, target, left, mid - 1)


if __name__ == "__main__":
    ordered_list = [4, 8, 12, 16, 23, 29, 35, 42]
    target_val = 23
    idx = binary_search_iterative(ordered_list, target_val)
    print(f"数据列表: {ordered_list}")
    print(f"目标数值: {target_val},查找索引为: {idx}")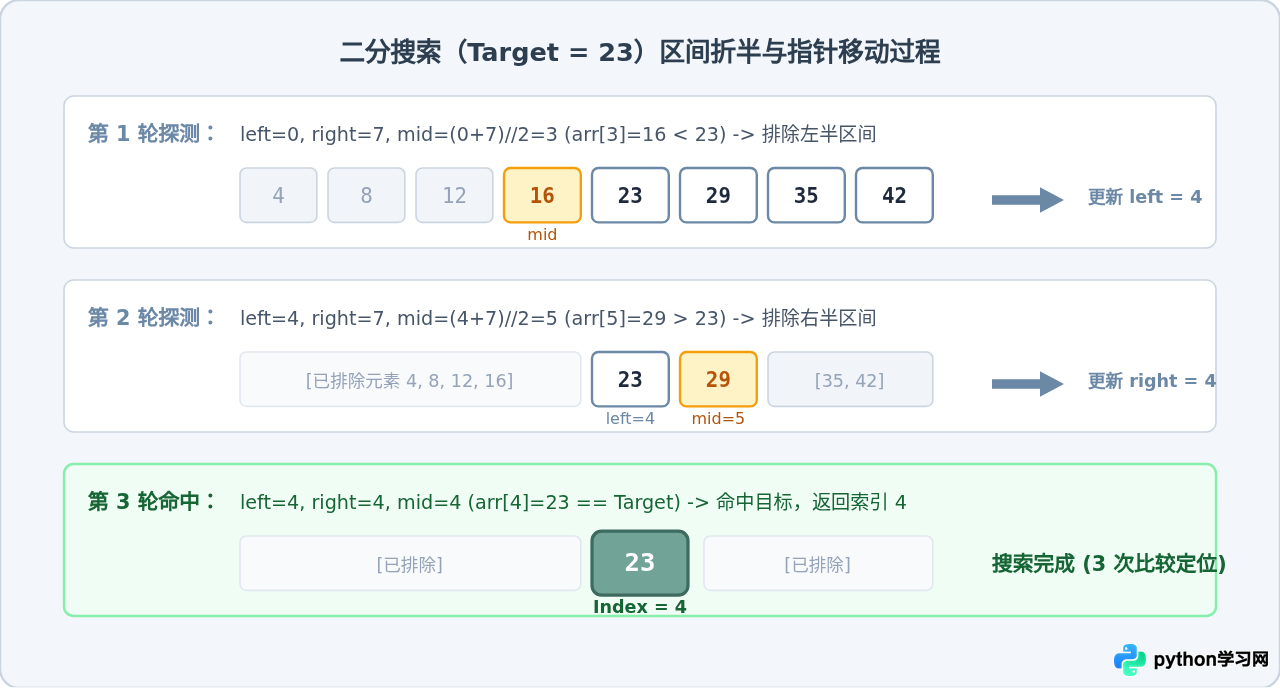
三、动态规划算法:从重叠子问题到状态转移
动态规划(Dynamic Programming, 简称 DP)主要用于求解多阶段决策的最优化问题。它的核心逻辑是:将原问题拆解为相互重叠的子问题,并记录子问题的最优解,避免重复计算。
判断一个问题是否适合使用动态规划,主要关注两个充要属性:
- 最优子结构:大问题的最优解包含着子问题的最优解。
- 重叠子问题:在自顶向下的递归树中,存在大量参数完全相同的重复计算节点。
1. 经典模型:0-1 背包问题(Knapsack Problem)
给定一个承重上限为 W 的背包,以及 n 件具有特定重量 w[i] 和价值 v[i] 的物品。每件物品仅有一件,决策者只能选择“装入”(1)或“不装入”(0)。目标是在背包总承重不超标的前提下,使得装入物品的总价值最大。
设状态 dp[i][w] 表示:仅考虑前 i 件物品,背包容量为 w 时能获取的最大总价值。状态转移方程如下:
# 若当前物品重量大于背包容量,无法装入:
dp[i][w] = dp[i-1][w]

# 若能装入,则在“不装”与“装入”两种决策间取最大值:
dp[i][w] = max(dp[i-1][w], dp[i-1][w - weights[i-1]] + values[i-1])
2. Python 完整代码示例(二维 DP 与一维空间压缩)
def knapsack_01_2d(weights: list[int], values: list[int], capacity: int) -> int:
    """
    0-1背包标准二维动态规划实现
    :param weights: 物品重量列表
    :param values: 物品价值列表
    :param capacity: 背包最大承重
    :return: 最大可能达到的价值总和
    """
    n = len(weights)
    # 初始化 (n+1) x (capacity+1) 的 DP 表格,基准状态为 0
    dp = [[0] * (capacity + 1) for _ in range(n + 1)]

    for i in range(1, n + 1):
        w = weights[i - 1]
        v = values[i - 1]
        for c in range(1, capacity + 1):
            if c >= w:
                dp[i][c] = max(dp[i - 1][c], dp[i - 1][c - w] + v)
            else:
                dp[i][c] = dp[i - 1][c]

    return dp[n][capacity]


def knapsack_01_optimized(weights: list[int], values: list[int], capacity: int) -> int:
    """
    0-1背包空间优化(一维滚动数组逆序遍历)
    空间复杂度从 O(n*capacity) 降低至 O(capacity)
    """
    dp = [0] * (capacity + 1)

    for w, v in zip(weights, values):
        # 必须逆序遍历,确保计算 dp[c] 时所依赖的 dp[c-w] 尚未被本轮物品污染
        for c in range(capacity, w - 1, -1):
            dp[c] = max(dp[c], dp[c - w] + v)

    return dp[capacity]


if __name__ == "__main__":
    item_weights = [1, 3, 4]
    item_values = [15, 20, 30]
    bag_cap = 4

    res_2d = knapsack_01_2d(item_weights, item_values, bag_cap)
    res_1d = knapsack_01_optimized(item_weights, item_values, bag_cap)

    print(f"物品规格: 重量={item_weights}, 价值={item_values}, 容量={bag_cap}")
    print(f"二维 DP 结果: {res_2d}")
    print(f"一维压缩 DP 结果: {res_1d}")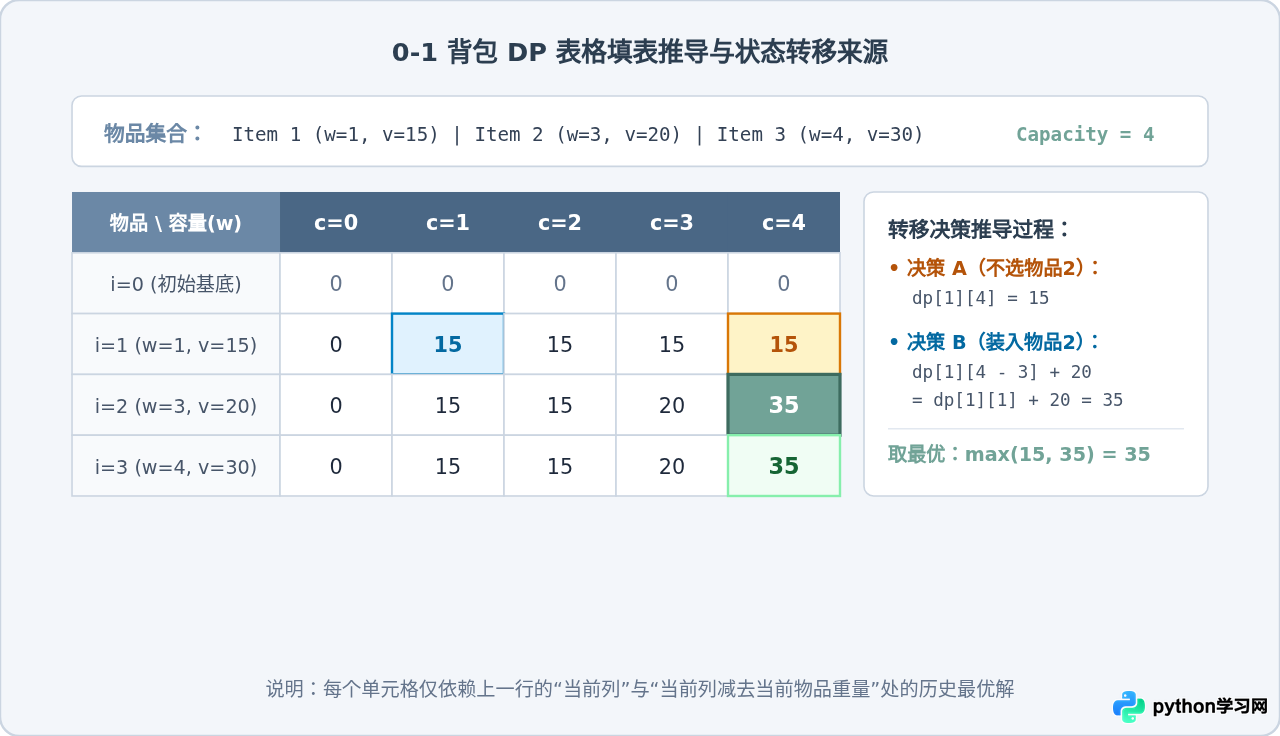
四、三大类算法复杂度与选型决策指南
在实际软件架构中,算法的选择并非盲目追求理论最高效率,而是根据输入数据的分布形态、规模极限以及内存敏感度进行综合权衡。下表总结了本文涉及的经典算法特性:
| 算法类型 | 算法名称 | 平均时间复杂度 | 最坏时间复杂度 | 额外空间复杂度 | 主要依赖条件与场景 |
|---|---|---|---|---|---|
| 排序算法 | 快速排序 (QuickSort) | O(n log n) | O(n²) | O(log n) 原地递归栈 | 内存受限、追求常数项性能,需防范极端逆序退化 |
| 归并排序 (MergeSort) | O(n log n) | O(n log n) | O(n) 额外数组 | 要求排序稳定性(相同元素相对顺序不变)、外部海量排序 | |
| 搜索算法 | 二分搜索 (Binary Search) | O(log n) | O(log n) | O(1) 迭代方案 | 严格要求数据已单调排序;常用于高频只读查询与极值判定 |
| 动态规划 | 0-1 背包问题 | O(n · W) | O(n · W) | O(W) 滚动压缩 | 背包容量 W 为离散正整数,具备重叠子问题和无后效性 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









