

遵循PEP 8规范:Python长表达式与函数调用的换行技巧
深入解析Python PEP 8编码规范中关于长表达式与函数调用的换行规则,系统讲解隐式续行、垂直对齐、悬挂缩进、二元运算符前断行等核心技巧与实战避坑指南。
假设你在日常代码审查中遇到这样一行代码:一个用于发送通知的函数调用,入参不仅包括收件人列表、主题模板、过滤标记,还嵌套了三四个通过布尔条件计算的动态参数,整行代码被拉长到了 130 多个字符。在左右分屏的代码编辑器中,这行代码被直接截断或逼出长长的横向滚动条,既难辨识入参对应关系,也极易在修改时漏掉逗号或括号。解决这一痛点的关键并不在于强行压缩变量名,而在于掌握 Python 官方风格指南(PEP 8)关于长表达式与函数调用的多行排版规范。
一、行长限制与隐式续行原则
PEP 8 规定:所有 Python 代码行的最大长度建议限制在 79 个字符以内(对于文档字符串和注释,建议限制在 72 个字符以内)。将代码行宽限制在 79 字符,并非过时的历史遗留设定,而是为了让开发者在现代高分辨率显示器上并排开启两个甚至三个文件进行 diff 对比时,每一列内容都能完整呈现且无需横向拖拽,同时也能在终端或审查工具中获得最舒服的视觉聚焦。
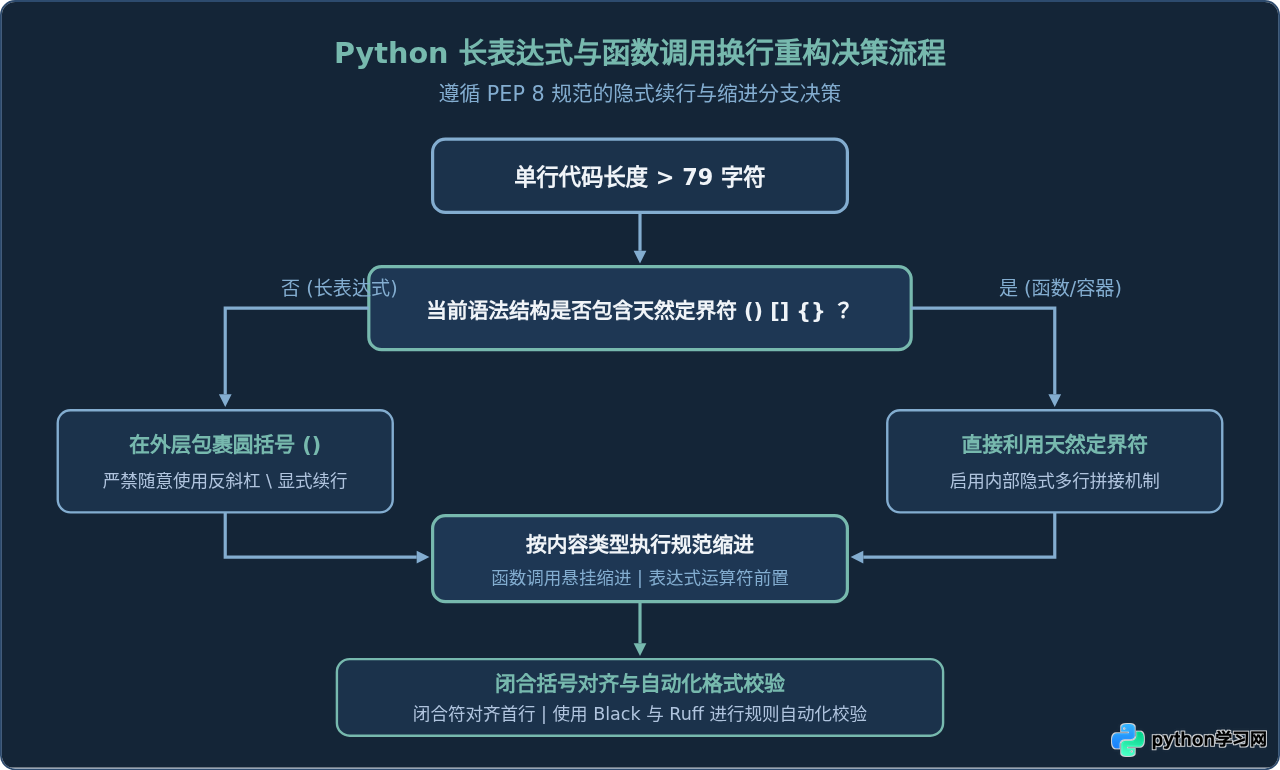
当一行代码超过限制时,Python 提供了两种换行手段:隐式行拼接(Implicit Line Joining)与显式反斜杠续行(Explicit Line Continuation)。PEP 8 明确规定:优先使用圆括号 ()、方括号 [] 和花括号 {} 内部天然支持的多行换行机制,坚决避免使用反斜杠 \ 续行。
# 不推荐做法:滥用反斜杠续行(若反斜杠后意外混入空格,将抛出 SyntaxError)
total_amount = item_base_price + \
               item_tax_fee + \
               shipping_charge

# PEP 8 推荐做法:外层添加圆括号,利用隐式行拼接换行
total_amount = (
    item_base_price
    + item_tax_fee
    + shipping_charge
)
二、函数调用的换行排版:垂直对齐与悬挂缩进
当函数调用由于参数过多或单个参数表达式较长导致超限时,PEP 8 推荐两种合规的多行排版方式:垂直对齐(Vertical Alignment)与悬挂缩进(Hanging Indent)。
1. 模式一:与起始定界符垂直对齐
垂直对齐是指在第一行左括号后紧跟第一个参数,随后的所有参数均向下垂直对齐到第一个参数的起始列。这种方式排版紧凑、列感分明:
# 垂直对齐示例:后续参数与首行左括号后的首个参数纵向严格对齐
response = send_notification_email(user_email_address,
                                   email_subject_text,
                                   template_identifier="welcome_user",
retry_on_failure=True)适用场景与边界:垂直对齐仅适用于函数名较短、赋值变量较短的场景。若函数名很长(如 calculate_accumulated_amortization_schedule(...)),左括号已经在屏幕第 50 列之后,后续参数对齐到第 51 列将导致右侧只剩不足 30 个字符的可用空间,极易再次触碰行长边界。
2. 模式二:4 空格悬挂缩进(最推荐)
悬挂缩进是指在函数名的左括号 ( 后立即换行,不在首行放置任何参数;所有多行参数统一缩进一个标准的层级(通常为 4 个空格)。这种方式不受函数名称长短影响,是大型开源项目和主流格式化工具(如 Black)的标配风格:
# 悬挂缩进示例:左括号后立即换行,内部参数统一缩进 4 格
response = send_notification_email(
    user_email_address,
    email_subject_text,
    template_identifier="welcome_user",
    retry_on_failure=True,
)闭合右括号的放置位置:在悬挂缩进中,右括号 ) 应当单独成行。PEP 8 允许两种对齐方案:一种是对齐到多行构造首行的非空白字符起始位置(即与 response 对齐),另一种是对齐到首行语句的缩进级别。通常建议直接对齐首行缩进,结构清晰且层次稳定。
3. 典型反模式:缩进混淆与对齐错位
严禁的写法:如果在第一行左括号后放置了第一个参数,但第二行参数却没有对齐到括号后,而是仅仅缩进了 4 个空格,这在 PEP 8 中被明确列为错误的反模式(Anti-pattern)。这种写法在视觉上既不是悬挂缩进,也不是垂直对齐,极易使读者产生阅读误判。
# 错误反面示例(PEP 8 禁止):第一行有参数,次行却只做 4 空格缩进
result = process_data_payload(first_input_chunk,
    second_input_chunk, third_input_chunk)  # <-- 错位混淆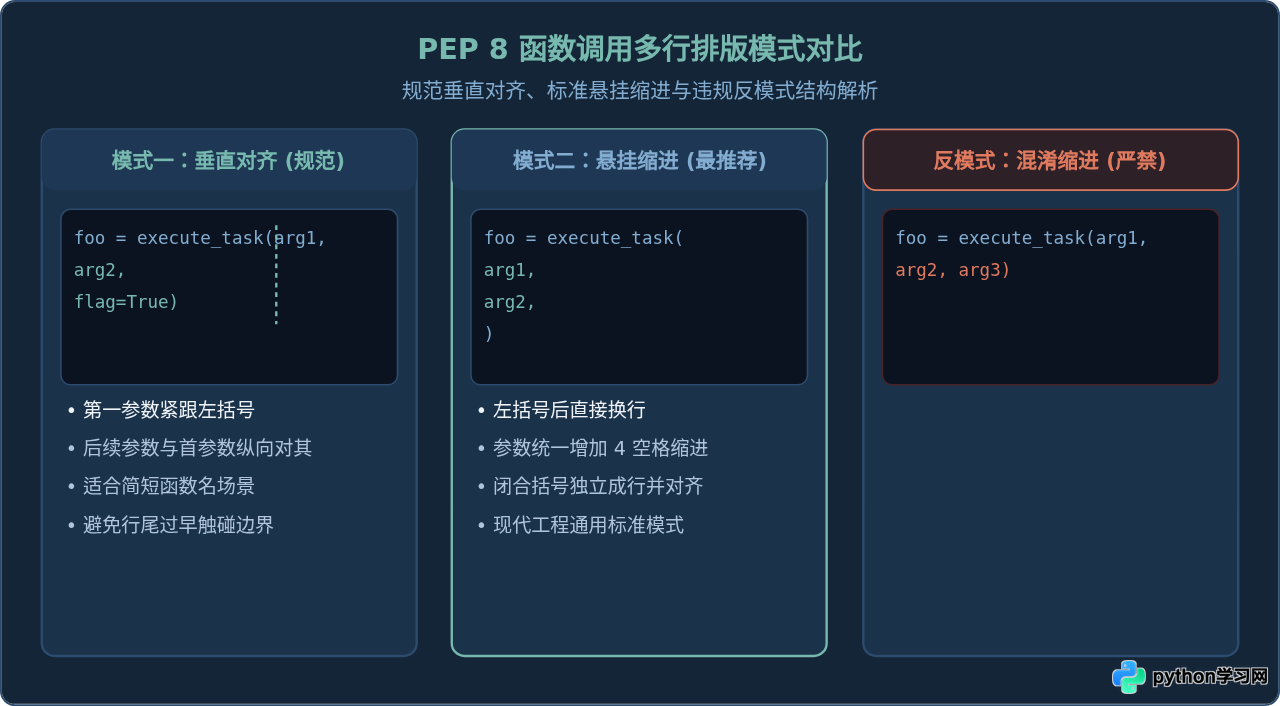
三、长表达式与二元运算符:运算符必须放在行首
长数学计算或复杂布尔条件表达式往往包含多个二元运算符(如 +、-、*、/ 或 and、or)。数十年来,程序员常习惯于“在运算符之后换行”。然而,PEP 8 在经历了长期的社区实践后已正式做出修订:在二元运算符之前断行(Break before binary operators)。
1. 为什么遵循 Donald Knuth 的排印传统?
著名计算机科学家 Donald Knuth 在其排版学专著中早已指出:在数学出版物中,排字工人总是把操作符放在新行的最前面。这种写法有着极为深刻的人类认知学优势:
- 视觉流垂直聚焦:若运算符放在行末,读者必须在每一行末端寻找运算符,由于各行长度参差不齐,眼球需要不停进行无规则的水平摆动;而当运算符位于行首时,所有符号整齐对齐在同一垂直线上,向下扫读时能瞬间掌握“每一项是在加还是在减”。
- 避免符号遗漏:当负号或减号位于行末时,极容易被行尾折叠或读者的注意力盲区忽略,而在行首则极为醒目。
# 不推荐:在二元运算符之后断行(眼球需跳跃至行末寻找逻辑符号)
income = (gross_wages +
          taxable_interest +
          dividends -
          qualified_deductions -
          retirement_contributions)

# PEP 8 推荐:在二元运算符之前断行(运算符左侧垂直对齐,逻辑一目了然)
income = (
    gross_wages
    + taxable_interest
    + dividends
    - qualified_deductions
    - retirement_contributions
)
2. 布尔逻辑长表达式的多行换行
在复杂的 if 条件判断中,多个 and 与 or 的串联同样必须遵循“运算符位于行首”的原则。为了防止判断条件多行缩进与随后的 if 执行体代码块混为一体,PEP 8 提供了明确的视觉分隔技巧:
# 推荐写法:运算符在行首,且通过 4 空格悬挂缩进保持清晰层级
if (
    is_authenticated
    and user_has_admin_role
    and not is_account_suspended
):
    execute_privileged_operation()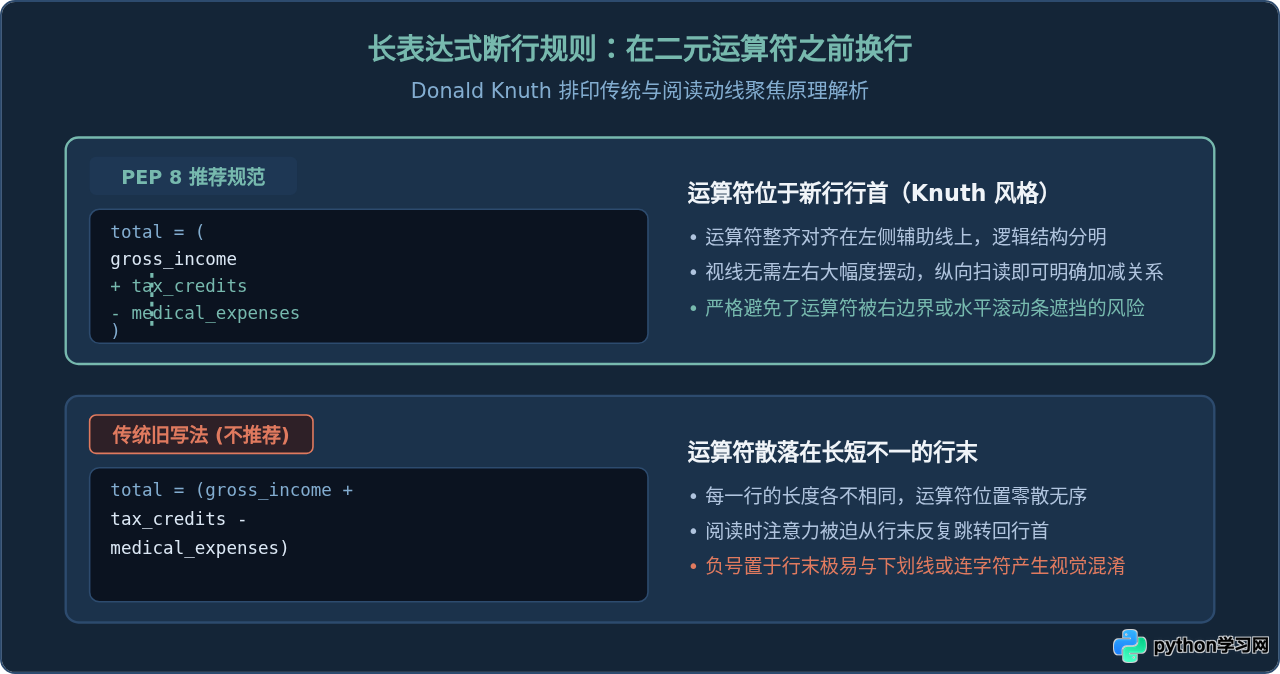
四、链式调用、复合结构与尾随逗号
除了普通的算术计算与函数调用外,在数据清洗(如 Pandas / Polars)以及 ORM 查询(如 SQLAlchemy / Django ORM)中经常出现长链式方法调用。掌握以下细节能显著提升这类代码的工程质量:
1. 链式方法调用的“点号置于行首”
对于连续的方法调用,不要使用反斜杠换行,而是将整个链条用外层圆括号包裹,并将点号 . 统一置于每行行首:
# 链式调用推荐排版:外层加括号,点号置于行首,保持 4 空格缩进
processed_queryset = (
    User.objects.filter(is_active=True)
    .exclude(profile__bio__isnull=True)
    .order_by("-date_joined")
    .values("id", "username", "email")
)
2. 多行序列中保留尾随逗号(Trailing Comma)
当字典、列表、集合或多行函数的参数跨多行展开时,在最后一项之后加上逗号是一项非常关键的工程最佳实践:
# 字典与参数多行排版中务必保留末尾逗号
api_config = {
    "endpoint_url": "https://api.internal.service/v2/ingest",
    "timeout_seconds": 30,
    "max_retries": 5,
    "enable_compression": True,  # <-- 末尾逗号
}
尾随逗号的两大工程价值:
- 净化 Git Diff:后续新增配置项时,版本控制系统只会高亮真正新增的代码行,而不会在上一行显示因“补充逗号”而产生的无意义变更。
- 防止隐式字符串拼接 Bug:在 Python 中,若两个字符串字面量相邻且没有逗号隔开,解释器会将其自动拼为一个字符串(例如
"a" "b"会变成"ab")。在多行列表末尾养成保留逗号的习惯,能从根本上避免因为忘记补逗号而引发的隐蔽语法 Bug。
五、规范落地与自动化工具链配置
人肉维护排版不仅效率低下,而且容易因个人审美差异导致代码仓库风格割裂。要确保 PEP 8 换行规则在团队中真正落地,应当构建标准化的自动化检查工作流:
- 配置 Linter(静态检查):使用
Flake8或高性能的Ruff,开启E501规则检测超长行,结合W503(在二元运算符前换行,当前已被 PEP 8 推荐,需在旧版 Flake8 中设为忽略)和W504,确保检查器与最新的 PEP 8 标准保持一致。 - 使用确定性代码格式化器:引入
Black。Black 的核心哲学就是强制采用带有尾随逗号的 4 空格悬挂缩进和运算符前置原则,无需开发者手动争论换行细节,一次保存即可完成格式化。 - 配置 Git Pre-commit 钩子:在代码提交前自动运行格式化与行宽检查,将违规排版阻断在本地提交阶段,确保远端主分支代码的整洁与统一。
六、总结
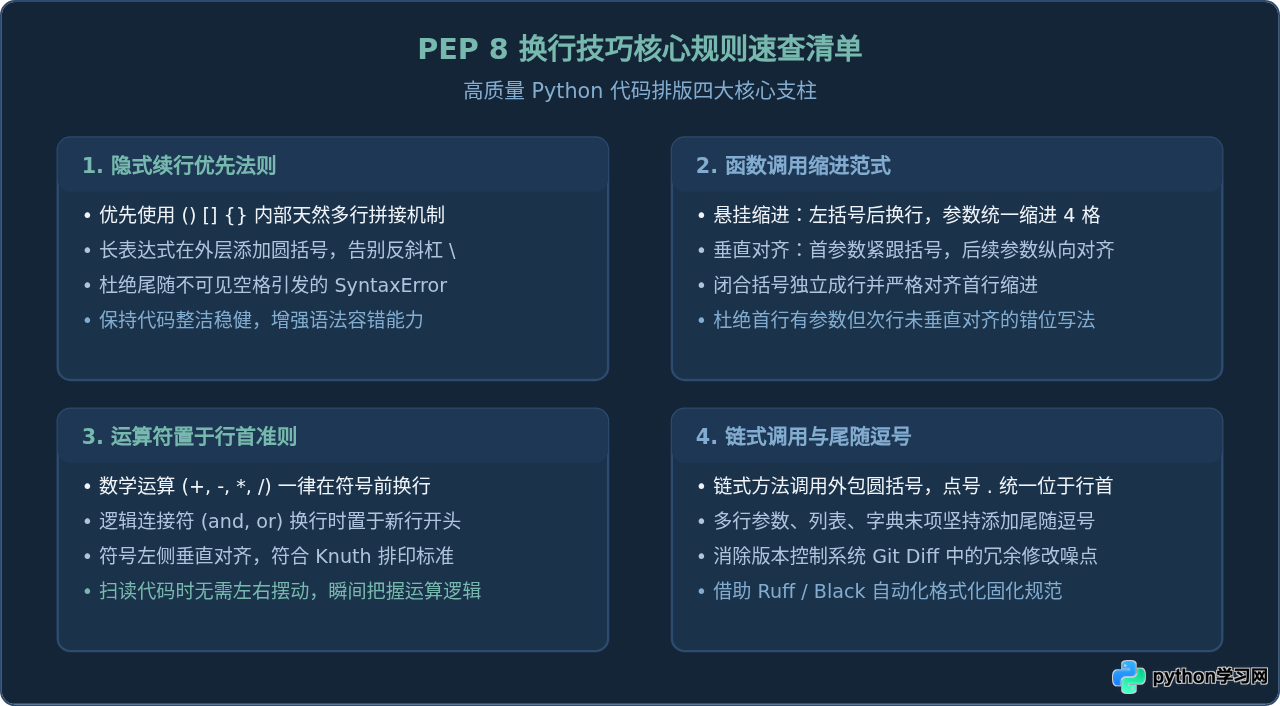
编写高质量 Python 代码的过程,本质上是一场与认知负担对抗的实践。长表达式与长函数调用的合理换行,绝非纯粹的视觉美学修饰,而是保证代码逻辑准确传达、减少团队审查阻力、避免低级语法隐患的工程基石。在日常编码中牢记:以圆括号隐式续行替代反斜杠,以 4 空格悬挂缩进保持结构弹性,以行首二元运算符引导阅读视线,以尾随逗号规范版本追溯。结合自动化的 Linter 与代码格式化工具,团队便能轻松建立起一致、健壮且优雅的代码库。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









