

Python标准库与第三方常用库有什么区别?典型代表有哪些
深入对比Python标准库与第三方常用库在分发机制、生命周期、功能深度上的核心区别,盘点网络请求、数据计算、序列化等核心领域的典型代表库,并提供工程选型与实操建议。
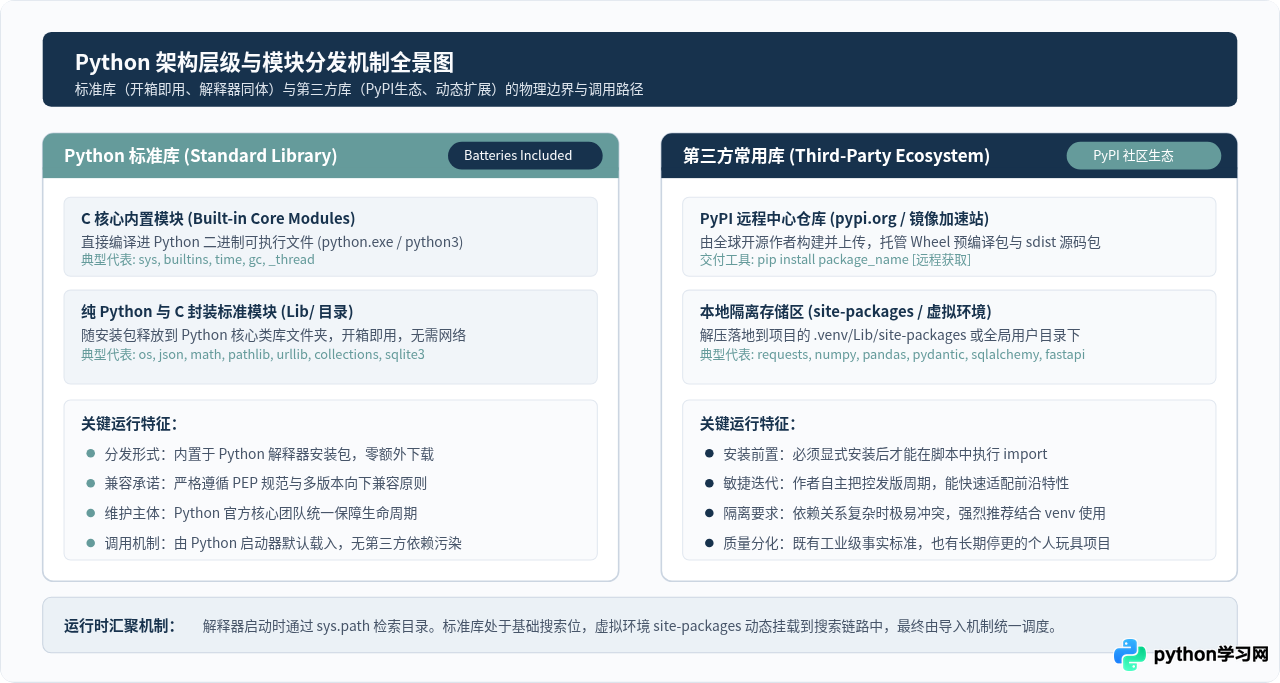
import 使用;而第三方常用库(Third-party Libraries)是由全球开发者社区维护并托管在 PyPI(Python Package Index)上的外部扩展包,必须使用包管理器(如 pip)显式安装后才能调用。两者在分发途径、演进节奏、功能深度以及工程维护责任上存在本质区别。
一、Python 标准库与第三方库的核心区别
很多初学者在写代码时,常会疑惑为什么有些模块直接输入 import math 就能运行,而输入 import requests 却会报错 ModuleNotFoundError。理解它们之间的分工与边界,是建立扎实 Python 工程思维的第一步。我们可以从以下四个关键维度进行剖析:
- 分发与安装途径不同:标准库随 Python 官方安装包一并分发。只要本地成功安装了 Python 环境,标准库文件就已经存在于系统的 Python 目录中(例如系统的
Lib/目录或内置于二进制可执行文件中)。第三方库则独立发布在公共仓库 PyPI 上,开发者必须通过命令行工具pip install <package_name>下载并安装至指定虚拟环境或系统的site-packages目录。 - 版本演进与发布节奏不同:标准库的更新完全绑定 Python 解释器的版本周期(通常每年发布一个次要版本,如从 3.11 到 3.12)。为了保持长期向下兼容,标准库的修改和增删需经过严格的 Python 增强提案(PEP)审查,演进相对克制保守。第三方库则拥有完全独立的版本生命周期,作者可按月、按周甚至按天修复漏洞与迭代特性,演进速度极为敏捷。
- 设计理念与功能深度不同:标准库强调“通用性”与“无外部依赖”,优先满足操作系统的基础抽象、基本文件处理与通用网络通信协议,通常不追求最前沿或最花哨的封装。第三方库则专注于“极致体验”与“垂直解决特定痛点”,通常以极具表达力的人性化 API、高度优化的底层性能(如绑定 C/Rust/Fortran 扩展)为特色。
- 稳定性保障与维护责任不同:标准库由 Python 官方核心开发团队(Core Developers)统一维护,提供极高规格的长期向下兼容承诺,通常遵循多年的弃用警告期。第三方库的质量与维护年限则取决于开源作者或商业组织,不同包的维护活跃度、测试覆盖率和合规协议存在明显差异。
二、核心业务场景下的典型代表库与实测对比
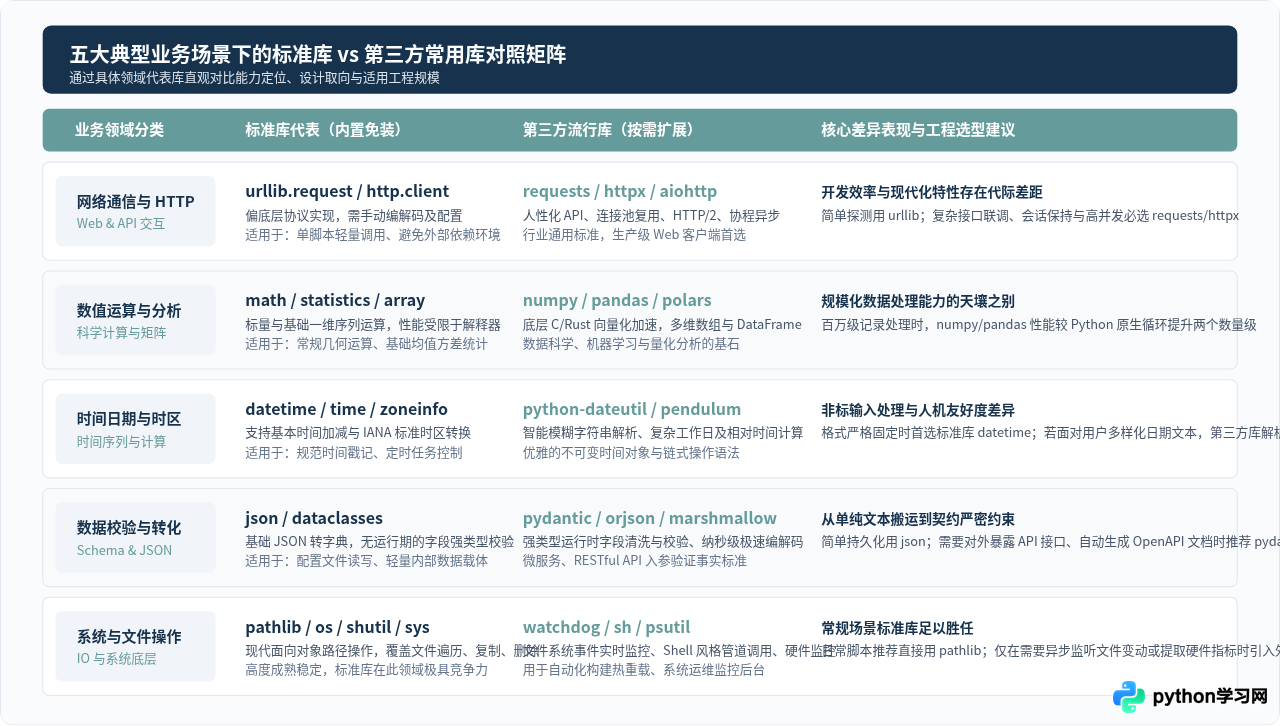
虽然标准库与第三方库职责不同,但在很多常见场景下,它们分别提供了“基础保障型”与“高效进化型”两套解决方案。下面通过 5 个最核心的开发领域进行具体代码与特性的直观对照:
1. 网络请求领域:urllib vs requests / httpx
标准库提供了 urllib.request,它是 Python 处理网络协议的原生组件。然而,其 API 风格诞生较早,需要手动处理编码、构建 Handler 处理 Cookie 与认证,代码相对繁琐。第三方库 requests 则是 Python 生态中最成功的库之一,提出了“HTTP for Humans”理念;现代项目亦常采用支持异步协程与 HTTP/2 的 httpx。
# 方式 A:使用标准库 urllib.request 发起带参数与 Header 的 GET 请求
import json
from urllib.request import Request, urlopen
from urllib.parse import urlencode

params = urlencode({"keyword": "python"})
url = f"https://api.example.com/search?{params}"
req = Request(url, headers={"User-Agent": "MyClient/1.0"})

with urlopen(req) as resp:
    status_code = resp.status
    raw_data = resp.read().decode("utf-8")
    result = json.loads(raw_data)
    print(f"[urllib] 状态码: {status_code}, 结果: {result}")

# 方式 B:使用第三方库 requests 完成相同任务(语义直接、自动处理 JSON 与编码)
import requests

response = requests.get(
    "https://api.example.com/search",
    params={"keyword": "python"},
    headers={"User-Agent": "MyClient/1.0"},
    timeout=5
)
print(f"[requests] 状态码: {response.status_code}, 结果: {response.json()}")
2. 数值计算与数据分析:math / statistics vs numpy / pandas
标准库的 math 和 statistics 专为标量(单一数字)计算设计,处理列表时需要依赖 Python 原生的 for 循环或列表推导式,无法利用 CPU 向量化指令,在面对十万、百万级数据时性能瓶颈明显。而第三方库 numpy 底层由 C/Fortran 编写,提供连续内存存储的 ndarray;pandas 则在此基础上构建了强大的表格数据结构 DataFrame,支持纳秒级分组聚合与清洗。
3. 时间日期与时区处理:datetime / zoneinfo vs python-dateutil / pendulum
Python 3.9+ 的标准库提供了 datetime 与 zoneinfo,足以覆盖大部分标准 ISO 时间戳计算与时区转换。然而在处理非规范的自然语言时间字符串(如 "2026-10-27 16:30"、"yesterday")或计算相对时间增量(如“每个月最后一个工作日”)时,第三方库 python-dateutil 的智能解析与 pendulum 的链式操作提供了极其强大的生产力补充。
4. 序列化与数据验证:json / dataclasses vs pydantic / orjson
标准库的 json 负责基础字典与文本之间的序列化,dataclasses 提供了整洁的对象结构。然而在现代 Web 开发(如 FastAPI)中,接口入参必须进行严格的类型转换与校验。第三方库 pydantic 能够在运行时依据类型提示自动做类型约束与错误提示,而 orjson 则通过 Rust 底层实现了数倍于标准库的超高速 JSON 编解码。
5. 文件系统与操作系统交互:os / pathlib vs watchdog / sh
在文件路径处理上,现代 Python 标准库的 pathlib 已经实现了高度的面向对象封装,在绝大部分场景下无需再引入额外第三方库。但如果业务需求演进为“实时监听指定目录下的文件增删变化”,标准库并未内置跨平台的文件事件轮询机制,此时就需要第三方库 watchdog 来调用底层操作系统的 inotify 或 FSEvents。
三、规范实操:第三方库的工程化管理与环境隔离
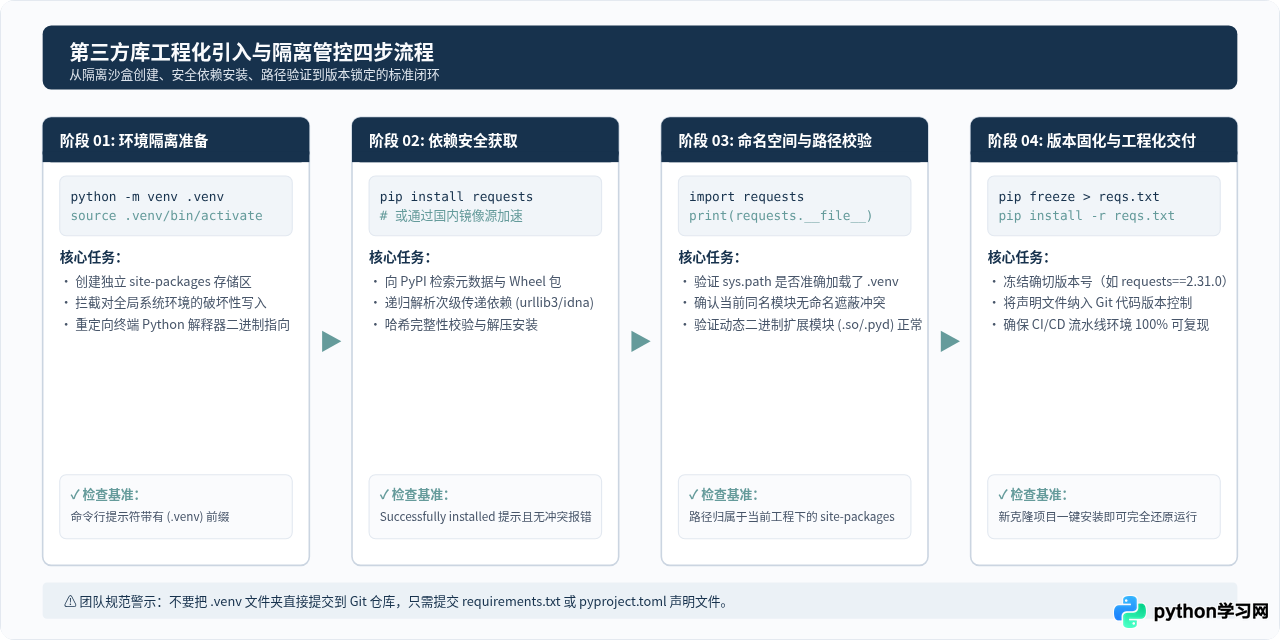
由于标准库不需要做任何准备工作,开发者主要的心智负担集中在如何安全、干净、可复现地管理第三方库。直接使用全局 pip install 很容易导致不同项目依赖不同版本时产生覆盖冲突(即臭名昭著的“依赖地狱”)。现代 Python 项目标准操作步骤如下:
步骤 1:为当前项目创建专属虚拟环境
使用标准库自带的 venv 模块在当前项目根目录下生成独立的 Python 隔离沙盒,彻底切断全局包的污染风险:
# 在终端(Terminal)执行:创建名为 .venv 的虚拟环境目录
python -m venv .venv

# macOS / Linux 平台激活环境:
source .venv/bin/activate

# Windows PowerShell 平台激活环境:
.venv\Scripts\Activate.ps1
步骤 2:精准安装指定版本的第三方库
激活环境后,命令行提示符通常会出现 (.venv) 前缀。此时调用的 pip 会自动将第三方库下载至 .venv/lib/site-packages:
# 推荐:显式声明主版本号,避免意外引入不兼容的重大变更
pip install "requests>=2.31.0,<3.0.0"
步骤 3:验证模块来源与物理文件路径
在项目中编写脚本时,可以通过打印模块的 __file__ 属性,快速判断当前调用的是标准库还是虚拟环境中的第三方库:
import json
import requests

# 标准库路径:指向 Python 解释器系统的 Lib 目录
print("json 标准库物理路径:", json.__file__)
# 示例输出: /usr/local/lib/python3.11/json/__init__.py

# 第三方库路径:指向当前项目虚拟环境的 site-packages 目录
print("requests 第三方库物理路径:", requests.__file__)
# 示例输出: /Users/username/my_project/.venv/lib/python3.11/site-packages/requests/__init__.py
步骤 4:固化依赖清单以实现团队协同与生产交付
为了保证同事拉取代码或服务器部署时环境完全一致,应当将当前环境下所有已安装的第三方库版本导出为固化清单:
# 导出当前虚拟环境的所有包及其确切版本
pip freeze > requirements.txt

# 生产环境或协作成员一键还原安装
pip install -r requirements.txt
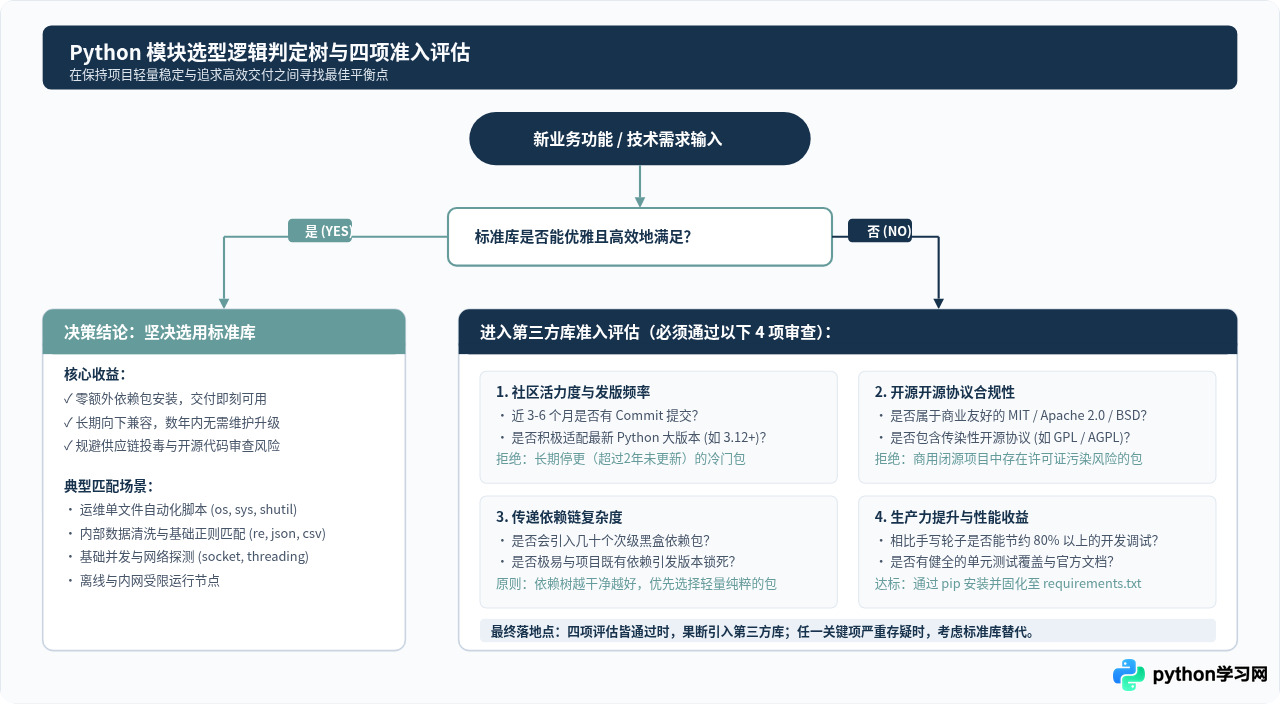
四、技术选型决策:什么时候用标准库?什么时候引入第三方库?
很多开发者在面临新需求时容易走向两个极端:要么“过度依赖第三方”,连简单的字符串去除空格都要找个库安装;要么“狂热自造轮子”,在标准库明明已经有完善支持的情况下,耗费数天自己写出满是 Bug 的低效实现。科学的选型决策可遵循以下原则:
1. 优先采用标准库的场景
- 轻量级独立自动化脚本:例如服务器定时清理日志、向企业微信/钉钉 Webhook 推送告警、本地批量重命名图片等。纯标准库脚本可以直接复制到任何同版本 Python 服务器上直接执行,免去了安装 pip、配代理和建环境的全部前置运维成本。
- 严苛的无网络/内网隔离环境:在很多银行、军工或高度机密的企业内部服务器中,外部网络完全被物理阻断,建立私有 PyPI 镜像源成本较高。此时最大限度使用标准库是保障任务落地的最优解。
- 长期无人值守的基础设施工具:标准库提供极其稳健的跨版本兼容性。五年前用标准库写的合法代码,在今天大概率依然能平稳运行,几乎零维护成本。
2. 果断引入第三方常用库的场景
- 核心业务支撑与主流开发框架:例如构建 Web 服务的 FastAPI/Django、进行海量数据分析的 Pandas、操作数据库 ORM 的 SQLAlchemy。这些库凝聚了开源社区数千位工程师数十年的经验沉淀,能大幅提升业务交付质量与抗风险能力。
- 底层涉及高性能密集计算:如涉及矩阵分解、机器学习推理、大规模图网络计算。Python 解释器本身的字节码机制并不擅长高频数值密集循环,通过 NumPy 等 C 扩展库能直接绕过 GIL 限制并利用 CPU SIMD 指令集。
- 工业级复杂协议与接口对接:例如对接 OAuth 2.0 认证、解析极其复杂的 Excel/PDF 文件、管理大规模连接池等,自己用标准库从零解析不仅周期漫长,而且极易遗漏边缘安全缺陷。
五、开发者常见误区与避坑指南
虽然标准库向下兼容性极佳,但为了生态健康,官方仍会根据 PEP 594 逐步剔除长久过时或存在安全缺陷的“历史包袱”。例如在 Python 3.12 中,经典的 distutils、asynchat、asyncore 以及用于简易加密的 crypt 已被正式移除。若升级新版解释器,老旧脚本需要迁移至现代标准库(如 pathlib、asyncio)或指定第三方库。
初学者在学习或测试模块时,常顺手将自己的代码文件命名为 json.py、math.py、requests.py。由于 Python 解释器在模块检索时,默认会优先搜索当前运行脚本所在的当前目录,导致你在脚本内部执行 import json 时,导入的其实是你自己刚写的文件,进而引发极其隐蔽的 AttributeError: partially initialized module 'json' has no attribute 'loads'。切记:永远不要使用任何库名称作为自己的 .py 文件名。
不少开发者习惯于随手在系统全局终端里直接执行 pip install package。当项目 A 需要安装某个库的 1.x 版本,而新项目 B 需要该库的 2.x 版本时,后安装的版本会直接覆盖先前的版本,造成原有工程瞬间瘫痪。因此,“凡开新项目,必建虚拟环境(venv)”应当成为每位 Python 开发者的肌肉记忆。
总结
Python 标准库与第三方常用库并不是互相排斥的对立面,而是共同构成了 Python 语言强大的生命力支撑:
- 标准库是地基:由 Python 官方严格守护,它赋予了每个系统环境下 Python 解释器开箱即用的基础运转能力,保证了跨平台、免维护工具脚本的极高稳定性。
- 第三方常用库是繁荣的高楼:由全球开源开发者共同铸造,它敏捷地拥抱前沿技术,将高阶抽象、极致性能与友好体验赋予实际业务,让 Python 成为当今 Web 开发、数据分析、人工智能等领域的事实标准。
在日常开发中,建议先审视标准库是否已经提供了优雅的解法;当业务规模、开发效率或计算性能提出更高要求时,再结合虚拟环境规范引入经过社区验证的第三方主流库,从而在轻量免维护与高效交付之间取得最佳工程平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









