

零基础转行数据分析,Python需要掌握Pandas到哪种程度?
针对零基础转行数据分析的学习者,深入剖析Python中Pandas所需掌握的真实技能边界,拆解核心必修操作、业务数据流与实战检验标准。
核心判断:零基础转行初级数据分析师,Pandas完全不需要背诵全部数百个API,也不需要研究底层源码;考核达标的关键红线在于“能够替代Excel高级数据透视表和SQL复杂查询,独立完成本地表格的读取清洗、多表关联对齐、分组聚合指标计算,并导出符合汇报要求的规整数据”。
很多零基础跨专业转行数据分析的学习者,在接触Python时最常陷入一个认知陷阱:买一本厚重的参考书或者找一套上百集的教程,从头到尾死记硬背Pandas的每一个参数和方法。这种做法往往耗费数月时间,面对实际业务数据集时却依然不知道从何下手。
在企业日常数据分析岗位中,Pandas扮演的角色本质上是一个“超轻量级的内存数据处理工作台”。理解它的能力边界与面试考核重点,把精力集中在真正高频的核心操作上,是转行者最高效的破局路径。
一、定位分水岭:转行求职的Pandas掌握阶梯
数据分析岗位的技术要求与数据工程、算法开发截然不同。数据分析师的核心价值在于从数据中发现业务问题并输出决策建议,而非编写高并发、底层优化的生产系统。因此,Pandas的技能层级呈现非常清晰的金字塔结构。
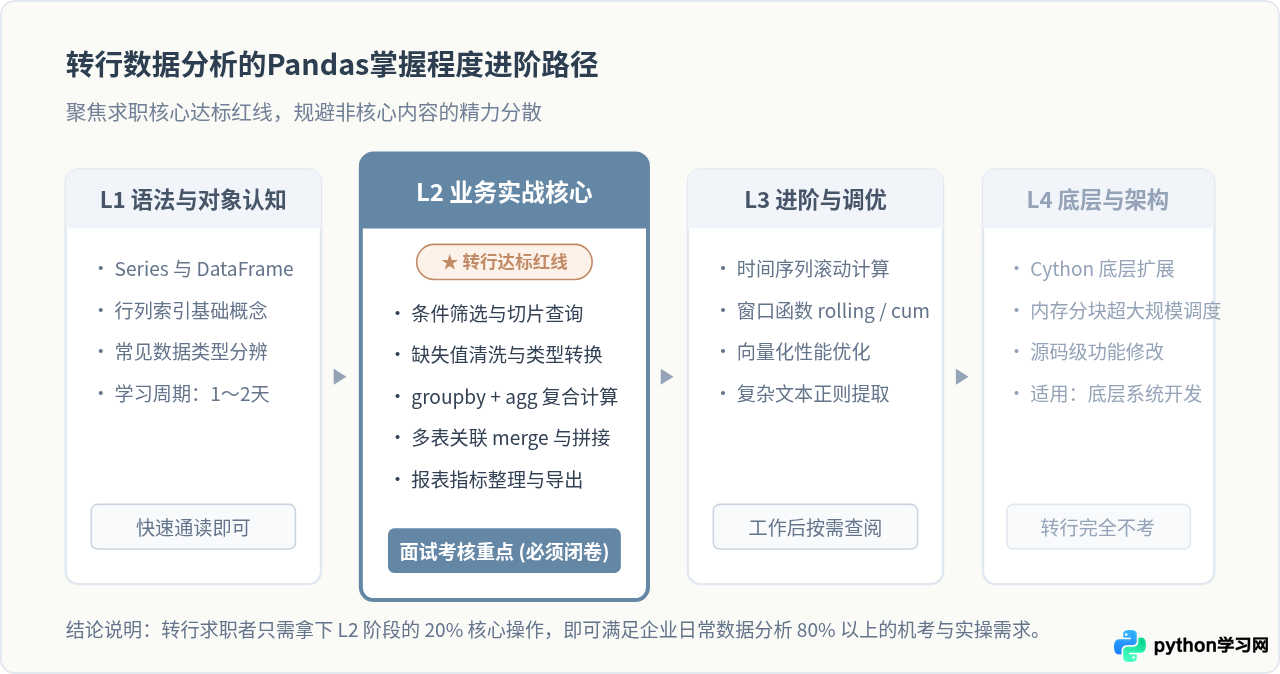
如上图所示,转行者需要攻克的核心是L2业务实战阶段。在此阶段,学习者不需要记忆所有偏门参数,但必须对常见清洗、筛选、分组聚合与多表连接形成肌肉记忆,脱离代码提示也能顺畅写出基本处理逻辑。
二、必修能力清单:必须熟练掌握的六大核心操作
根据主流企业初级数据分析师招聘的笔试机考与业务实测,以下六项操作构成Pandas能力的基石:
1. 数据读取与基础属性探查
能够熟练将本地或网络数据加载为DataFrame,并迅速了解表格结构与质量。
pd.read_csv()与pd.read_excel():掌握编码参数(如encoding='utf-8'或'gbk')与时间解析参数parse_dates。df.shape、df.dtypes、df.info():用于确认数据行列数、各列字段类型及是否存在非空缺失。df.describe():快速查看数值型字段的极值、均值与分位数分布,识别是否存在极端异常值。
2. 精准切片与多条件筛选
业务分析往往只关注特定维度的数据(例如“华东区域且订单金额大于500的已支付用户”)。
- 布尔索引切片:掌握用
&(与)、|(或)、~(非)组合多个条件,注意每个条件表达式必须用圆括号包裹,例如df[(df['region'] == 'East') & (df['amount'] > 500)]。 - 范围筛选:掌握
isin()处理多值匹配,以及between()处理区间过滤。 - 标签与位置检索:准确区分
.loc[行标签, 列名]与.iloc[行索引位置, 列索引位置],避免直接使用链式切片(如df['col'][0])引发意料之外的只读视图问题。
3. 数据清洗与规范化
原始业务数据通常包含大量缺失、异常格式与重复记录。清洗操作的熟练度直接决定分析结果的可信度。
- 缺失值处理:用
isna().sum()统计每列缺失比例;结合业务口径决定采用fillna(0)/fillna('未知')填充,或是使用dropna(subset=['order_id'])剔除关键列缺失的行。 - 类型强制转换:使用
astype()纠正数据类型,例如将字符串类型的订单金额转换为浮点型float,将数字代码转换为字符串str以防止前置零丢失。 - 重复记录处理:使用
drop_duplicates(subset=['user_id'], keep='last')清理重复点击或重复下单行为。
4. 分组聚合统计(groupby + agg)
这是整个Pandas在业务分析中最核心的操作,地位等同于SQL中的 GROUP BY 或Excel中的数据透视表。必须达到无需翻书即可灵活运用的程度。
# 示例:按渠道和城市统计支付用户数、总销售额、平均客单价
summary_df = df.groupby(['channel', 'city']).agg(
    total_users=('user_id', 'nunique'),
    total_sales=('amount', 'sum'),
    avg_amount=('amount', 'mean')
).reset_index()
注意末尾的 reset_index():分组聚合后的默认结果会把分组列转换为层次化索引(MultiIndex),调用 reset_index() 能够将其平铺回常规的扁平二维表,方便后续二次计算或导出。
5. 多表关联与纵向合并(merge & concat)
现实中用户信息、订单明细、商品维度表往往分散在不同文件中,需要根据业务主键进行组合。
pd.merge(left_df, right_df, on='user_id', how='left'):熟练区分left(左连,保留左表全量)、inner(内连,仅保留交集)与outer(全外连),并具备识别“多对多导致行数异常膨胀”的排查意识。pd.concat([df_jan, df_feb], axis=0, ignore_index=True):用于将结构一致的按月、按日表格做纵向堆叠拼接。
6. 基础时间序列与结果输出
- 使用
pd.to_datetime(df['create_time'])将文本时间序列化,通过.dt.year、.dt.month、.dt.day_name()或.dt.date快速派生时间维度字段。 - 使用
to_excel('result.xlsx', index=False)或to_csv('result.csv', index=False)输出最终报表,必须熟练设置index=False以免输出多余的无序数字索引列。
三、边界厘清:哪些内容在转行初期坚决不深究?
明白“不学什么”往往比“学什么”更能帮助零基础转行者建立信心。下表梳理了企业日常面试与工作中的分界线:
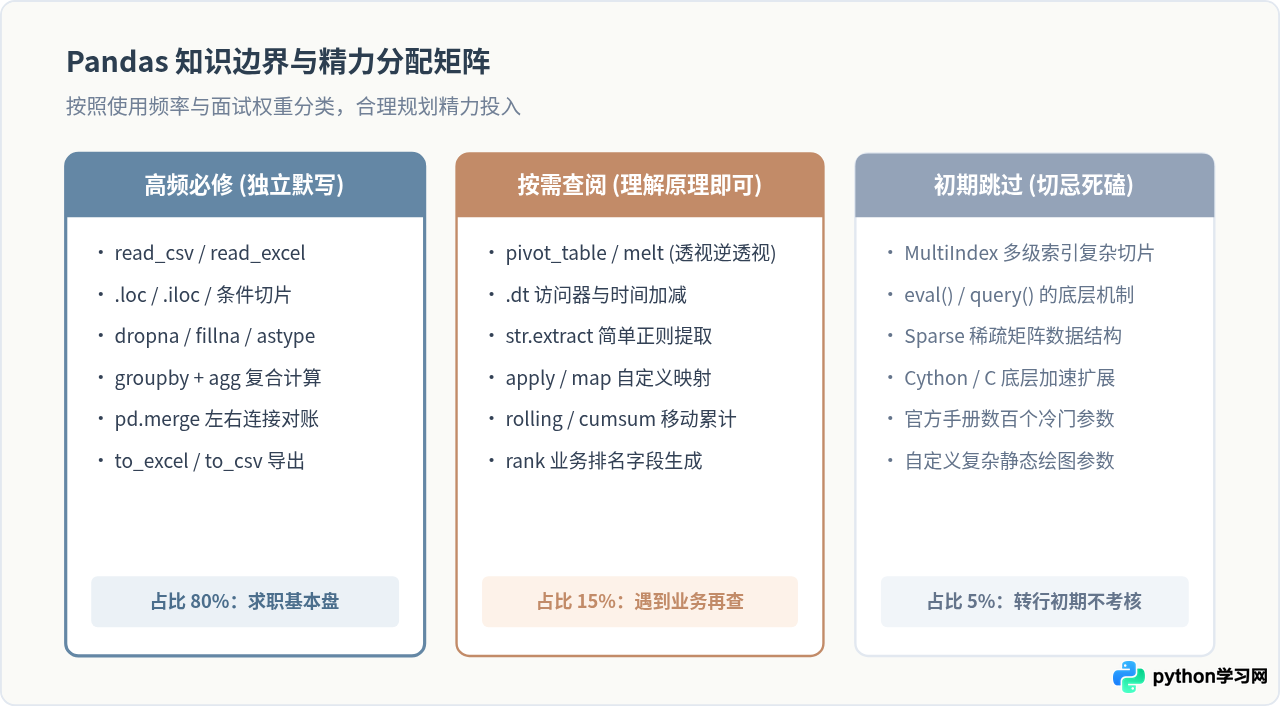
许多初学者被多层索引(MultiIndex)卡住,不知道如何进行列提取。在实际业务中,最简便可靠的处理方式是在完成 groupby 或 pivot_table 后直接执行 df.reset_index(),将其还原为单层扁平字段,无需去学习复杂的多轴交叉检索语法。
四、全流程实战:标准业务数据流与代码闭环
在面试笔试中,考官通常会提供两个虚拟表格(如销售明细表与用户画像表),要求候选人在30分钟内完成清洗、指标计算并输出结论。以下是典型业务处理流水线的完整流程:
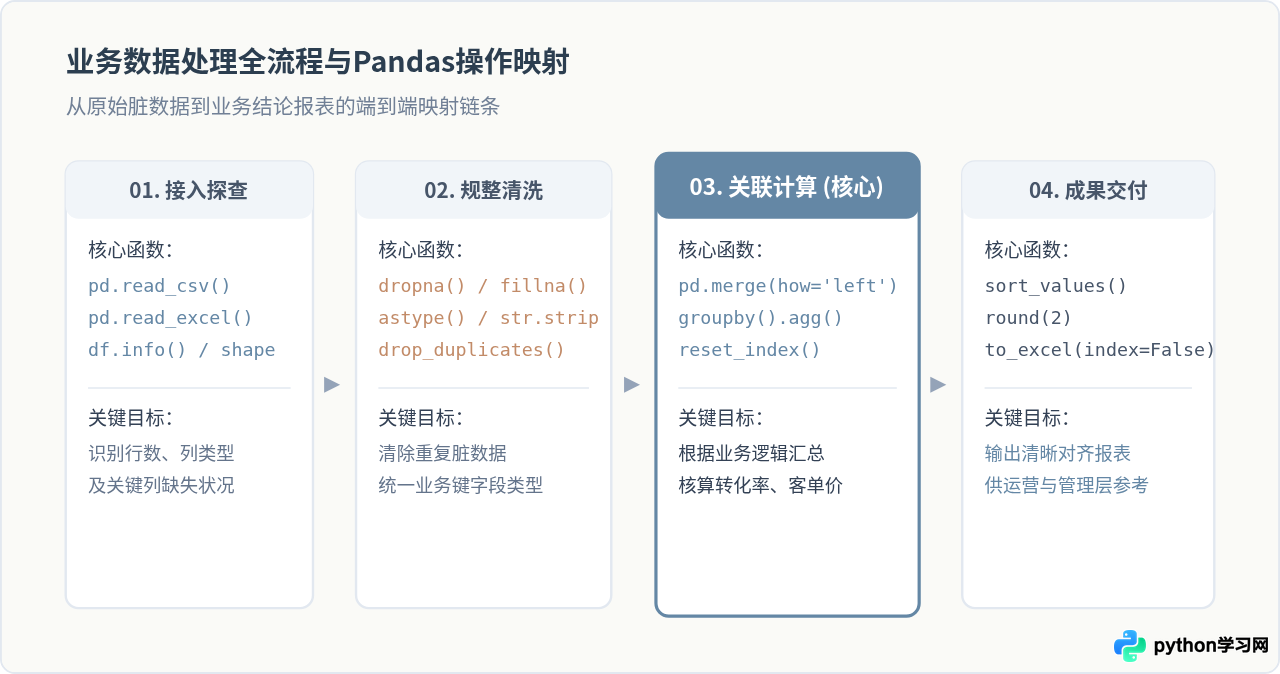
下面给出一段可直接运行的范例代码,展示如何用标准语法完成一个真实电商业绩汇总场景:
import pandas as pd

# 1. 读取订单与用户画像数据
orders = pd.read_csv('orders.csv', parse_dates=['order_time'])
users = pd.read_csv('users.csv')

# 2. 基础清洗:剔除无订单号记录,补齐缺失金额,转换用户ID格式
orders = orders.dropna(subset=['order_id'])
orders['amount'] = orders['amount'].fillna(0.0).astype(float)
orders['user_id'] = orders['user_id'].astype(str)
users['user_id'] = users['user_id'].astype(str)

# 3. 关联维度表(左连接保留全部有效订单)
merged_df = pd.merge(orders, users[['user_id', 'city_tier', 'age_group']], on='user_id', how='left')

# 4. 业务指标计算:按城市线级与年龄段统计活跃买家数、订单总量与平均客单价
report = merged_df.groupby(['city_tier', 'age_group']).agg(
    buyer_count=('user_id', 'nunique'),
    order_volume=('order_id', 'count'),
    total_gmv=('amount', 'sum')
).reset_index()

# 派生客单价指标,保留两位小数
report['avg_ticket'] = (report['total_gmv'] / report['order_volume']).round(2)

# 5. 排序并输出规整报表
report = report.sort_values(by='total_gmv', ascending=False)
report.to_excel('channel_performance_report.xlsx', index=False)
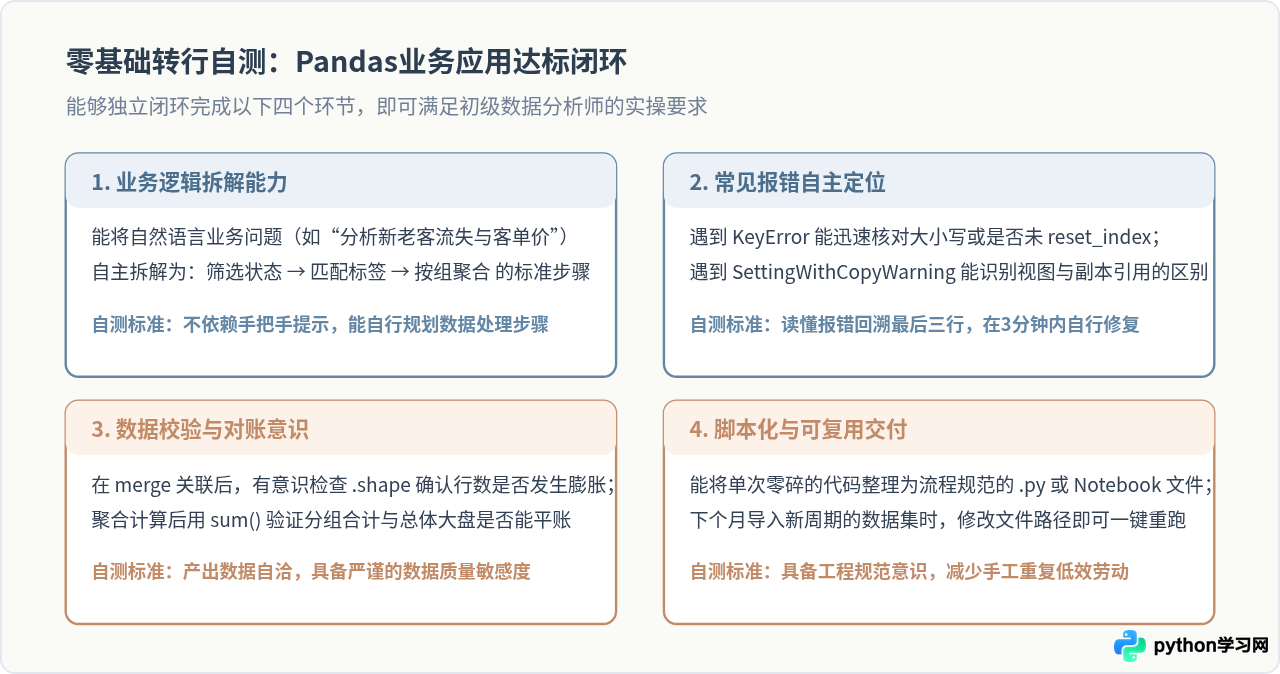
五、转行自测标准:怎样确认自己已经达到了上岗要求?
判断自己的Pandas是否达到求职标准,不需要拿官方文档的覆盖率来衡量,可以通过以下四个具体的实战动作进行验证:
常见高频面试避坑点
- 不要把循环当成切片:避免写
for index, row in df.iterrows():去做按行数值相加,这在数据量稍大时性能极差。面试官更青睐直接使用向量化运算df['total'] = df['price'] * df['qty']。 - 警惕关联后的笛卡尔积:在进行
pd.merge()之前,务必检查连接键是否在维度表中存在重复项。如果一对多变成多对多,数据行数会成倍增加,导致汇总金额翻倍。 - 理解 SettingWithCopyWarning 的本质:当对过滤后的子集进行修改时,例如
sub_df = df[df['score'] > 60]; sub_df['level'] = 'Pass',Python会弹出警告。正确做法是显式创建副本sub_df = df[df['score'] > 60].copy(),或者使用df.loc[df['score'] > 60, 'level'] = 'Pass'。
总结
对于零基础转行者,学习Pandas的终点不是成为库的文档字典,而是成为一个能够使用代码稳定解决业务问题的人。
只要熟练掌握文件的读写、基础切片、缺失值清洗、groupby + agg 聚合以及 merge 表关联这五个核心动作,并且能够在遇到具体问题时根据官方文档或搜索引擎找到对应的参数,你的Pandas水平就已经跨过了初级数据分析师的入职门槛。接下来应将更多时间投入到业务指标理解、SQL取数与数据分析思维的构建上,这才是决定转行成败的核心竞争力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









