

Python浅复制与深复制的区别及内存原理
深入解析Python中赋值、浅复制与深复制的核心区别,结合内存地址分配拓扑、嵌套可变对象引用机制与代码示例,彻底讲透底层内存原理与最佳实践。
一、变量赋值:引用绑定而非数据复制
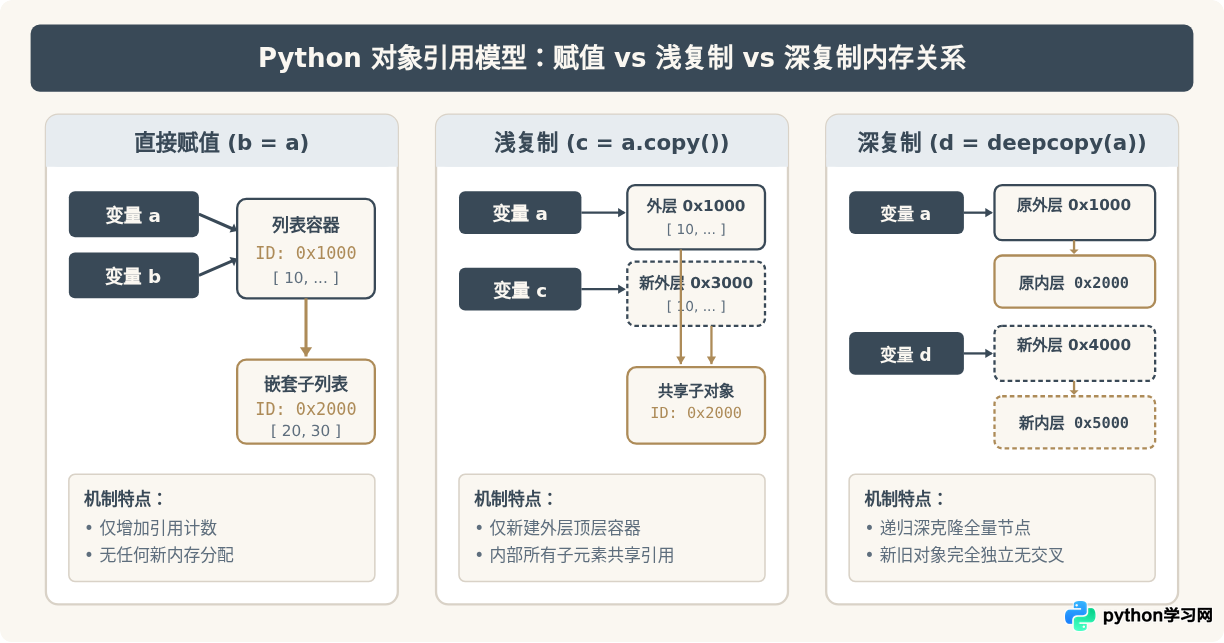
在深入探讨浅复制与深复制之前,首先要消除对“变量赋值(=)”的常见误解。在 C/C++ 等偏底层语言中,声明并赋值一个基础变量通常意味着分配一块固定内存并存入数值;而在 Python 的面向对象模型中,一切皆对象。赋值语句的右侧是在内存中创建或检索对象,左侧的变量名仅是将该符号绑定到该对象的内存地址上。
我们可以通过 Python 内置函数 id() 获取对象在运行时唯一的内存地址标识(在 CPython 实现中即为对象指针在内存中的物理地址),并通过 is 操作符验证两个变量是否指向完全相同的内存块:
# 示例 1:直接赋值的引用验证
origin = [1, [2, 3]]
assigned = origin

print(f"origin 内存地址: {id(origin)}")
print(f"assigned 内存地址: {id(assigned)}")
print(f"两者是否指向同一对象: {origin is assigned}")  # 输出: True

# 修改 assigned 会直接影响 origin
assigned.append(4)
assigned[1].append(99)
print("origin 状态:", origin)  # 输出: [1, [2, 3, 99], 4]
正如上述代码所示,直接赋值并没有产生新的列表容器,origin 与 assigned 只是贴在同一个内存块上的两张不同“标签”。无论是修改顶层元素还是嵌套内部列表,两者呈现的状态完全同步。
二、浅复制(Shallow Copy):单层隔离与嵌套共享
浅复制是指创建一个新的复合对象(例如列表、字典或集合),随后将原对象中所包含元素的引用逐一填充到这个新容器中。
1. 浅复制的常见实现方式
在日常开发中,浅复制有多种常见写法:
- 工厂方法或类型构造器:
list(origin)、dict(origin)、set(origin)。 - 切片操作:对列表或元组使用完整切片
origin[:]。 - 对象内建方法:例如列表的
origin.copy()或字典的origin.copy()。 - 标准库 copy 模块:
import copy; copy.copy(origin)。
2. 浅复制的内存表现与行为边界
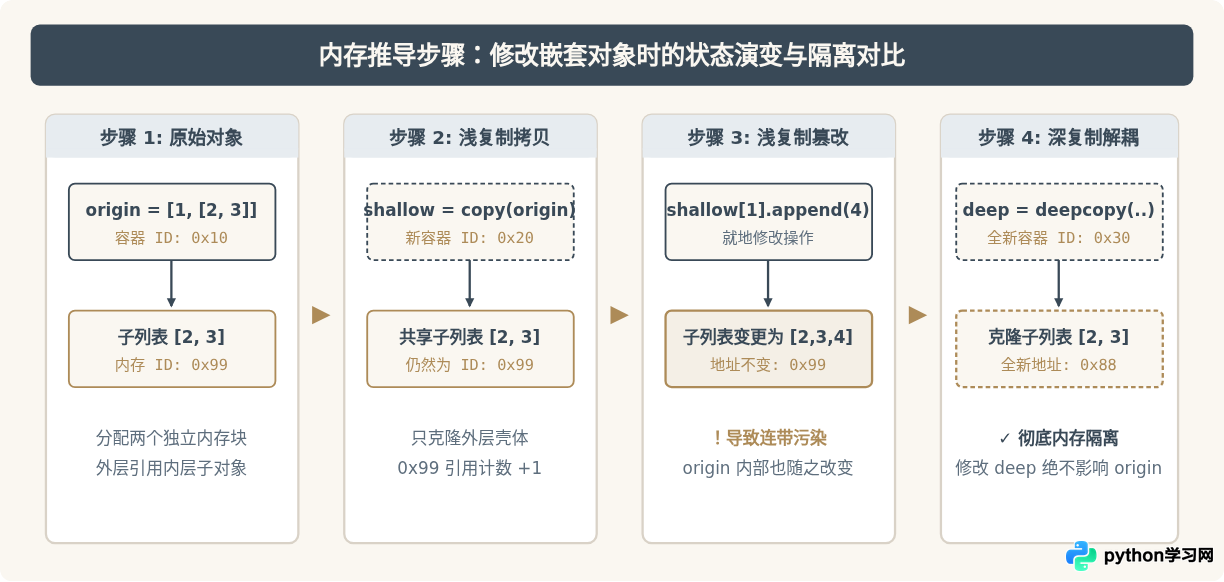
当数据仅包含不可变类型(如整数、浮点数、字符串、元组)时,浅复制表现得如同“完全独立”,因为不可变对象无法就地修改;任何对元素的赋值操作(如 c[0] = 99)本质上是将新容器中第 0 个槽位的指针改指向一个新对象,不会对原容器产生影响。
然而,一旦数据结构中存在嵌套可变对象(例如列表中包含子列表、字典等),隐患就会显现:
import copy

# 包含嵌套可变对象的列表
source = ["Alpha", [10, 20]]
shallow = source.copy()

# 验证外层容器与内部元素的地址
print("source 容器 ID:", id(source))
print("shallow 容器 ID:", id(shallow))           # 与 source 不同,为独立容器
print("子列表地址相同:", id(source[1]) == id(shallow[1]))  # 输出: True,共享内存

# 操作 1:修改顶层元素(仅重定向指针)
shallow[0] = "Beta"
print("source[0]:", source[0])    # 保持 "Alpha" 不变
print("shallow[0]:", shallow[0])  # 变为 "Beta"

# 操作 2:修改嵌套可变子对象(原地修改共享内存)
shallow[1].append(30)
print("source[1]:", source[1])    # 同步变为 [10, 20, 30]!
print("shallow[1]:", shallow[1]) # 变为 [10, 20, 30]三、深复制(Deep Copy):递归克隆与内存解耦
深复制(Deep Copy)会完整复制对象及其引用的所有子对象。它通过递归遍历对象图,为被复制对象内部的每一个可变节点都开辟专属的新内存空间,从而使得新对象与原对象彻底解耦。
在 Python 中,深复制主要通过标准库模块 copy 的 deepcopy() 函数实现:
import copy

source = ["Alpha", [10, 20]]
deep = copy.deepcopy(source)

# 验证内存解耦
print("子列表地址是否相同:", id(source[1]) == id(deep[1]))  # 输出: False,完全独立

# 修改 deep 的嵌套对象
deep[1].append(999)
print("source[1]:", source[1])  # 输出: [10, 20],丝毫未受影响
print("deep[1]:", deep[1])      # 输出: [10, 20, 999]
深复制的底层推导步骤与运行机制
copy.deepcopy() 的推导逻辑绝非简单的嵌套循环,其核心由两个重要机制支撑:
-
递归分发机制:检测对象的
__deepcopy__()协议,若未自定义则按数据类型递归构建(从外层容器向内探查每一层属性或索引元素)。 -
备忘录字典(Memo 字典):为了防止循环引用(例如对象 A 中包含对 A 自身的引用,导致无穷递归爆栈),
deepcopy()内部维护了一个memo = {}字典,以id(obj)为键记录已被复制的对象。当遇到已在 memo 中的对象时,直接返回已有克隆体的引用。
四、工程实战选择:何时使用哪种复制?
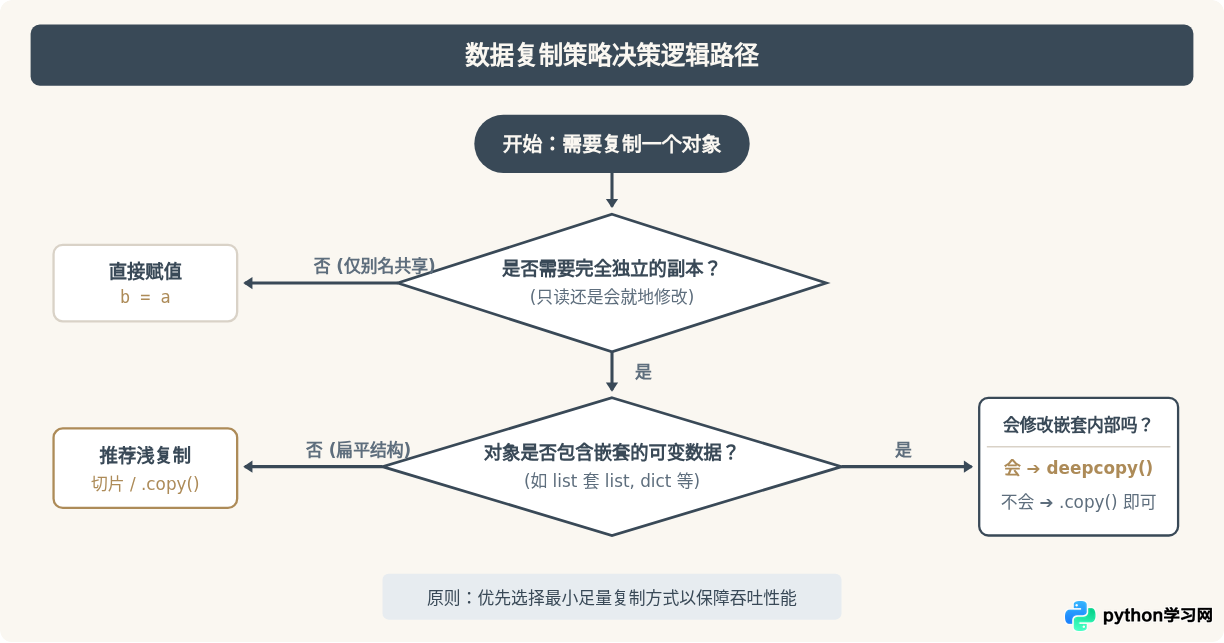
在实际软件架构与数据处理流程中,不加思索地滥用 deepcopy() 会引入显著的性能损耗,因为递归遍历对象树并构建 memo 字典具有较大开销。选择复制方案应遵循明确的判定逻辑:
五、不可变对象的特殊优化与深复制陷阱
在深入研究 Python 源码时,会发现一些看起来与上述理论看似矛盾的“特例”。这些特例实际上是 CPython 解释器为了节约内存而设计的优化机制:
1. 不可变对象的“短路”机制
元组(tuple)、字符串(str)、整数(int)以及 frozenset 是不可变的。因为无论如何都不能在原地改变它们的内容,所以对其进行浅复制、甚至深复制时,Python 往往直接返回原对象的引用,根本不生成新对象:
import copy

t1 = (1, 2, 3)
t2 = copy.copy(t1)
t3 = copy.deepcopy(t1)

print(t1 is t2)  # 输出: True!并没有创建新元组
print(t1 is t3)  # 输出: True!深复制同样返回自身

# 注意:但如果元组内部包含可变元素,深复制就会真正递归克隆!
t_complex = (1, [2, 3])
t_deep = copy.deepcopy(t_complex)
print(t_complex is t_deep)        # 输出: False,此时克隆了新元组
print(t_complex[1] is t_deep[1])  # 输出: False,子列表被克隆
2. 自定义类的复制重载协议
当业务需要精细控制类的拷贝行为时,可通过在类中实现 __copy__() 和 __deepcopy__(self, memo) 特殊方法来定制:
import copy

class ConnectionManager:
    def __init__(self, host, connection_cache=None):
        self.host = host
        self.cache = connection_cache or []

    def __deepcopy__(self, memo):
        # 避免克隆网络套接字等不可复制资源,定制深复制逻辑
        new_obj = ConnectionManager(self.host)
        memo[id(self)] = new_obj
        new_obj.cache = copy.deepcopy(self.cache, memo)
        return new_obj
六、全景对比总结
为了便于在工程实战中快速对比,我们将三种对象处理机制的维度特征系统总结如下:
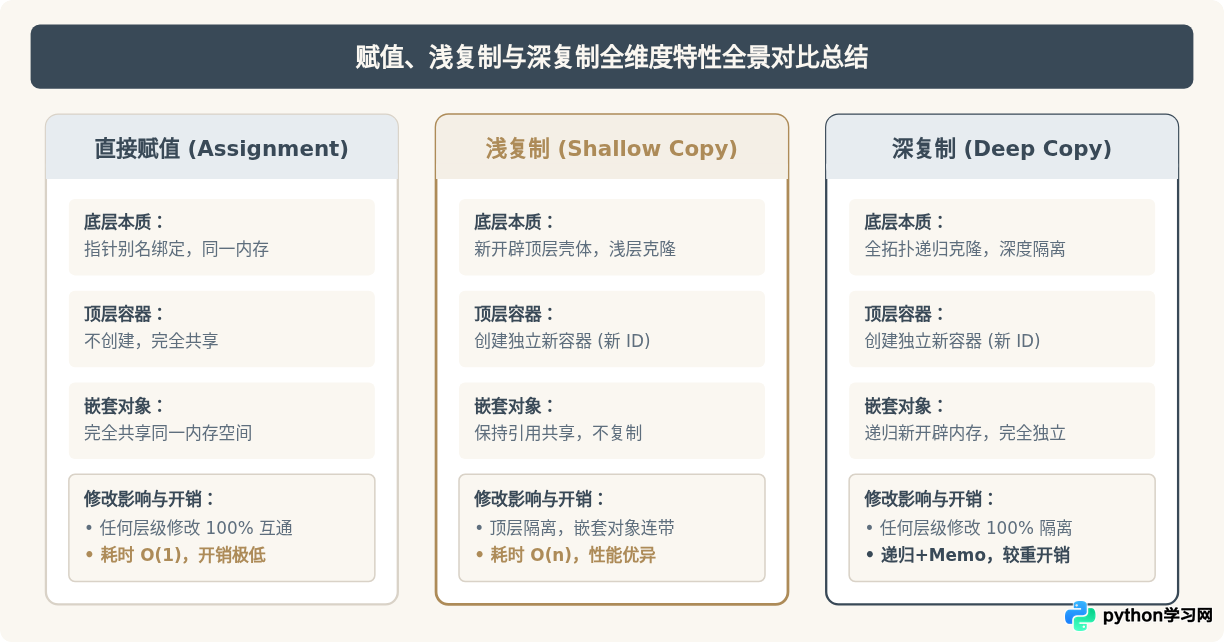
| 操作方式 | 典型语法 | 外层容器 | 嵌套可变子对象 | 修改嵌套子对象影响 | 使用建议 |
|---|---|---|---|---|---|
| 直接赋值 | b = a |
同一对象 | 同一对象 | 完全同步互相影响 | 仅需要为已有对象增加别名时使用 |
| 浅复制 | a.copy() / a[:] |
独立新容器 | 共享同一引用 | 连带影响原对象 | 一维或嵌套元素全为不可变类型时优先使用 |
| 深复制 | copy.deepcopy(a) |
独立新容器 | 递归克隆全新对象 | 完全独立,互不影响 | 复杂嵌套结构需要彻底隔离、防御性拷贝时使用 |
综上所述,Python 的复制机制紧密贴合其对象与指针模型。在编写业务逻辑时,切勿默认把 copy.deepcopy() 当成万能解药,而应根据数据结构深度和读写特性选择最贴合实际性能与内存需求的方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









