

Python类继承中双下划线私有变量的访问限制与名称修饰
深入解析Python类继承中双下划线私有变量的访问限制本质、名称修饰(Name Mangling)机制、底层命名空间字典存储及工程实践中的选型原则。
在 Python 面向对象编程中,以双下划线开头的变量(例如 __name)常被误认为是严格的私有成员。当子类继承父类并尝试直接读取或修改父类的双下划线属性时,Python 解释器会抛出 AttributeError。这种访问限制并不是语言级别的信息隐藏或安全机制,而是由底层的名称修饰(Name Mangling)引发的静态改写规则。本文将围绕名称修饰的运作机制、类继承体系下的访问限制与寻址冲突、该机制的真正设计初衷,以及在实际工程开发中的设计选型展开深入讲解。
一、双下划线变量的本质:名称修饰(Name Mangling)机制
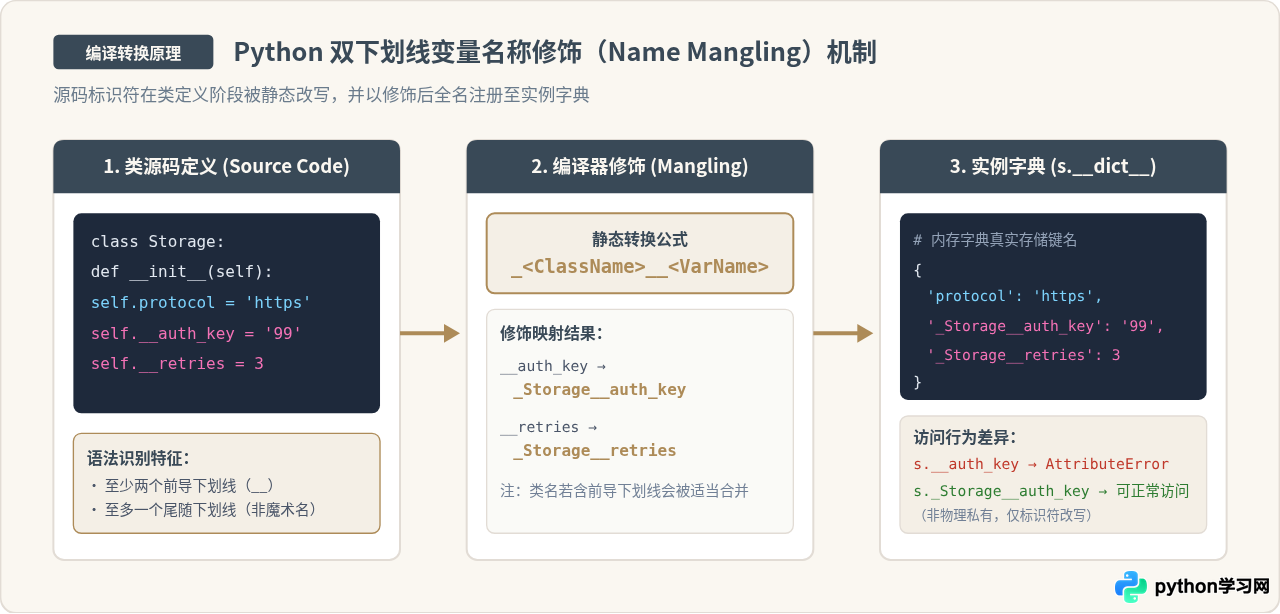
在 Python 中,如果一个标识符以至少两个下划线开头,且至多以一个下划线结尾(形如 __var),解释器在编译生成字节码时,会自动将该标识符改写为带有当前类名前缀的新格式:_类名__变量名。这一过程完全由编译器静态完成,并不依赖运行时的动态计算。
例如,在一个名为 Storage 的类中定义 self.__secret_token = "auth_9981",经过编译后,该属性在实例的属性字典(__dict__)中实际保存的键名是 _Storage__secret_token。当我们在该类的成员方法中书写 self.__secret_token 时,编译器同样会将其转换为读取 self._Storage__secret_token。
class Storage:
    def __init__(self, key: str):
        self.public_id = "node_01"
        self.__secret_token = key

    def get_token(self) -> str:
        # 类内访问:被编译器自动转换为 self._Storage__secret_token
        return self.__secret_token

s = Storage("auth_9981")
print(s.__dict__)
# 输出示例:{'public_id': 'node_01', '_Storage__secret_token': 'auth_9981'}
如果在类外部直接调用 s.__secret_token,解释器不会对外部语句做针对 Storage 类的名称修饰,它会按字面名称在 s.__dict__ 中查找 __secret_token。因为字典中根本没有这个键,所以会直接触发 AttributeError: 'Storage' object has no attribute '__secret_token'。但是,若在外部直接调用 s._Storage__secret_token,就可以直接读写该变量。这直接证明了双下划线并不是真正的不可访问,而是通过重命名增加了意外访问的阻力。
二、类继承场景下的访问限制与 AttributeError 溯源
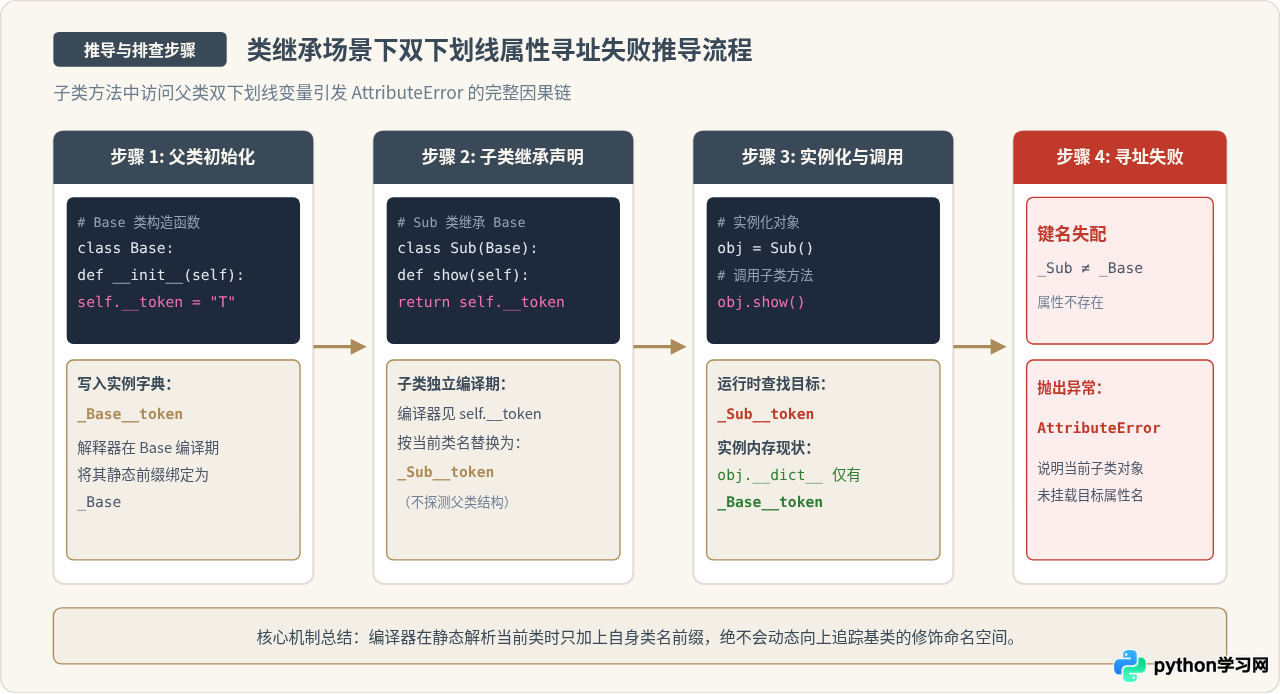
理解了名称修饰发生于编译期之后,类继承中双下划线变量的访问限制问题就一目了然了。当派生类继承基类时,如果派生类在自己的成员方法中尝试通过 self.__attr 访问基类的同名双下划线属性,就会产生名字不匹配的问题。
来看一个典型的继承代码示例:
class DatabaseConnector:
    def __init__(self, host: str, token: str):
        self.host = host
        self.__auth_token = token  # 修饰为: _DatabaseConnector__auth_token

    def verify(self) -> bool:
        # 父类内部访问:寻找 _DatabaseConnector__auth_token,成功匹配
        return bool(self.__auth_token)

class MysqlConnector(DatabaseConnector):
    def display_auth(self):
        # 子类内部访问:被修饰为 self._MysqlConnector__auth_token!
        print(f"Connecting with token: {self.__auth_token}")

conn = MysqlConnector("192.168.1.10", "secret_pwd")
print(conn.verify())  # 输出 True,父类方法访问正常

# 调用子类方法抛出异常:
conn.display_auth()AttributeError: 'MysqlConnector' object has no attribute '_MysqlConnector__auth_token'
这个报错清晰地印证了底层机制:
- 父类初始化的注册行为:在实例化
MysqlConnector时,调用了父类的__init__。父类代码是在DatabaseConnector作用域中编译的,向实例属性字典中写入的键是_DatabaseConnector__auth_token。 - 子类编译期的改写行为:在
MysqlConnector类的定义体中,子类方法display_auth包含表达式self.__auth_token。编译器在编译MysqlConnector时,只知道当前正在编译的类是MysqlConnector,因此无条件地将该属性调用替换为self._MysqlConnector__auth_token。 - 属性寻址冲突:当调用
conn.display_auth()时,Python 在实例字典和类属性中查找_MysqlConnector__auth_token。由于实例字典中实际只存在_DatabaseConnector__auth_token,找不到对应属性,于是直接抛出AttributeError。
三、双下划线设计的真实意图:防止意外覆盖(Accidental Overriding)
许多初学者容易产生疑问:既然 Python 尊崇“大家都是成年人(We are all consenting adults here)”的开放哲学,为什么还要设计一套看似制造障碍的双下划线修饰机制?
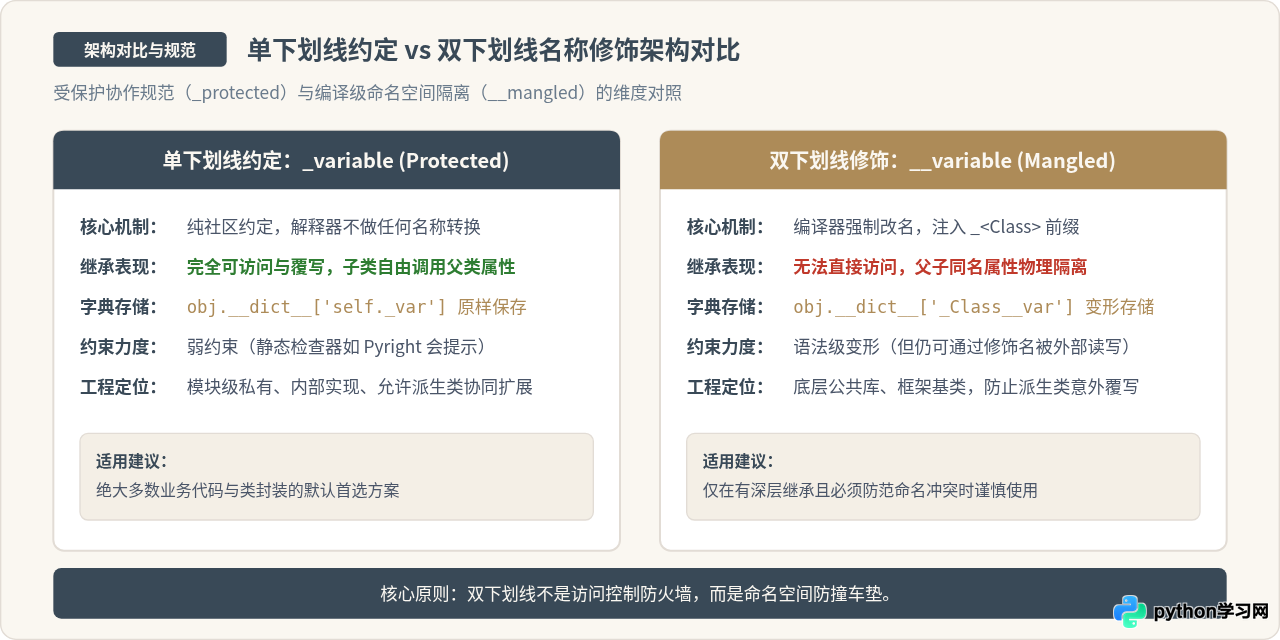
Python 之父 Guido van Rossum 设计双下划线的主要目标并不是防止外部代码读取数据,而是为了防止子类在无意间覆盖基类内部使用的私有属性或辅助方法。在大规模继承体系或第三方类库开发中,子类作者很可能不知道基类内部有哪些私有实现,若子类恰巧定义了一个同名属性,就可能破坏基类的核心逻辑。
通过以下没有名称修饰的场景对比,可以清楚看出两者的差异:
# 假设使用普通单下划线或普通变量:
class ServerFramework:
    def __init__(self):
        self.status = "INITIALIZING"
        self._setup()

    def _setup(self):
        # 基类期待的初始化流程
        print("Framework internal setup completed.")

class UserApplication(ServerFramework):
    def _setup(self):
        # 子类无意中定义了同名的业务方法
        print("User custom application startup.")

# 实例化子类:
app = UserApplication()
# 输出:User custom application startup.
# 基类的内部 setup 彻底被覆写,基类自身的初始化链条可能因此崩溃!
而如果基类使用双下划线 self.__setup(),基类内部调用的是 self._ServerFramework__setup();即使子类也定义了 def __setup(self):,在子类中会被修饰为 _UserApplication__setup()。在运行时,这两个方法在实例命名空间中互不干扰,基类的内部流程能够得到安全保障。
四、常见误区与工程实践避坑指南
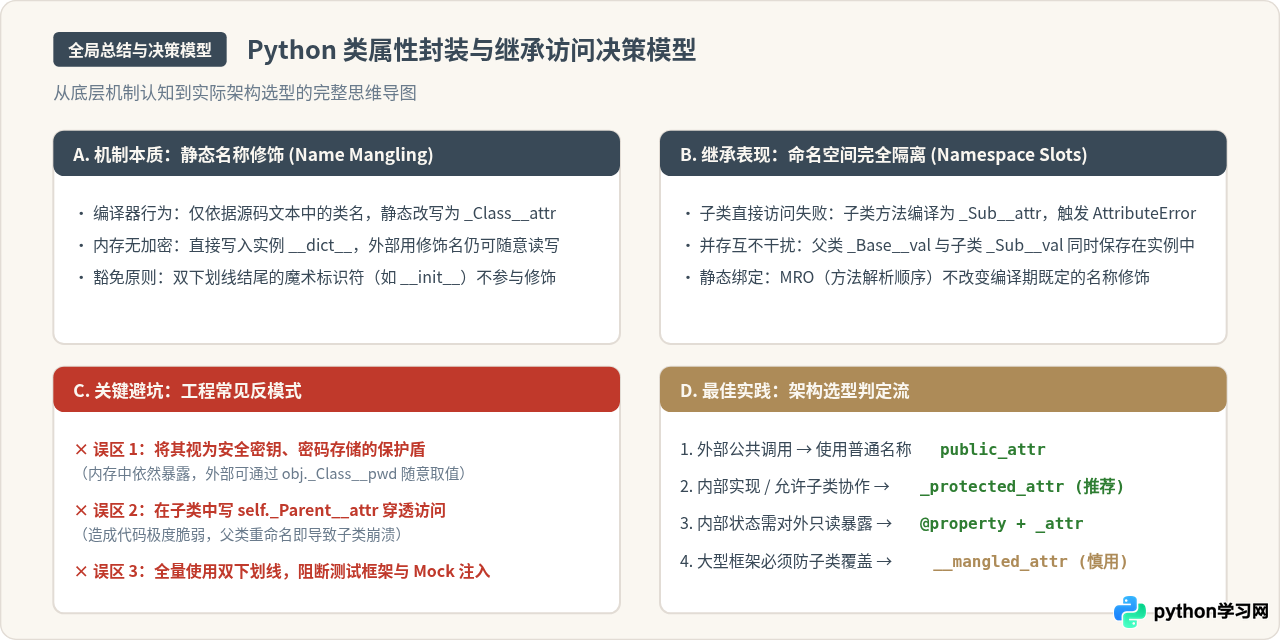
1. 误区一:把双下划线当成数据安全保密手段
双下划线修饰的属性在内存中仍然是明文存在的,只要知道类名,外部依然可以通过 instance._ClassName__variable 直接读取甚至重新赋值。它没有任何加解密、权限隔离或访问阻断能力。任何针对安全密钥、用户密码的保护,都必须依赖系统级的加密库(如 hashlib、cryptography)或安全保管方案,切勿依赖 Python 的语法特性来防范数据泄漏。
2. 误区二:在普通业务类中泛滥使用双下划线
在日常业务开发中滥用双下划线会带来许多负面影响:
- 阻碍子类合理扩展:子类开发者无法在必要时重用或调整基类状态,甚至被迫通过
self._Base__token这类脆弱的反模式代码进行硬编码穿透,一旦基类重构类名,子类代码立刻全部损坏。 - 增加单元测试与 Mock 难度:测试框架很难便捷地替换私有成员,增加了测试代码与内部修饰名称的强耦合。
- 破坏序列化与调试:部分基于反射的 ORM、数据校验器(如 Pydantic、dataclasses)或 JSON/Pickle 序列化工具,在处理修饰名称时可能出现异常或冗余字段。
3. 正确的工程选型与替代方案
在日常 Python 项目设计中,推荐遵循以下规则:
| 属性类型 | 命名规范 | 设计意图与适用场景 |
|---|---|---|
| 公共属性 | var_name |
作为公开 API 契约,供外部自由读取和调用,需保持稳定向下兼容。 |
| 内部/受保护属性 | _var_name |
日常首选。标明为内部实现细节,外部请勿直接调用;但子类可完全继承、访问和覆盖。 |
| 受控只读属性 | 结合 @property |
使用 _var_name 存储实际数据,对外暴露 @property 装饰的只读方法,兼顾安全与简洁。 |
| 防覆盖私有属性 | __var_name |
极少使用。仅在开发具有复杂多层继承架构的基础类库时,用于隔离基类的内部核心逻辑。 |
五、总结
Python 类继承中双下划线私有变量的访问限制,核心在于编译器执行的名称修饰(Name Mangling)。它在编译期将 __var 改写为 _ClassName__var,使得子类的方法在编译时寻找的是带有子类名前缀的键,与父类初始化写入的带有父类名前缀的键产生失配,从而抛出 AttributeError。
这项机制的设计目标是防意外覆盖而非数据隐私保护。在日常工程架构中,应当首选单下划线 _var 作为内部封装的沟通约定,配合 @property 暴露只读接口;仅在开发需要防范派生类命名冲突的基础框架时,才合理使用双下划线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









