

自学Python需要学哪些库?数据分析与Web开发的基础库推荐
针对自学Python的进阶瓶颈,梳理数据分析与Web开发两大主流方向的核心基础库。从NumPy、Pandas、Matplotlib到FastAPI、Flask、Django与SQLAlchemy,提供技术选型依据、实战示例、工程化虚拟环境管理标准与阶段检验里程碑。
NumPy(底层矢量计算)→ Pandas(数据清洗与聚合透视)→ Matplotlib / Seaborn(统计图表可视化);若主攻Web服务与工程交付,核心组合为 FastAPI(现代高性能接口)或 Flask(轻量微框架),搭配 SQLAlchemy(数据库ORM映射),需要后台大包大揽时再选 Django。全过程必须在隔离的 venv 虚拟环境中由真实需求驱动演练。
一、学习第三方库的前提与选型逻辑
自学编程最常见的误区是刚看完语法基础视频,就开始疯狂收集诸如“必学的30个Python库”清单,并依次在全局终端敲下 pip install。这种脱离业务场景的记忆不仅难以持久,更会在遇到具体需求时无从下手。
在决定引入任何第三方库之前,你需要完成两项硬性自检:
- 语法基准验收:能否熟练运用列表推导式、字典键值处理、函数的
*args/**kwargs参数传递、try...except异常捕获机制,以及理解模块的import原理。若语法基础尚有漏洞,调用第三方库时往往会被报错信息带偏。 - 单一方向决策:数据分析和 Web 开发解决的是两类完全不同的工程问题。前者围绕静态/离线数据的输入、过滤、分组、统计与可视化洞见展开;后者围绕网络请求响应、状态持久化、用户权限、并发吞吐与业务交付运转。自学初期务必单轨深耕,严禁在同一个月内既学 Pandas 处理表格又学 Django 写网页。
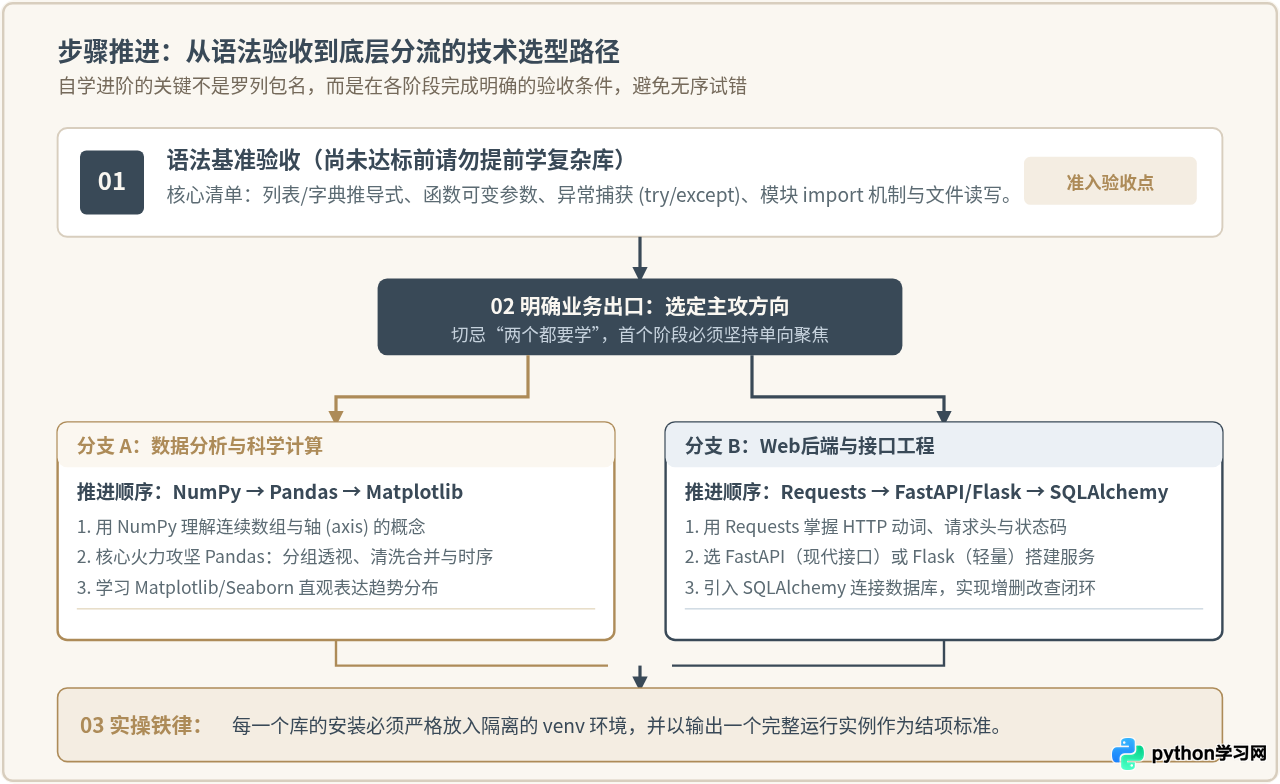
确立了学习方向后,每一个技术栈都应按照“底层结构 → 核心高频操作 → 结果交付”的递进逻辑逐层构建,而不是在同一层级横向堆砌同类工具。
二、数据分析方向核心基础库推荐与协同实战
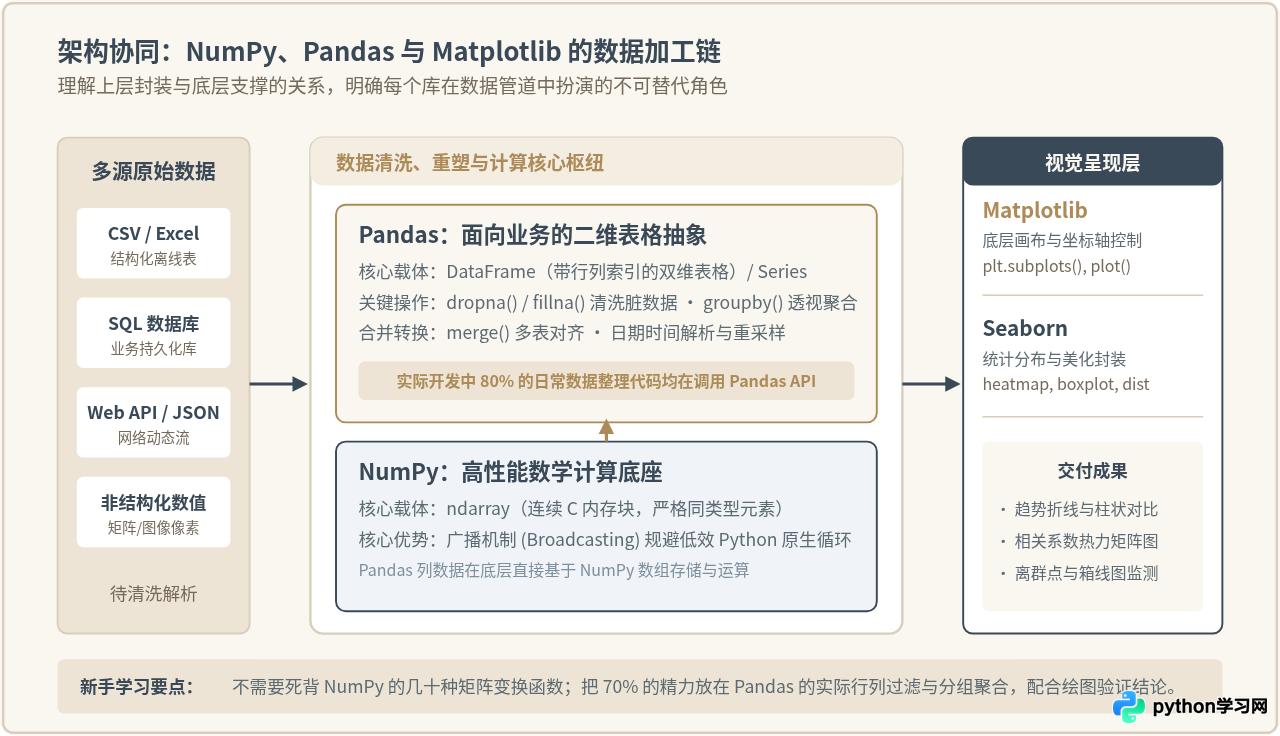
数据分析领域的工具链结构极其清晰,工业界经过多年沉淀已形成标准分工:NumPy 提供底层算力底座,Pandas 提供二维表格数据重塑能力,Matplotlib 与 Seaborn 负责结论的视觉化表达。三者层层嵌套、相互协作。
1. NumPy:不可或缺的高性能数值计算底座
Python 原生的 list 虽然灵活,但底层存储的是对象的指针引用,在遍历千万级数值时速度极慢。NumPy 引入了连续存储在 C 内存块中的多维数组 ndarray,通过矢量化运算(Vectorization)和广播机制(Broadcasting),彻底消除显式 for 循环,运算效率比原生循环高出数十倍甚至上百倍。
对于初学者,无需背诵线性代数的高级变换矩阵函数,重点掌握数组创建、切片索引、轴(axis)的统计聚合即可。
# 示例环境:Python 3.9+,已激活虚拟环境并安装 numpy
import numpy as np

# 创建二维数组(模拟 3 个销售员在 4 个季度的销售额,单位:万元)
sales_data = np.array([
    [12.5, 15.0, 18.2, 22.0],
    [8.0,  10.5, 11.0, 14.2],
    [20.1, 23.4, 25.0, 31.5]
])

# 矢量化计算:统一上浮 10% 考核目标(广播运算)
targets = sales_data * 1.1

# 按列(axis=0)求季度全员总销售额,按行(axis=1)求个人年度总额
quarter_totals = np.sum(sales_data, axis=0)
person_totals = np.sum(sales_data, axis=1)

print("各季度全员总额:", quarter_totals)
print("各销售年度总额:", person_totals)各销售年度总额: [67.7 43.7 100.0]
2. Pandas:日常业务数据分析与清洗的绝对主力
如果说 NumPy 属于偏底层的数学引擎,那么 Pandas 就是实际业务开发中耗时最多的核心战场。现实中的业务数据往往是残缺不全、格式混杂的(例如带有空值的 CSV、混杂空格的列名、不规范的日期字符串)。
Pandas 的核心数据结构是 DataFrame(表格)与 Series(单列)。你需要核心攻克以下四类操作:
- 数据导入与导出:
pd.read_csv()、pd.read_excel(),以及向文件/SQL输出。 - 脏数据清洗:
dropna()剔除空值、fillna()缺失值填充、drop_duplicates()重复项清除。 - 布尔过滤与字段衍生:利用条件筛选满足指标的行,并计算生成新增业务列。
- 透视与分组聚合:
groupby()结合agg()实现多维度交叉分析。
# 示例环境:Python 3.9+,已安装 pandas
import pandas as pd

# 构造真实业务常见的不完整订单样本
raw_records = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "city": ["北京", "上海", "北京", None, "上海"],
    "category": ["数码", "家居", "数码", "食品", "数码"],
    "amount": [3200, 450, 1800, 120, 5600]
}
df = pd.DataFrame(raw_records)

# 步骤 1:处理缺失城市(填充默认值或丢弃无效订单)
df["city"] = df["city"].fillna("未知区域")

# 步骤 2:过滤金额大于 300 的有效订单,并按城市与品类分组聚合
summary = (
    df[df["amount"] > 300]
    .groupby(["city", "category"])["amount"]
    .agg(["count", "sum"])
    .rename(columns={"count": "订单量", "sum": "总销售额"})
)
print(summary)city category
上海 家居 1 450
数码 1 5600
北京 数码 2 5000
for index, row in df.iterrows(): 来做逐行数值判断和更新。这完全放弃了 Pandas 底层的 C 数组加速,处理 10 万行数据可能耗时数分钟。务必使用矢量化运算(如 df['amount'] * 0.9)或布尔切片,耗时通常只需几毫秒。
3. Matplotlib 与 Seaborn:结论的可视化表达
数据清洗完后,必须把数值结果转化为图表。Matplotlib 是 Python 绘图的基石库,它直接操作画布(Figure)和坐标轴(Axes),支持像素级精确调节;而 Seaborn 是基于 Matplotlib 的高级封装库,自带现代美化配色方案,专攻箱线图、热力图、小提琴图等统计图形。
建议以 Matplotlib 面向对象 API(fig, ax = plt.subplots()) 入手,掌握折线图、柱状图、直方图的绘制及中文字体设置,后续再调用 Seaborn 快速生成探索性分析图。
三、Web开发方向核心基础库推荐与框架抉择
与数据分析不同,Web 开发的核心关注点在于网络通信协定、API 路由契约、数据持久化存储与系统稳定性。当前 Python Web 生态中,三大主流框架各有清晰的适用边界。
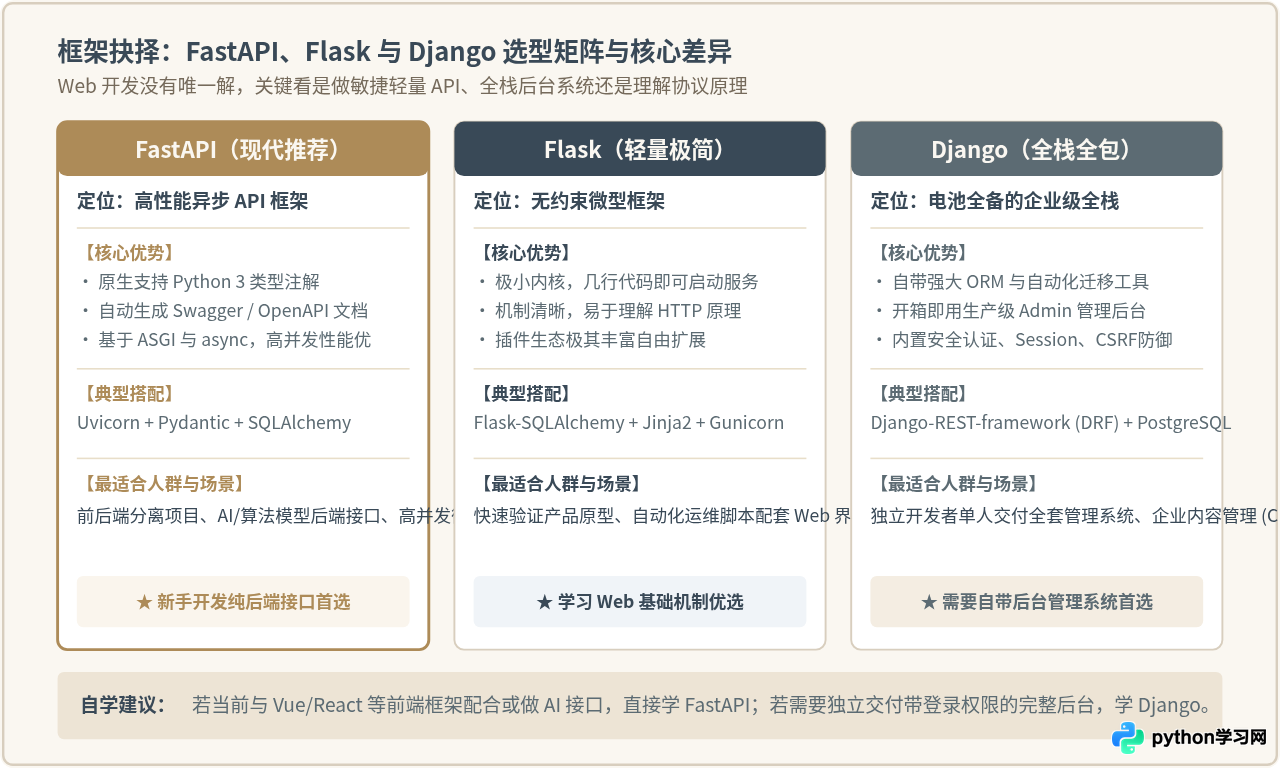
| 框架名称 | 核心定位与哲学 | 并发模型 | ORM与数据绑定 | 最佳自学建议场景 |
|---|---|---|---|---|
| FastAPI | 现代异步、类型安全、自动文档 | ASGI 原生异步 | 解耦,主流配合 SQLAlchemy | 前后端分离、AI/大模型后端接口、现代云原生微服务(首选) |
| Flask | 轻量微内核、自由组合插件 | WSGI 同步为主 | 自由选用插件(Flask-SQLAlchemy) | 学习 HTTP 基础原理、写轻量脚本管理界面、极简验证原型 |
| Django | “电池全备”全栈大厂标准 | WSGI / 逐步支持 ASGI | 内置高度封装的专属 ORM | 单人快速交付企业管理系统、带复杂用户权限与后台的内容平台 |
1. 为什么当前推荐优先学习 FastAPI?
近几年由于前后端分离模式成为主流,加上 AI/大语言模型服务的爆发,FastAPI 迅速成为行业热门。它充分利用了 Python 3.6+ 的类型注解(Type Hints)机制,并通过 Pydantic 在底层进行强类型参数校验,启动后即可自动生成交互式 /docs(Swagger UI)调试文档。
下面的示例展示了一个标准 FastAPI 接口的编写方式。无需手动编写繁琐的 JSON 解析与校验逻辑:
# 示例环境:Python 3.9+,已安装 fastapi uvicorn pydantic
# 文件名:main.py
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="商品库存管理微服务")

# 定义入参数据契约(Pydantic 模型保障类型与边界安全)
class ItemCreate(BaseModel):
    name: str = Field(..., min_length=2, max_length=50, description="商品名称")
    price: float = Field(..., gt=0, description="单价必须大于0")
    stock: int = Field(default=0, ge=0, description="库存非负")

# 内存临时存储模拟数据库
items_db = {}

# POST 接口:创建商品
@app.post("/items/", status_code=201)
def create_item(item: ItemCreate):
    item_id = len(items_db) + 1
    items_db[item_id] = item.dict()
    return {"item_id": item_id, "data": items_db[item_id]}

# GET 接口:查询商品
@app.get("/items/{item_id}")
def read_item(item_id: int):
    if item_id not in items_db:
        raise HTTPException(status_code=404, detail="未找到对应商品")
    return items_db[item_id]

# 执行运行命令:uvicorn main:app --reloadINFO: Started reloader process [PID 14208]
* 访问 http://127.0.0.1:8000/docs 即可直接在网页端交互测试所有 API 并查看类型定义
2. 支撑库推荐:Requests 与 SQLAlchemy
在 Web 工程开发中,光有框架本身是不够的,以下两个支持库是实际项目的标配:
- Requests:Python 生态中最优雅的 HTTP 客户端库。掌握它能够让你迅速理解 GET/POST 请求体、Headers、Cookie、JSON 序列化与状态码。无论做微服务间调用、第三方支付对接还是爬虫数据抓取,都是第一基础库。
- SQLAlchemy:Python 领域工业级的对象关系映射(ORM)与 SQL 工具集。它让你用操作 Python 类和对象的方式来安全读写 SQLite、MySQL 或 PostgreSQL,避免拼接低效且易产生 SQL 注入风险的裸字符串。
四、自学避免踩坑的操作步骤与包管理规范
很多自学者在学习库的第一周就遭遇失败,原因往往不是代码逻辑写错,而是环境被搞崩了:在全局 Python 环境下安装了多个不同版本的库,导致依赖冲突,或者安装完后在 IDE 中提示找不到模块。
为了保障项目纯净、可复现,必须严格执行虚拟环境与依赖管理四步操作规范:
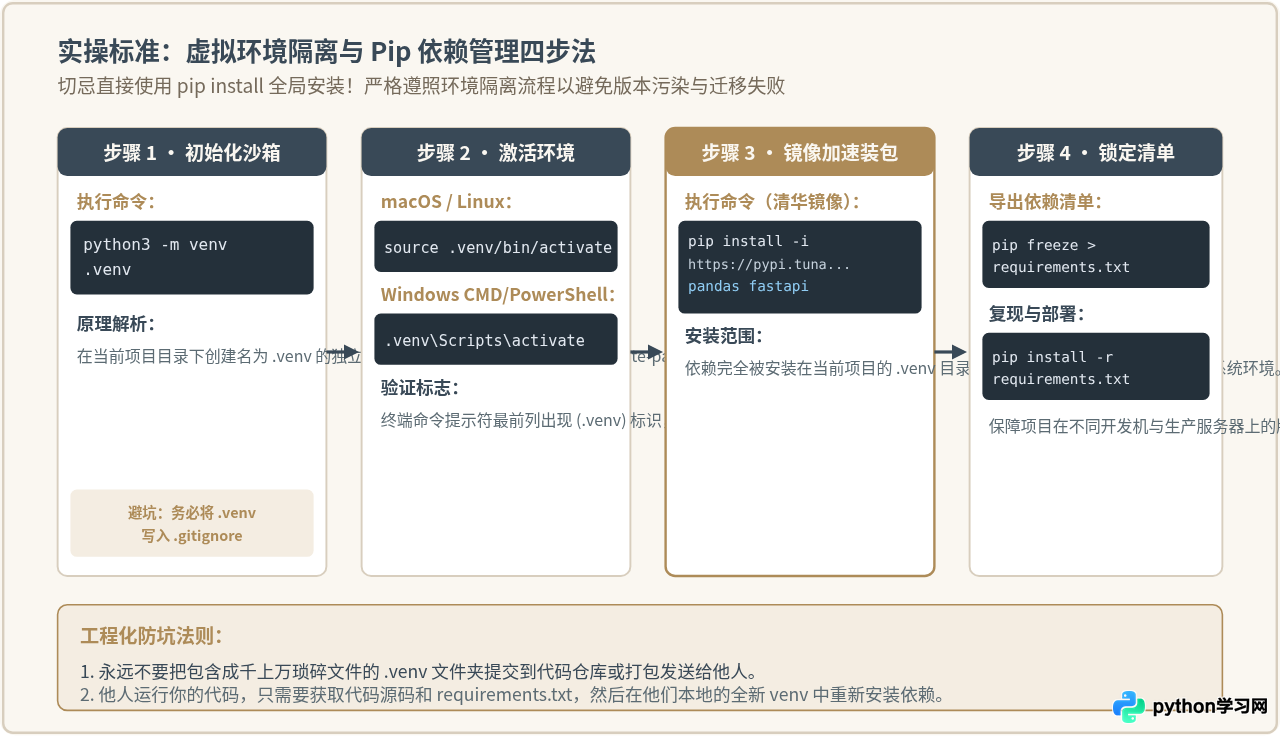
标准工程化实操流程
-
新建独立项目目录并创建虚拟沙箱:
# 在终端中进入你的工作目录 mkdir my_project && cd my_project # 使用 Python 自带的 venv 模块初始化虚拟环境目录 .venv python3 -m venv .venv -
激活虚拟沙箱(改变当前终端的 PATH 环境变量):
# macOS / Linux 平台执行:
source .venv/bin/activate

# Windows CMD / PowerShell 平台执行:
.venv\Scriptsctivate
激活成功后,命令提示符左侧会出现
(.venv)字样。此时运行的python和pip均指向沙箱内部。 -
配置国内镜像源并按需安装:
官方 PyPI 服务器位于海外,直接下载大型包(如 Pandas、NumPy)容易超时中断,建议使用国内清华或阿里镜像源加速:
# 单次安装加速指定清华镜像 pip install -i https://pypi.tuna.tsinghua.edu.cn/simple pandas fastapi uvicorn -
固化版本清单,便于协同与部署:
# 导出当前项目精确依赖到文本文件
pip freeze > requirements.txt

# 在他人电脑或服务器上只需一键复现全部依赖:
pip install -r requirements.txt
.venv 目录内包含数千个具体系统下的二进制包与可执行脚本,体积庞大且跨操作系统不可直接移植。使用 Git 时必须在项目根目录的 .gitignore 中加入 .venv/,仓库中只上传业务代码与 requirements.txt。
五、总结与学习路线落地指南
自学 Python 第三方库的终极检验标准,不是你记住了多少个 API 名称,而是你能否调用这些库,交付一个有完整输入、逻辑处理和明确输出的小项目。
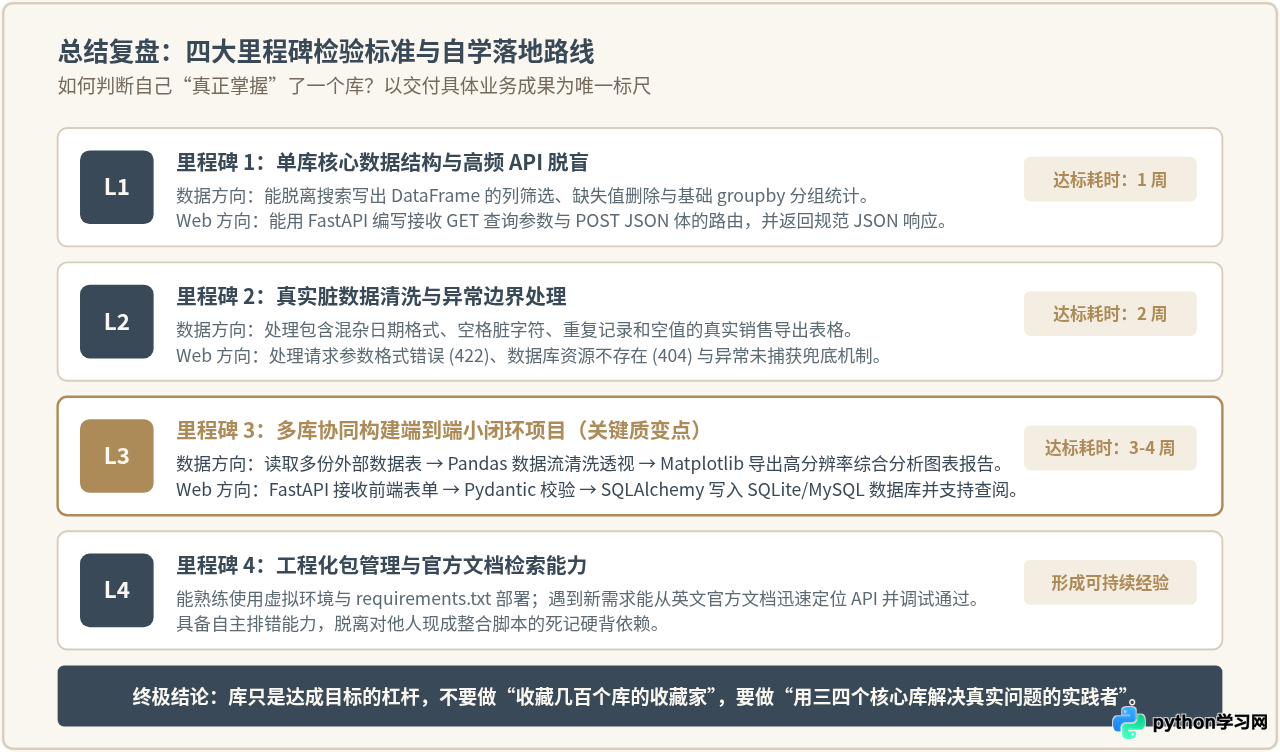
四大里程碑交付清单(自检指南)
- 里程碑 L1(单库核心 API 脱盲):能离开搜索引擎写出基本的数据结构处理。例如用 Pandas 读出 CSV 并求出某列均值;或者用 FastAPI 成功跑起一个“Hello World”接口。
- 里程碑 L2(容错与异常边界):能处理实际情况中的脏数据和网络异常。例如应对带有空值、格式错误的日期;对 Web 请求中缺失参数返回符合规范的 HTTP 422 提示,系统不发生崩溃。
- 里程碑 L3(多库协同小闭环):将多个库串联成一个具备实用价值的小工具。
- 数据分析方向小闭环:编写一个脚本,定时读取某业务 CSV,使用 Pandas 清洗并统计各部门业绩,通过 Matplotlib 自动导出带有柱状图和折线图的销售简报。
- Web开发方向小闭环:构建一个简易备忘录系统,FastAPI 提供增删改查接口,Pydantic 校验数据合法性,SQLAlchemy 持久化存储至 SQLite 文件中。
- 里程碑 L4(工程化与官方文档检索):遇到从未见过的复杂需求时,不再去搜索引擎四处粘贴过时的博客代码,而是能够直接翻阅官方英文文档(Docs)查找标准函数签名,并在独立的
.venv环境下组织代码结构。
牢记:任何库都只是放大你思考与解决问题能力的杠杆。在自学路上,宁可深入吃透 3 个核心库并交付 1 个跑得通的真实小系统,也远好于浮光掠影地浏览 50 个库却写不出一行健壮的代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









