

Python 3异步编程asyncio核心概念与代码示例
深入解析 Python 3 内置异步编程库 asyncio 的核心概念与运行机制,涵盖事件循环、协程、Task 与 Future,并提供并发调度、超时控制与避免阻塞的完整代码示例。
在编写网络爬虫、API 网关通信或高并发微服务时,程序往往需要等待大量的网络 I/O 响应。如果采用传统的同步阻塞模式,CPU 会在网络等待期间处于空转挂起状态;而多线程方案又伴随着线程切换开销与复杂的锁同步问题。Python 3 内置的 asyncio 模块通过单线程内的事件循环与协程调度,提供了一种轻量高效的非阻塞 I/O 解决方案。本文将直接拆解 asyncio 的核心机制与架构分层,并结合切实可用的代码示例,帮助读者快速掌握编写高并发异步程序的实践方法。
一、为什么需要异步:I/O 阻塞与并发模型对比
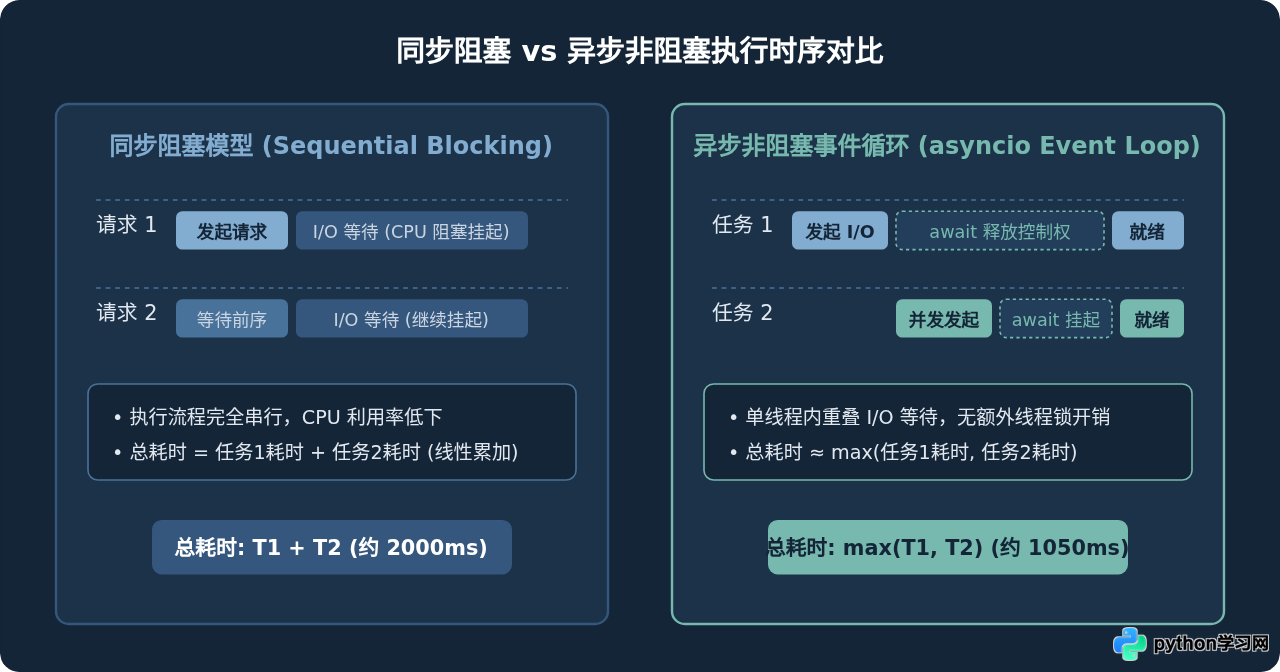
假设我们需要同时向外部接口发起 3 次 HTTP 请求,每次请求的网络往返耗时约 1 秒。在同步顺序执行的程序中,CPU 发送第一个请求后必须停下来等待响应,收到后再发起第二个请求,总耗时将线性叠加至 3 秒。这种模式的瓶颈不在于 CPU 的运算速度,而在于网络通信的 I/O 等待时间。
asyncio 的核心思路是在单线程中引入协同式调度(Cooperative Multitasking):当某个任务发起网络请求进入等待状态时,它主动让出 CPU 控制权,事件循环立即转去执行下一个就绪的任务;当网络响应到达后,操作系统通知事件循环唤醒原任务继续处理。这使得原本串行的等待时间被重叠起来,整体执行时间取决于最慢的那次网络交互,而非所有请求的耗时总和。
二、asyncio 四大核心概念详解
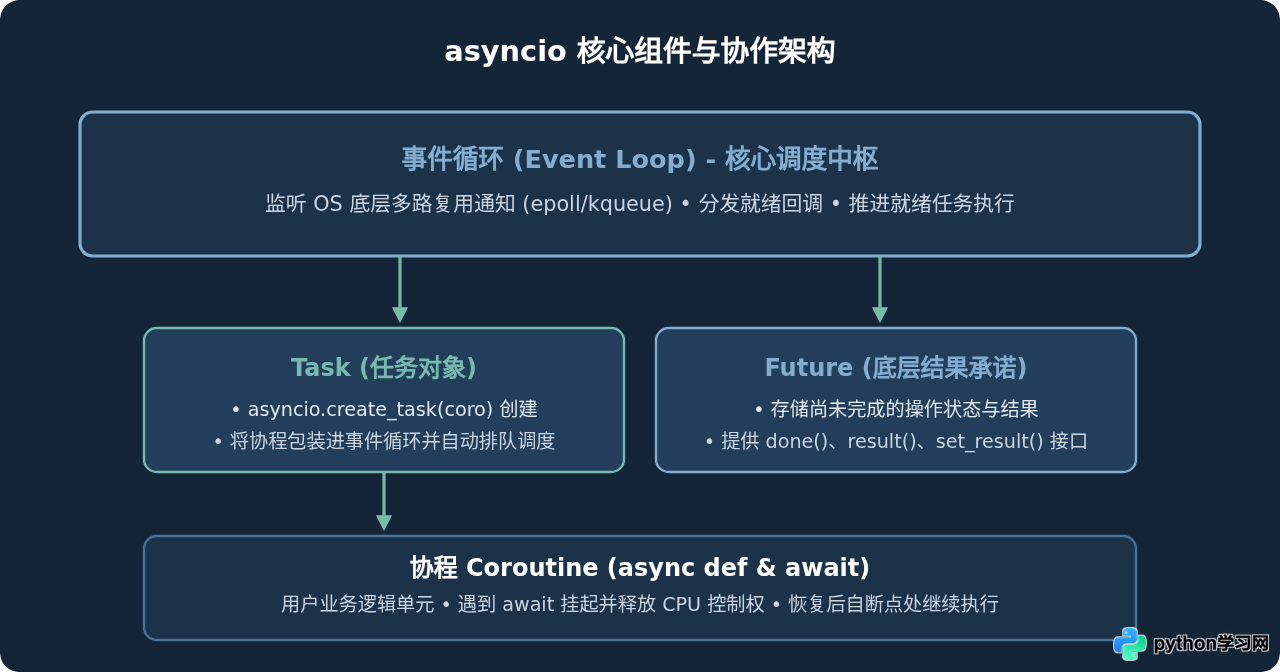
理解 asyncio 的核心在于理清内部的抽象分层。Python 异步体系主要由以下四个基本构件协作完成:
1. 协程 (Coroutine)
在 Python 中,通过 async def 声明的函数即为协程函数。直接调用协程函数并不会立刻执行函数体中的代码,而是返回一个协程对象(Coroutine Object)。协程对象实现了 Python 的 __await__ 协议,属于可等待对象(Awaitable)。只有通过 await 关键字挂起驱动,或者注册进事件循环调度,协程内部的代码才会运行。
2. 事件循环 (Event Loop)
事件循环是 asyncio 的调度大脑。它运行在单个线程中,内部维护了一个任务执行队列和底层 I/O 多路复用选择器(在 Linux 上是 epoll,在 macOS 上是 kqueue)。事件循环按顺序唤醒就绪任务,在任务遇到 I/O 挂起时切出,在底层套接字就绪时唤醒回调,循环往复直到所有任务完成。
3. 任务 (Task)
Task 是 asyncio.create_task() 对协程对象的进一步包装。当一个协程被封装为 Task 时,它被立即注册进事件循环的任务队列,获得由事件循环自主调度的能力。通过 Task,多个协程可以真正实现“在后台并发推进”,而不再受限于主线代码的串行调用。
4. Future
Future 是一个低级别的异步容器对象,用来代表一个“未来才会产生结果或异常的操作”。通常在编写高层应用代码时很少直接实例化 Future,但 Task 正是 Future 的子类。当底层的异步网络请求或定时器完成时,底层的回调函数会将结果写入 Future,进而触发绑定在其上的等待链。
三、asyncio 程序的开发与执行规范
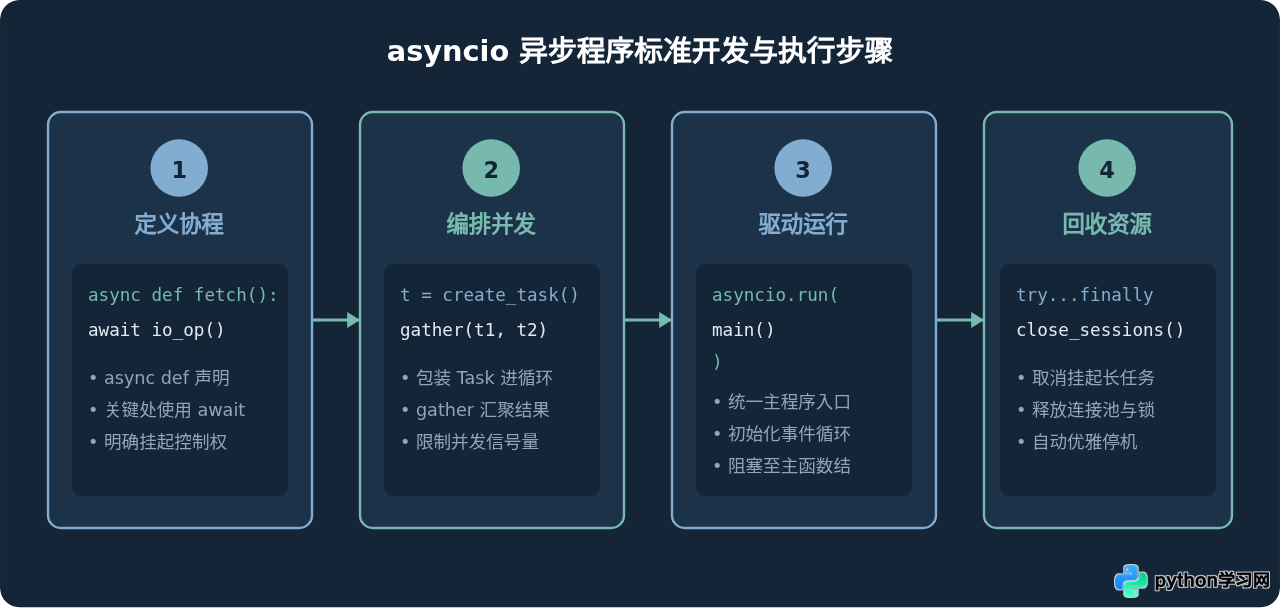
在 Python 3.7 及之后的版本中,官方提供了简洁的高层 API,不再建议手动管理事件循环的获取(如 get_event_loop())与手动关闭。标准的编写与调用步骤如下:
- 编写协程函数:使用
async def编写业务函数。在涉及 I/O 等待的位置,必须使用await调用原生支持异步的可等待对象(如asyncio.sleep()或异步网络请求库)。 - 组织并发结构:如果需要同时执行多个任务,使用
asyncio.create_task()提前将协程加入调度,或者使用asyncio.gather()进行聚合等待。 - 主入口驱动:在顶级代码中调用
asyncio.run(main())。该函数会自动创建全新的事件循环、执行传入的主协程、等待所有排队任务完成,并在退出时自动关闭循环与底层连接。
四、核心代码示例与实战演练
示例 1:基础协程与执行入口
以下代码展示了一个最基础的异步函数定义与运行。这里我们使用 asyncio.sleep() 模拟非阻塞的异步网络延迟(请注意,不能使用标准库的 time.sleep()):
import asyncio
import time

async def fetch_user_data(user_id: int) -> dict:
    print(f"[{time.strftime('%X')}] 开始获取用户 {user_id} 数据...")
    # 模拟网络 I/O 延迟 1 秒
    await asyncio.sleep(1.0)
    print(f"[{time.strftime('%X')}] 用户 {user_id} 数据获取成功")
    return {"user_id": user_id, "name": f"User_{user_id}"}

async def main():
    start = time.perf_counter()
    # 串行 await 两次请求
    res1 = await fetch_user_data(101)
    res2 = await fetch_user_data(102)
    elapsed = time.perf_counter() - start
    print(f"串行执行完毕,总耗时: {elapsed:.2f} 秒,返回: {res1}, {res2}")

if __name__ == "__main__":
asyncio.run(main())执行结果说明:由于代码中直接使用 await fetch_user_data(101),程序会等待用户 101 获取完毕后才执行下一行,总耗时约为 2.0 秒。要实现真正的并行等待,需要使用并发编排工具。
示例 2:使用 asyncio.gather() 实现高并发请求
asyncio.gather() 可以接收多个可等待对象,将它们统一交给事件循环并发推进,并在所有任务全部完成后按传入顺序返回结果列表:
import asyncio
import time

async def simulate_api_call(service_name: str, delay: float) -> str:
    print(f"[{time.strftime('%X')}] 发送请求至 {service_name},预计耗时 {delay}s")
    await asyncio.sleep(delay)
    print(f"[{time.strftime('%X')}] 收到 {service_name} 响应")
    return f"{service_name}: 状态正常"

async def main():
    start = time.perf_counter()

    # 将多个异步调用作为参数传入 gather 中
    results = await asyncio.gather(
        simulate_api_call("用户服务", 1.2),
        simulate_api_call("支付服务", 1.8),
        simulate_api_call("库存服务", 1.0)
    )

    elapsed = time.perf_counter() - start
    print(f"\n全部服务响应完毕,总耗时: {elapsed:.2f} 秒")
    for res in results:
        print(f" - {res}")

if __name__ == "__main__":
    asyncio.run(main())
示例输出:
[14:30:00] 发送请求至 用户服务,预计耗时 1.2s
[14:30:00] 发送请求至 支付服务,预计耗时 1.8s
[14:30:00] 发送请求至 库存服务,预计耗时 1.0s
[14:30:01] 收到 库存服务 响应
[14:30:01] 收到 用户服务 响应
[14:30:01] 收到 支付服务 响应

全部服务响应完毕,总耗时: 1.80 秒
 - 用户服务: 状态正常
 - 支付服务: 状态正常
 - 库存服务: 状态正常
原本需要 1.2 + 1.8 + 1.0 = 4.0 秒的串行过程,在异步并发下仅需 1.80 秒,效率提升显著。
示例 3:后台任务派发与超时控制 (asyncio.wait_for)
在网络编程中,服务端不可预期的超时极为常见。asyncio.wait_for() 允许为任意异步操作设置最大容忍时间;若超时未完成,事件循环会自动取消任务并抛出 TimeoutError:
import asyncio

async def slow_network_query():
    # 模拟一个偶发的慢查询
    await asyncio.sleep(3.0)
    return "查询成功返回"

async def main():
    try:
        # 设置超时上限为 1.5 秒
        result = await asyncio.wait_for(slow_network_query(), timeout=1.5)
        print("得到结果:", result)
    except asyncio.TimeoutError:
        print("警告: 远程请求超过 1.5 秒未响应,任务已被取消")

if __name__ == "__main__":
asyncio.run(main())版本提示:在 Python 3.11 及更新版本中,推荐使用更为清晰的上下文管理器 async with asyncio.timeout(1.5): 来替代 wait_for,其支持更优雅的嵌套与异常传播控制。
示例 4:使用 Semaphore (信号量) 控制最大并发量
在批量爬取网页或调用三方接口时,若一次性并发发起成千上万个任务,可能会触发对方防火墙限流,或者耗尽本地文件描述符(Socket 连接)。通过 asyncio.Semaphore 可以限制同时处于运行状态的任务数量:
import asyncio

async def bounded_worker(sem: asyncio.Semaphore, task_id: int):
    # 使用上下文管理器获取信号量许可证
    async with sem:
        print(f"任务 {task_id} 获得许可证,正在执行...")
        await asyncio.sleep(0.5)
        print(f"任务 {task_id} 完成并释放许可证")

async def main():
    # 限制同时并发的任务数最多为 3 个
    sem = asyncio.Semaphore(3)
    tasks = [asyncio.create_task(bounded_worker(sem, i)) for i in range(10)]
    await asyncio.gather(*tasks)

if __name__ == "__main__":
    asyncio.run(main())
五、常见避坑指南与核心决策总结
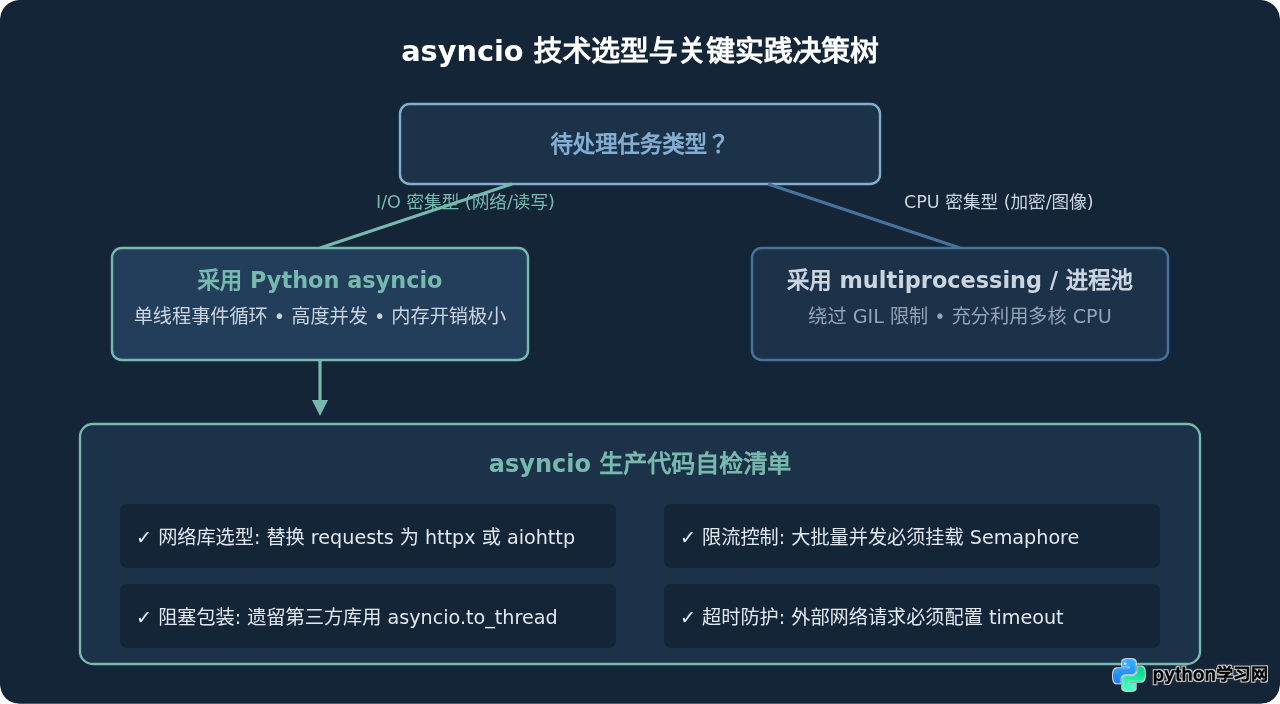
许多初学者在将传统代码重构为异步时,容易产生“只要加了 async 就会变快”的误解。以下几点是最常见的架构与代码误区:
- 误区一:在协程中调用同步阻塞函数。如果在协程里调用了
time.sleep()、传统的requests.get()或密集的大数组循环计算,由于没有触发await机制,整个单线程事件循环都会被完全冻结,所有排队的并发任务全部停滞。在异步代码中必须使用专门的异步网络库(如httpx、aiohttp)与异步数据库驱动(如asyncpg)。 - 误区二:处理无法异步化的遗留阻塞代码。如果有现成的遗留 SDK 或 CPU 计算无法改造为异步,切勿直接在协程中同步调用。应使用
asyncio.to_thread()将阻塞函数自动分发到后台线程池执行,避免阻断主事件循环:# 正确处理遗留阻塞代码的方式 result = await asyncio.to_thread(legacy_blocking_function, arg1, arg2) - 误区三:忘记 await 或忘记注册 Task。仅仅写
fetch()不会执行协程,解释器会在垃圾回收时抛出RuntimeWarning: coroutine 'fetch' was never awaited。务必确认所有协程调用均包含await或通过create_task()纳入调度。
六、总结
asyncio 改变了 Python 处理高并发 I/O 的方式。掌握它的核心在于:
- 理解事件循环驱动的核心机制,时刻警惕单线程内的同步阻塞调用;
- 熟练使用
async def与await构建无阻塞的业务流; - 善用
asyncio.gather()、asyncio.create_task()与asyncio.Semaphore编排并发并控制系统负载; - 在现代 Python 版本中,以
asyncio.run()作为统一入口,享受自动生命周期管理带来的安全与便利。
遵循上述设计模式,开发者便能用优雅可维护的代码构建出高吞吐、低延迟的现代网络应用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









