

Python全栈开发教程概览:涵盖Web后端与数据处理核心技能
系统梳理Python全栈开发的核心技术框架,深入拆解Web后端工程化构建与高性能数据处理双核心技能,涵盖架构设计、ORM异步交互、Pandas数据清洗与生产落地规程。
在以数据为核心驱动的软件系统开发中,Python全栈开发并非简单的前端切图加数据库增删改查,其实质是将工业级Web后端工程与高性能数据处理管道紧密结合的综合交付能力。本文紧扣Web后端构建与数据处理两大核心技能,梳理现代Python全栈开发的完整技术图景、工程实现步骤与避坑规范,帮助开发者建立清晰可执行的技能全貌。
一、全栈体系定位与核心能力边界
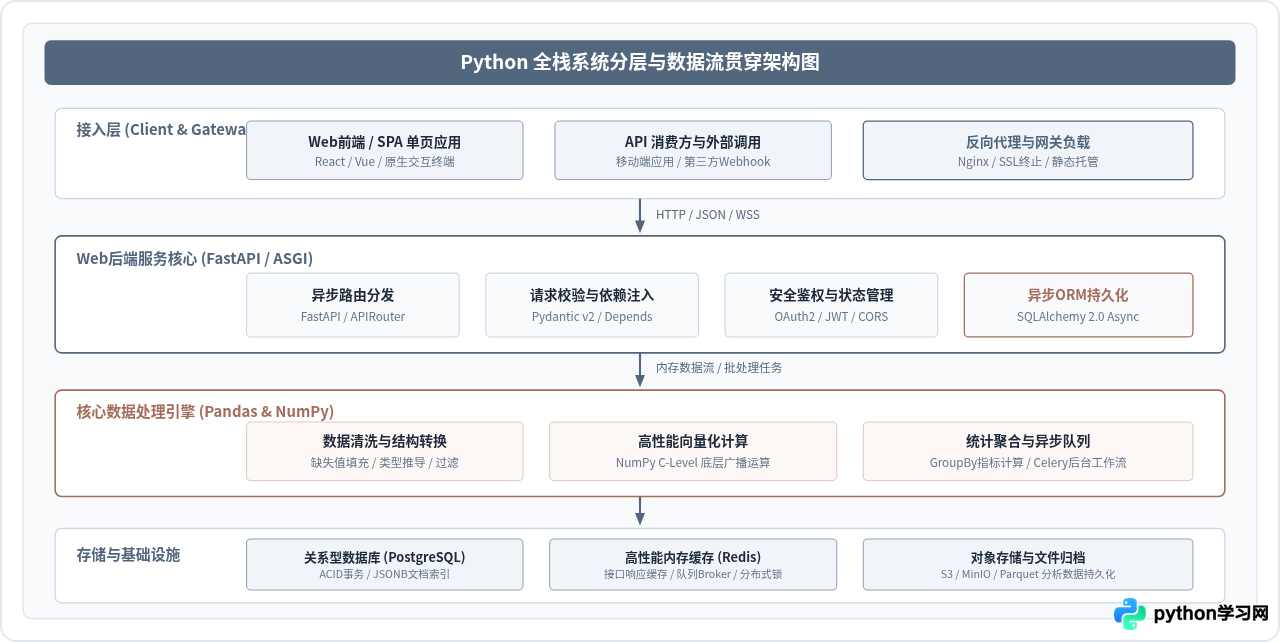
传统的Web全栈往往强调“浏览器界面到数据库”的单线打通,而在以智能化和数据分析为主要诉求的业务场景中,Python的核心竞争力体现在对复杂业务接口的高并发响应与对海量结构化数据的即时清洗分析上。因此,Python全栈工程师的技能矩阵主要聚焦于三大层次:
- Web服务与通信层:负责API网关对接、RESTful/WebSocket接口提供、请求鉴权、路由分发与并发调度;
- 业务与数据处理引擎层:负责业务逻辑编排、数据验证清洗、统计运算与异步后台批处理任务调度;
- 持久化与基础设施层:负责关系型数据库设计、ORM映射优化、Redis分布式缓存以及容器化部署管理。
二、Web后端核心构建:路由分发、ORM与异步架构
在现代化Web后端架构中,FastAPI已逐渐成为构建数据密集型API的主流选择。其基于Python类型提示(Type Hints)与ASGI标准,能够同时保证极佳的开发效率与执行性能。构建后端服务通常包含三个不可拆分的环节:声明式请求模式校验、异步数据库会话管理与路由生命周期解耦。
1. 声明式参数校验与类型安全
传统的后端开发中,参数解析与边界验证往往占据大量样板代码。在现代Python全栈实践中,利用Pydantic定义数据传输对象(DTO),能够在接口进入业务层之前自动完成类型强制转换、默认值注入和范围校验。不符合约定的请求会在网关入口处直接返回标准化的422状态码,避免脏数据渗入核心业务层。
2. 异步ORM与连接池调优
I/O密集型操作(如数据库读写、外部HTTP调用)是Web后端的首要吞吐瓶颈。结合SQLAlchemy 2.0的异步API(AsyncSession)与异步驱动(如asyncpg),可以在等待数据库返回数据的同时,释放Python事件循环去处理后续接入的HTTP请求,单机并发承载能力相较于传统同步模型有数倍提升。
# 典型 FastAPI + SQLAlchemy 异步接口示例
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field
from sqlalchemy.ext.asyncio import AsyncSession
from sqlalchemy import select
from typing import List

app = FastAPI(title="数据处理接口服务")

# 1. 声明式数据模型
class MetricQuery(BaseModel):
    category_id: int = Field(..., gt=0, description="分类ID,必须大于0")
    limit: int = Field(default=50, le=500, description="单次拉取记录上限")

class MetricResponse(BaseModel):
    record_id: int
    metric_value: float
    status_label: str

# 2. 异步路由处理函数
@app.post("/api/v1/metrics/query", response_model=List[MetricResponse])
async def query_metrics_endpoint(
    query: MetricQuery,
    session: AsyncSession = Depends(get_db_session)
):
    stmt = (
        select(MetricRecord)
        .where(MetricRecord.category_id == query.category_id)
        .limit(query.limit)
    )
    result = await session.execute(stmt)
    records = result.scalars().all()

    if not records:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="指定分类下无有效监控指标记录"
        )
    return records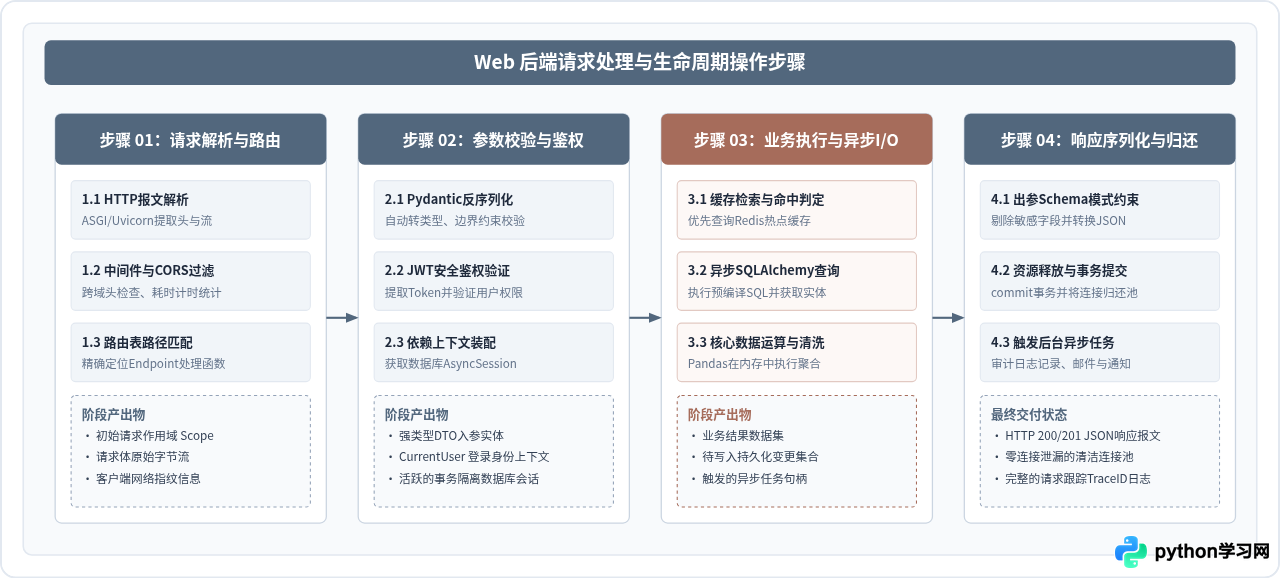
三、数据处理核心技能:从内存清洗到分析管道集成
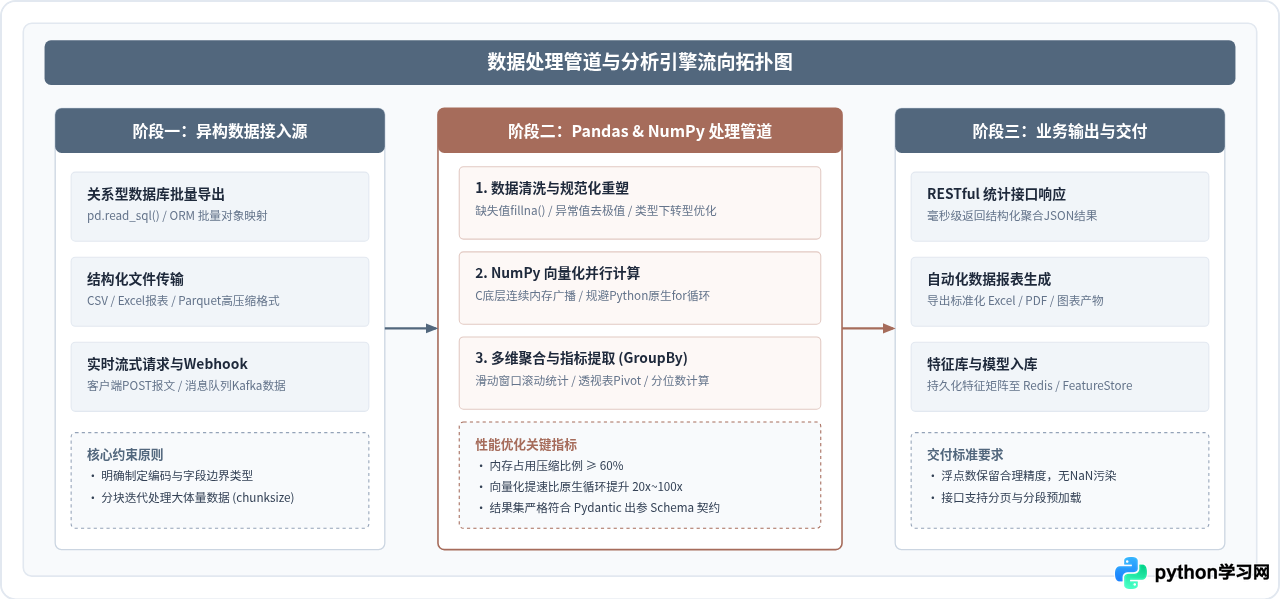
很多开发者在学习Python Web开发时习惯将所有计算交给数据库SQL完成,或者直接使用原生Python的循环(for loop)处理业务数据。然而,当单次处理量上升到数万行、或是涉及复杂跨字段衍生计算时,单纯依赖SQL会导致查询逻辑臃肿难维护,而原生for循环则会受限于解释器开销,导致接口响应严重超时。掌握基于Pandas和NumPy的内存数据管道,是Python全栈区别于其他语言开发者的关键分水岭。
1. 数据清洗的核心操作模式
从数据库或外部数据源加载的数据,通常包含空值(NaN/None)、不规则字符串和类型冗余。高质量的数据清洗遵循统一的处理规范:
- 确定性空值填补与过滤:使用
fillna()或dropna(subset=[...])明确定义缺失值业务策略,严禁未处理的NaN直接透传给前端JSON序列化器; - 内存紧凑型数据类型转换:将默认的
int64/float64根据实际数值范围降级为int32/float32,对低基数字符串列采用category类型,能将内存占用降低50%至80%; - 向量化衍生列构建:通过NumPy数组的广播机制(如
np.where或向量化算术表达式)替代apply()逐行循环,计算执行速度可提升数个数量级。
# 典型的高性能清洗与聚合计算函数
import pandas as pd
import numpy as np
from typing import List, Dict

def transform_transaction_metrics(raw_data: List[Dict]) -> Dict:
    # 1. 快速载入DataFrame并指定基础类型
    df = pd.DataFrame(raw_data)
    if df.empty:
        return {"total_gmv": 0.0, "vip_ratio": 0.0, "category_summary": []}

    # 2. 向量化清洗:处理缺失值与类型降级
    df["amount"] = pd.to_numeric(df["amount"], errors="coerce").fillna(0.0).astype(np.float32)
    df["is_vip"] = df["user_level"].str.upper().eq("VIP").astype(np.int8)

    # 3. 向量化条件计算:加权计算实际收益
    # 规避逐行遍历,利用 np.where 提升执行效率
    discount_rate = np.where(df["is_vip"] == 1, 0.85, 1.0)
    df["net_revenue"] = df["amount"] * discount_rate

    # 4. 分组聚合统计
    summary = (
        df.groupby("category", as_index=False)
        .agg(
            total_orders=("amount", "count"),
            gross_amount=("amount", "sum"),
            net_revenue=("net_revenue", "sum")
        )
        .to_dict(orient="records")
    )

    return {
        "total_gmv": float(df["amount"].sum()),
        "vip_ratio": float(df["is_vip"].mean()),
        "category_summary": summary
    }
四、全栈实战演进路径与技能贯通总结
构建一个同时兼顾后端稳定性和数据处理能力的系统,需要清晰的分阶段演进策略。初学者常见的问题是过早引入复杂分布式微服务或重度数据框架,导致单体维护困难。推荐按照“基础筑底 → 接口工程 → 数据提效 → 生产运维”四阶段渐进式落地:
| 技能阶段 | 核心工具与框架 | 重点突破能力 | 验证产出标准 |
|---|---|---|---|
| 阶段一:工程基础 | Python 3.11+、Poetry、Pytest | 面向对象设计、类型提示、虚拟环境隔离、单元测试规范 | 可维护的模块化代码库与自动化测试流水线 |
| 阶段二:后端工程 | FastAPI、Pydantic、SQLAlchemy 2.0 | RESTful路由规范、异步I/O、JWT安全鉴权、数据库迁移(Alembic) | 完整支持CRUD、具备Swagger文档的自描述API服务 |
| 阶段三:数据管道 | Pandas、NumPy、Celery、Redis | 向量化数据清洗、多维分组统计、后台异步队列解耦、缓存设计 | 秒级处理数十万级记录的高性能分析端点 |
| 阶段四:生产交付 | Docker、PostgreSQL、Gunicorn/Uvicorn | 容器编排、数据库索引调优、连接池参数配置、结构化日志监控 | 具备容灾能力、资源监控健全的生产级部署体系 |
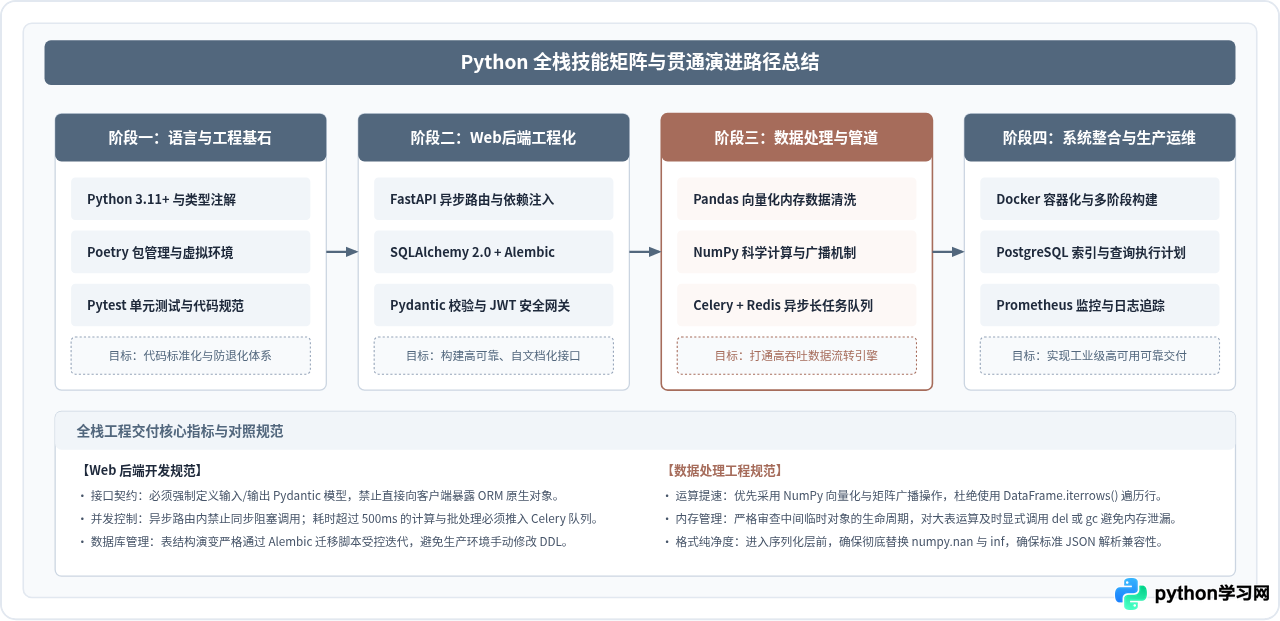
五、生产落地关键规范与避坑指南
在实际生产环境中,Python全栈系统常因为未能兼顾Web服务的高并发要求与数据处理的CPU开销而发生故障。以下是在系统集成阶段必须严格执行的四项设计规范:
FastAPI等异步框架运行在单线程事件循环(Event Loop)上。如果在
async def 的视图函数中直接调用大体量数据的 Pandas 聚合计算或复杂的正则过滤,会导致整个工作线程被彻底卡住,期间所有其他客户端的HTTP并发请求都会陷入排队阻塞。正确的做法是将密集计算包裹在 run_in_threadpool 中执行,或者直接推送到 Celery 任务队列中由单独的独立工作进程异步消化。
全栈开发者在读取包含外键关联的数据模型时(例如同时查询订单与其包含的明细项),若未显式指定预加载策略(如
selectinload() 或 joinedload()),ORM 会在每次访问子关联时自动追加执行一次单独的 SQL 查询。这会导致原本只需 1 次联表查询的操作暴增至 N+1 次数据库交互,极度消耗数据库连接池资源。
Web应用属于长时间持续运行的守护进程。如果在模块级别或全局单例对象中缓存处理过的 DataFrame,或者在请求生命周期结束后由于闭包循环引用未能及时被 Python 垃圾回收器释放,内存占用会随着每次接口请求持续攀升,最终触发操作系统的 OOM Killer 强制终结进程。必须确保数据处理管道的输入与输出对象局限在函数局部作用域内。
Pandas在处理缺失值时默认使用浮点型的
np.nan,而标准 JSON 规范并不原生支持 NaN 或 Infinity。如果将含有未处理 NaN 的字典数据直接传递给接口响应,会导致前端反序列化崩溃或被强制替换为 null。在数据交接给 Pydantic 模型之前,务必通过 where(pd.notnull(df), None) 或特定默认值进行显式转换,保证接口协议的严格自洽。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









