

Python爬虫常见反爬策略应对:IP限制、User-Agent伪装与Cookie管理
针对Python爬虫在数据采集过程中常遇到的反爬阻断,系统解析User-Agent与多维标头伪装、IP限制与动态高可用代理池架构,以及Cookie生命周期与Session会话管理的实战应对方案。
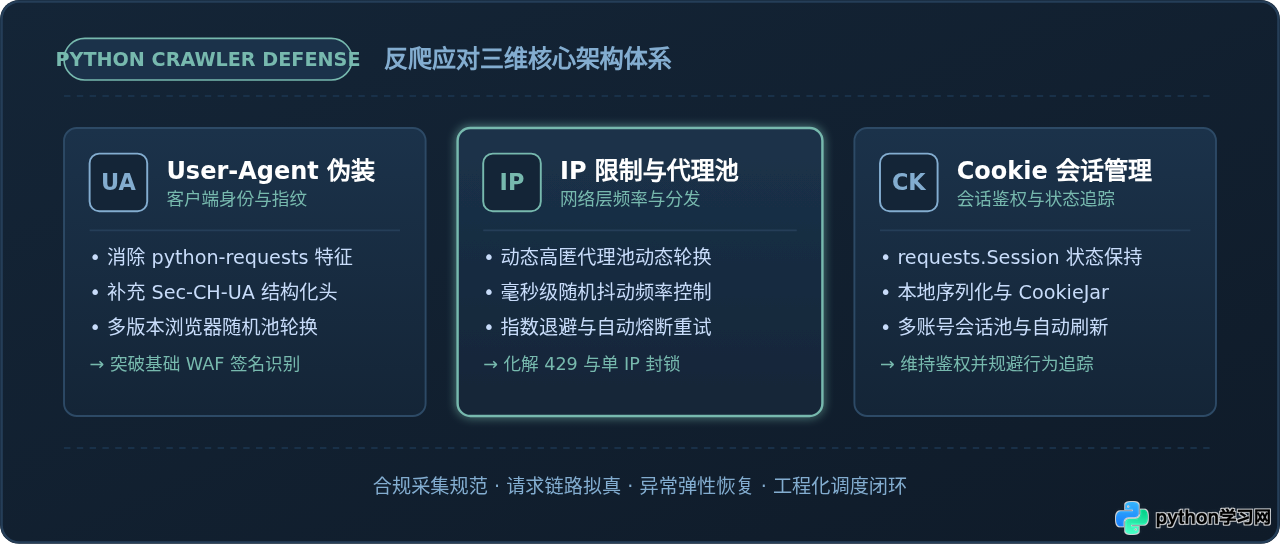
一、User-Agent 伪装与全维度请求头拟真
在 HTTP 协议中,User-Agent(简称 UA)是客户端向服务器声明自身身份的核心标头。Python 标准库 urllib 默认的 UA 标识包含 Python-urllib/x.x,第三方主流库 requests 发出的请求头则默认为 python-requests/2.x.x。当目标站点部署了 Web 应用防火墙(WAF)或反爬规则库时,这类带有明显自动化类库标记的请求会在网关处直接被匹配并返回 403 Forbidden。
然而,只在代码中写死一个固定的浏览器 UA 字符串并不能一劳永逸。现代反爬系统往往会检验“请求头矩阵”的完整度与逻辑一致性。如果一个请求声称自己是 Chrome 浏览器,但缺少 Accept-Language、Sec-Ch-Ua 系列结构化头,或者静态资源请求没有合理的 Referer 上下文,依然会被判定为非真实用户。
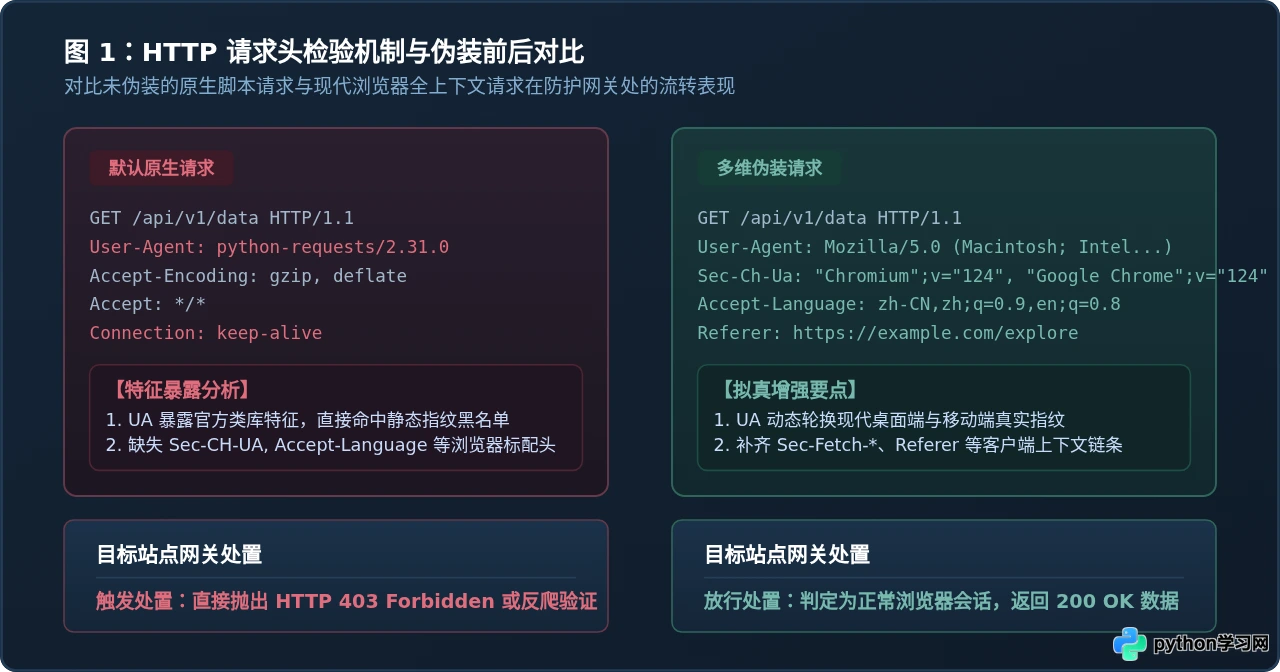
1. 构建多维伪装请求头
为了模拟桌面端真实浏览器的网络行为,基础的请求头配置应当补齐常规字段,包括语言偏好、压缩支持以及 Chromium 内核特有的安全标头。
import requests

# 构造包含完整上下文特征的标准浏览器标头
browser_headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,"
              "image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7",
    "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Sec-Fetch-User": "?1",
    "Upgrade-Insecure-Requests": "1"
}

# 发起测试请求(以检查回显为目的的示例端点)
target_url = "https://httpbin.org/headers"
response = requests.get(target_url, headers=browser_headers, timeout=10)

# 输出验证结果(示例)
print("HTTP 响应状态码:", response.status_code)
print("服务端识别出的 User-Agent:", response.json().get("headers", {}).get("User-Agent"))# 示例输出:确认服务端接收到的身份标识已完全等同于真实桌面 Chrome
HTTP 响应状态码: 200
服务端识别出的 User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.362. 动态轮换与 User-Agent 池设计
当执行跨栏目、批量分页采集任务时,若成千上万次请求全部使用完全一致的 UA 和静态指纹,极易在服务端统计日志中暴露异常规律。此时可通过维护一个包含常见 Windows、macOS 平台主流浏览器版本的 UA 池,在每次请求前随机抽取。对于轻量项目,可以使用 fake-useragent 库或本地静态配置文件:
import random

class UserAgentRotator:
    # 提供高频真实浏览器 User-Agent 随机抽取器
    _UA_POOL = [
        # Chrome on Windows
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36",
        # Chrome on macOS
        "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
        # Safari on macOS
        "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_4_1) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.4.1 Safari/605.1.15",
        # Edge on Windows
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36 Edg/124.0.0.0"
    ]

    @classmethod
    def get_random_header(cls, referer=None):
        headers = {
            "User-Agent": random.choice(cls._UA_POOL),
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Accept-Encoding": "gzip, deflate, br",
            "Connection": "keep-alive"
        }
        if referer:
            headers["Referer"] = referer
return headers切勿生成荒谬或过期的 UA(例如已经废弃多年的 IE 6/7,或者 Android 移动端 UA 与 Windows 系统平台参数混合的错误组合)。此外,不要在翻页过程中每发一个 API 请求就换一次操作系统,短时间内同一会话下操作系统与主版本号剧烈跳动反而会引发反爬风控的二次审查。
二、IP 限制机制与高可用代理池架构
即便请求头伪装得天衣无缝,服务端最有力、最直接的限流维度依然是 客户端 IP 地址。网站往往在 Nginx、云防火墙或应用层网关设置访问频率阈值(例如单 IP 每分钟上限 60 次)。一旦脚本并发超限,常见的服务端惩罚措施包括:
- HTTP 429 Too Many Requests:通知客户端请求过于频繁,有时会在响应头中附带
Retry-After。 - 验证码拦截(CAPTCHA):将原本的 HTML/JSON 接口替换为极验、Cloudflare Turnstile 等滑动验证页面。
- TCP 丢包或直接 403 阻断:将该 IP 加入临时封禁列表,持续时长通常从数分钟到数小时不等。
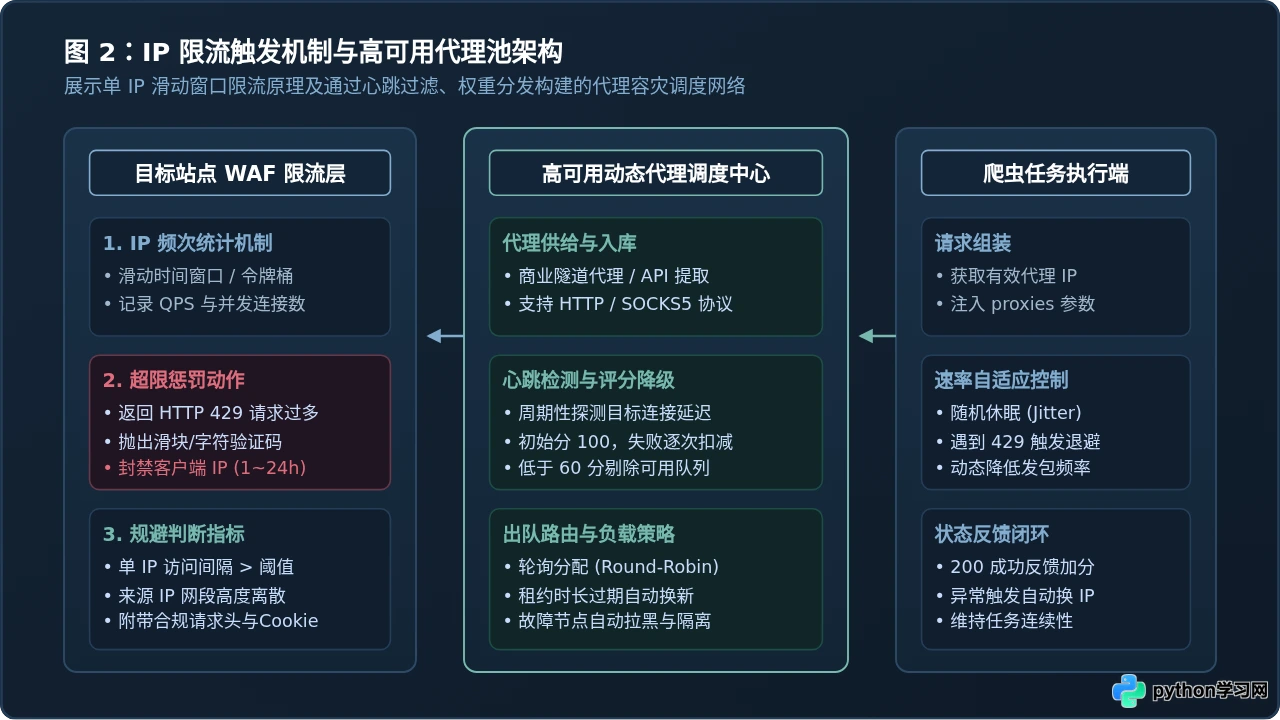
1. 正向代理的工作原理与配置
应对 IP 限制的根本方案是让请求经过中间代理服务器转发,从而使目标网站看到的来源 IP 分散在不同的地理节点和网段中。在 Python 中,通过 requests 配置 HTTP 与 SOCKS5 代理非常直观:
import requests

# 代理服务器参数示例(支持 http, https, socks5)
proxy_host = "127.0.0.1"
proxy_port = "7890"

proxies = {
    "http": f"http://{proxy_host}:{proxy_port}",
    "https": f"http://{proxy_host}:{proxy_port}"
}

try:
    # 请求对外 IP 检查接口测试连通性
    resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=8)
    print("代理转发成功,当前对外出口 IP 为:", resp.json().get("origin"))
except requests.exceptions.RequestException as err:
print("代理连接失败,原因:", err)# 示例输出:证明原本的本地物理 IP 已经被代理节点的出口 IP 成功替代
代理转发成功,当前对外出口 IP 为: 198.51.100.422. 代理池健康检测与自愈机制
生产环境下,公开免费代理或按时效计费的动态代理往往具有存活时间短、延迟不稳定的特点。一个健全的代理池应当具备四个核心环节:
- 定时入库:从服务商 API 获取最新的高匿代理 IP 列表。
- 心跳保活与打分:启动后台异步协程或多线程,针对轻量测试站点定期测速与打分。新代理初始 100 分,每次请求超时扣 20 分,低于 60 分从可用队列剔除。
- 租约管理:若使用的是隧道代理(如自动轮换端口模式),爬虫无需本地维护队列,每次发起网络请求隧道服务会自动分发不同 IP。
- 自适应退避与随机抖动(Jitter Delay):即使有代理池,爬虫也不应全速高频轰炸。在请求之间加入
random.uniform(1.0, 3.0)秒的随机浮动延时,大幅降低在单节点触发 429 的概率。
三、Cookie 管理与会话状态持久化
许多有价值的数据往往藏在用户鉴权墙之后,或者需要经过特定的浏览路径(例如先打开列表页生成防盗链 Cookie,再访问详情接口)。若每次请求都重新初始化连接,服务器会因为识别不到会话凭证而拒绝响应,或者将同一个缺乏状态追踪的客户端直接标记为异常脚本。
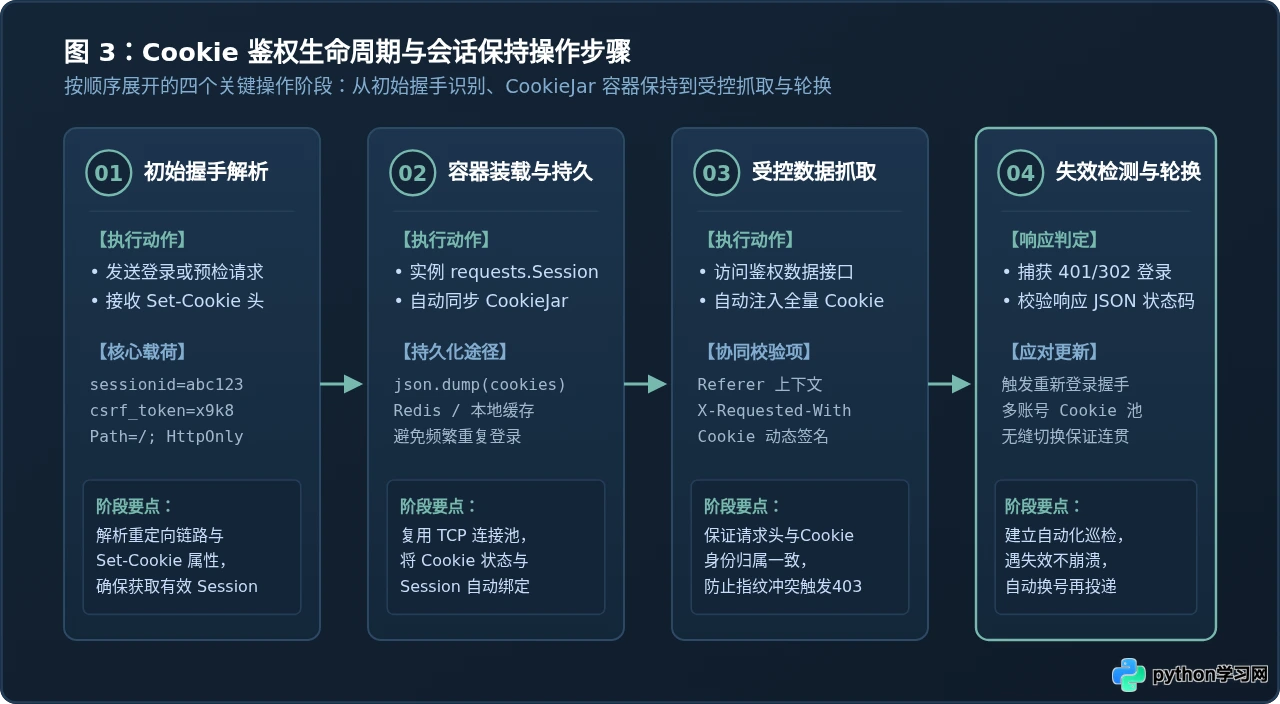
1. requests.Session 自动化 CookieJar 机制
Python requests 库提供了 Session 对象。Session 会底层复用 TCP 连接(Connection Pooling),同时在生命周期内跨请求自动提取、保存并发送服务端返回的 Set-Cookie 标头。
import requests

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                  "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36"
})

# 步骤一:访问目标初始首页,服务器返回带有 Session 标识的 Set-Cookie
init_url = "https://httpbin.org/cookies/set?token=alpha9988&role=crawler"
res_init = session.get(init_url)

# 查看当前 Session 会话中自动保存的 CookieJar 内容
print("当前 Session 内的 Cookies 映射:")
for c in session.cookies:
    print(f"  {c.name} = {c.value} (Domain: {c.domain}, Path: {c.path})")

# 步骤二:访问需要会话的后续接口,requests 会自动附带上述 Cookie
verify_url = "https://httpbin.org/cookies"
res_verify = session.get(verify_url)
print("后续请求服务端实际接收到的 Cookie:", res_verify.json())# 示例输出:第二步请求无须手动拼接 Cookie 字符串,底层协议栈自动装配发送
当前 Session 内的 Cookies 映射:
role = crawler (Domain: httpbin.org, Path: /)
token = alpha9988 (Domain: httpbin.org, Path: /)
后续请求服务端实际接收到的 Cookie: {'cookies': {'role': 'crawler', 'token': 'alpha9988'}}2. Cookie 的本地序列化与多账号轮换
对于需要登录才能采集的站点,如果每次运行脚本都模拟一次账号密码提交甚至扫码,极易触发异地登录风控与图形验证码。标准做法是:通过浏览器或独立登录脚本获取有效 Cookie,序列化为本地 JSON 文件或存入 Redis;爬虫工作进程启动时载入 Cookie 注入 Session,只有当检测到鉴权失效时才唤醒重新登录。
import json
import os
import requests

COOKIE_FILE = "cached_cookies.json"

def save_cookies(session, filepath):
    # 将 Session 中的 Cookie 转换为字典并保存到文件
    cookie_dict = requests.utils.dict_from_cookiejar(session.cookies)
    with open(filepath, "w", encoding="utf-8") as f:
        json.dump(cookie_dict, f, ensure_ascii=False, indent=2)

def load_cookies(session, filepath):
    # 从本地文件载入 Cookie 并注入 Session
    if not os.path.exists(filepath):
        return False
    with open(filepath, "r", encoding="utf-8") as f:
        cookie_dict = json.load(f)
    session.cookies = requests.utils.cookiejar_from_dict(cookie_dict)
    return True

# 模拟载入并检验
worker_session = requests.Session()
if load_cookies(worker_session, COOKIE_FILE):
    print("成功从本地恢复登录态 Cookie,无需重复登录")
else:
    print("本地无有效 Cookie 缓存,准备执行初始认证流程...")
四、三位一体:构建工业级健壮抓取客户端
在实际生产项目中,将 User-Agent 伪装、代理 IP 调度与 Cookie 会话割裂开来往往无法应对复杂风控。例如,如果一个账号的 Cookie 对应着固定的用户 ID,但每个请求的出口 IP 在几秒内跨越了十几个省份,或者同一个 Session 中的 User-Agent 每秒都在更换,服务端风控引擎依然能够一眼识破。
真正健壮的架构设计应该构建一个统一的状态机客户端: 让单一 Session 在生命周期内保持 UA 与地域代理的相对稳定,通过指数退避(Exponential Backoff)解决突发限流,在捕获到 403 或 302 鉴权失效时精准触发针对性的恢复动作。
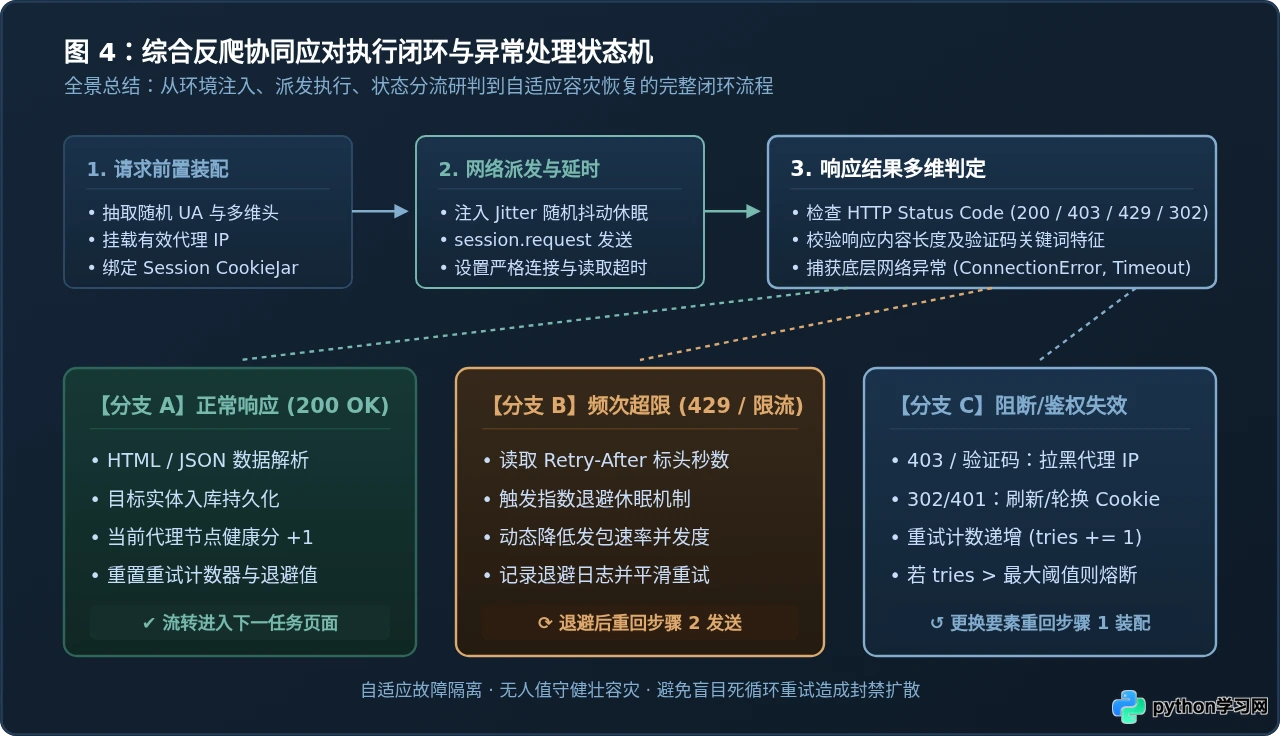
完整实战代码:高弹性抓取客户端
下面是一个可以直接引入项目的工程化爬虫客户端示例,整合了超时控制、随机退避、代理轮换与错误分支重试逻辑:
import time
import random
import logging
import requests

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class RobustCrawlerClient:
    # 工业级抓取客户端:融合 UA 轮换、代理容灾、Session 会话与指数退避

    def __init__(self, proxy_pool=None, max_retries=3, base_delay=1.5):
        self.proxy_pool = proxy_pool or []
        self.max_retries = max_retries
        self.base_delay = base_delay
        self.session = requests.Session()
        self._init_session_context()

    def _init_session_context(self):
        # 初始化一个稳定的会话上下文环境
        # 保持该会话内 UA 稳定,避免单个会话中操作系统频繁变化
        ua = (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
            "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36"
        )
        self.session.headers.update({
            "User-Agent": ua,
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Connection": "keep-alive"
        })

    def _get_proxy(self):
        # 从候选池中获取代理
        if not self.proxy_pool:
            return None
        proxy = random.choice(self.proxy_pool)
        return {"http": proxy, "https": proxy}

    def fetch(self, url, method="GET", **kwargs):
        # 具备自适应容灾能力的请求调度方法
        retries = 0
        current_delay = self.base_delay

        while retries <= self.max_retries:
            # 1. 注入网络随机抖动延时,平滑爬取频率
            jitter = random.uniform(0.3, 1.2)
            time.sleep(current_delay + jitter)

            proxies = self._get_proxy()
            try:
                logging.info(f"正在发起请求: {url} (尝试 {retries + 1}/{self.max_retries + 1})")
                resp = self.session.request(
                    method=method,
                    url=url,
                    proxies=proxies,
                    timeout=kwargs.get("timeout", 10),
                    **kwargs
                )

                # 2. 状态码判定与应对策略
                if resp.status_code == 200:
                    # 额外校验:防止虽然返回 200,但实际是 HTML 验证码或阻断页
                    if "captcha" in resp.text.lower() or "访问过于频繁" in resp.text:
                        logging.warning("检测到内容层验证码拦截,判定为 IP/指纹风控")
                        retries += 1
                        current_delay *= 2  # 指数退避
                        continue
                    return resp

                elif resp.status_code == 429:
                    logging.warning("触发 HTTP 429 请求过多,进入指数退避休眠...")
                    retry_after = resp.headers.get("Retry-After")
                    sleep_time = int(retry_after) if retry_after and retry_after.isdigit() else current_delay * 2
                    time.sleep(sleep_time)
                    retries += 1
                    current_delay *= 2
                    continue

                elif resp.status_code in (401, 302):
                    logging.warning(f"触发 HTTP {resp.status_code} 鉴权失效,需刷新 Cookie 会话")
                    # 此处可挂载自动重新登录 hook
                    retries += 1
                    continue

                elif resp.status_code == 403:
                    logging.warning("触发 HTTP 403 访问受限,更换代理节点后重试")
                    retries += 1
                    continue

                else:
                    logging.error(f"非预期响应状态码: {resp.status_code}")
                    retries += 1

            except (requests.exceptions.Timeout, requests.exceptions.ConnectionError) as err:
                logging.warning(f"底层网络连接异常: {err},切换代理重试")
                retries += 1
                current_delay *= 1.5

        raise RuntimeError(f"请求失败且已达最大重试上限: {url}")

# 使用示例
if __name__ == "__main__":
    crawler = RobustCrawlerClient(max_retries=2, base_delay=0.5)
    try:
        data_resp = crawler.fetch("https://httpbin.org/get")
        print("最终成功获取响应数据,长度:", len(data_resp.text))
    except RuntimeError as e:
        print("抓取熔断:", e)
五、常见问题排查与技术边界
| 异常现象 | 根本原因排查 | 针对性解决方案 |
|---|---|---|
| HTTP 403(秒封) | User-Agent 为默认类库标识,或 TLS 客户端指纹(JA3/JA4)命中黑名单 | 补齐全量浏览器 Headers;必要时采用 curl_cffi 模拟浏览器 TLS 指纹 |
| HTTP 429 / 提示操作频繁 | 请求发包频率超过服务器针对单 IP 的滑动窗口阈值 | 接入高匿代理池动态换 IP,并加入 1~3 秒随机休眠抖动(Jitter Delay) |
| 返回 302 重定向到登录页 | Cookie 中的 Session ID 过期,或缺少必须的防跨站 Token | 使用 requests.Session 维持会话,编写自动续签逻辑或构建多账号 Cookie 池 |
| 数据接口返回乱码或空列表 | 缺少关键的 Referer 上下文,或请求参数带有动态 JS 加密签名 | 补齐 Referer 与 Origin 标头;在浏览器开发者工具 Network 面板复现加密链路 |
合规与法律边界提醒:在开发网络爬虫时,应严格遵守 robots.txt 协议中声明的采集规则,合理调控抓取速率与并发连接,严禁高并发挤占目标网站服务器资源;同时杜绝非法采集公民个人隐私、商业机密或绕过受法律保护的技术防范措施。将代码设计重心放在协议规范性与异常弹性上,才能保证自动化程序的长效稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









