

Python模块怎么创建和导入使用
详细讲解Python模块的创建规范、四种常用导入方式、命名空间隔离机制、if __name__ == '__main__'入口防护以及sys.path模块查找原理。
编写Python脚本时,随着业务逻辑增加,单文件往往会膨胀到上千行;或者多个独立脚本都需要计算某种业务税率、处理日期格式。如果靠复制粘贴函数,不仅维护极其繁琐,修改时还极易遗漏。在Python中,解决代码拆分与复用最基础也是最核心的方案就是模块(Module)。一个以 .py 结尾的普通代码文件就是一个模块。本文将从零开始演示如何编写一个自定义模块、如何在其他脚本中通过四种方式导入使用、如何利用 if __name__ == '__main__': 保护执行入口,以及解释器是如何查找模块位置的。
一、什么是Python模块与快速创建流程
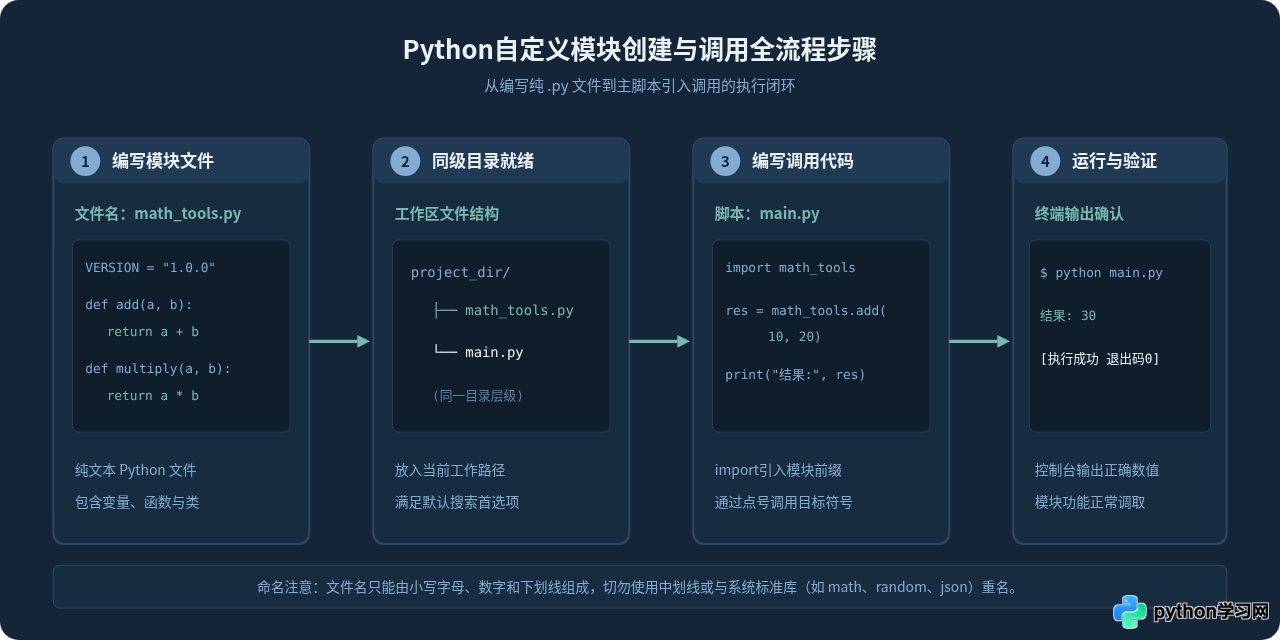
在Python的组织体系中,模块的本质是封装了变量、函数和类的命名空间。创建一个模块不需要任何特殊的编译命令或脚手架,只要在项目目录下新建一个标准的 .py 文件即可。
假设我们正在开发一个数学计算与格式转换工具,需要把通用函数提炼出来。我们在工程目录下创建一个名为 math_tools.py 的文件,并写入以下代码:
# 文件名:math_tools.py
"""数学运算与格式化工具模块"""

VERSION = "1.0.0"

def add(a, b):
    """计算两数之和"""
    return a + b

def multiply(a, b):
    """计算两数之积"""
    return a * b

def format_currency(amount):
    """将数字格式化为带千分位和货币符号的字符串"""
    return f"¥{amount:,.2f}"
至此,模块的创建就已经完成了。在这个文件中,VERSION 是模块级变量,add、multiply 和 format_currency 是模块提供的功能函数。接下来,我们只需要在同一个目录下创建另一个调用文件 main.py,即可进行导入与测试。
二、四种常用的模块导入与使用方式
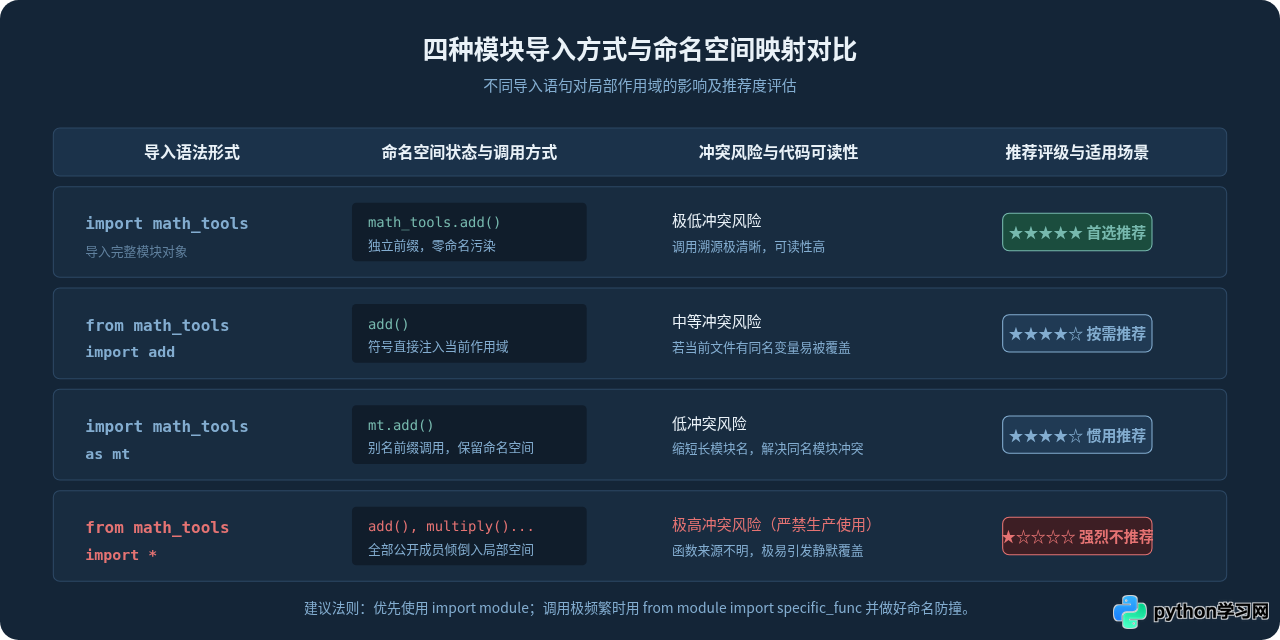
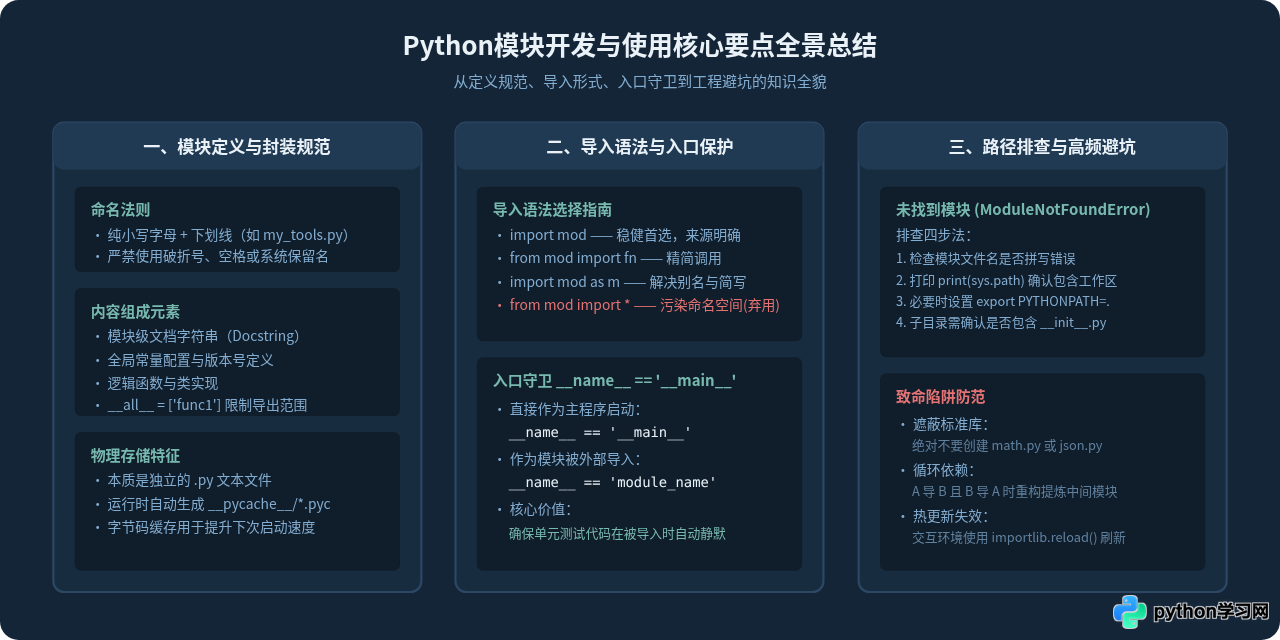
在实际编码中,Python提供了多种导入语法。虽然它们的终极目的都是让调用者能够访问模块内部的资源,但它们在命名空间污染程度、代码阅读成本和潜在名称冲突风险上有明显差别。
1. 完整导入:import 模块名
这是最稳妥、最清晰的导入方式。它将整个模块对象引入当前作用域,使用其中的函数或变量时,必须带上模块名前缀:
import math_tools

result = math_tools.add(15, 30)
price_text = math_tools.format_currency(1299.5)
print(result)       # 输出:45
print(price_text)   # 输出:¥1,299.50
优点:一眼就能看出函数来自哪个模块,绝不会意外覆盖本地同名变量。
2. 精确导入:from 模块名 import 目标对象
如果模块中只有少数一两个高频使用的函数,每次都输入前缀可能稍显繁琐,可以直接把目标导入到当前命名空间:
from math_tools import add, format_currency

# 直接调用,无需加 math_tools.
res = add(100, 200)
print(res)  # 输出:300
注意:如果当前脚本也定义了一个名为 add 的函数,后定义的函数会覆盖先导入的函数,导致逻辑混乱。
3. 别名导入:import 模块名 as 别名
当模块名称较长(或者为了遵循数据科学领域的惯例,如 import numpy as np),或者为了解决不同模块中有同名函数的问题时,可以使用 as 赋予别名:
import math_tools as mt

total = mt.multiply(6, 7)
print("乘积:", total)  # 输出:乘积: 42
4. 通配符导入:from 模块名 import *
通配符导入会将模块中除了以下划线开头的全部公开变量和函数一次性复制进当前作用域:
from math_tools import *

# 危险操作:隐式载入所有成员
print(VERSION)
print(multiply(4, 5))
强烈建议避免在生产代码中使用:这会导致代码阅读者无法得知变量来自何方,极易引发不可预知的名称覆盖灾难。
三、运行与导入的隔离锁:if __name__ == '__main__':
很多初学者在编写模块时,经常会在文件底部写几行调用代码来测试函数是否正常运行。例如在 math_tools.py 底下加上:
# 错误示例:没有防护的测试代码
print("测试加法:", add(2, 3))
这时候会出现一个严重的问题:当其他脚本(比如 main.py)执行 import math_tools 时,这行测试代码也会被直接执行并在控制台打印出来!这是因为 Python 在第一次导入模块时,会从头到尾解释执行该文件中的所有顶级语句。
为了让模块既能作为独立脚本运行自测,又能在被其他文件导入时不触发多余代码,Python 提供了内置变量 __name__:
- 当文件直接被终端运行(例如
python math_tools.py)时,Python 会将__name__自动赋值为字符串"__main__"。 - 当文件被其他文件作为模块导入(例如
import math_tools)时,__name__的值则是该模块自身的文件名(即"math_tools")。
因此,标准的模块自测写法如下:
# math_tools.py 规范结构
def add(a, b):
    return a + b

def multiply(a, b):
    return a * b

# 仅在独立运行当前文件时执行,被导入时静默
if __name__ == "__main__":
    print("[自测模式启动]")
    test_res = add(10, 20)
    print("10 + 20 验证结果:", test_res)
    assert test_res == 30, "算法逻辑异常"
    print("自测全部通过!")
四、解释器是如何找到你的模块的?(sys.path 搜索机制)
为什么你在同一个目录下的 math_tools.py 可以被顺利导入,而把文件挪到其它文件夹后就会报错 ModuleNotFoundError: No module named 'math_tools'?
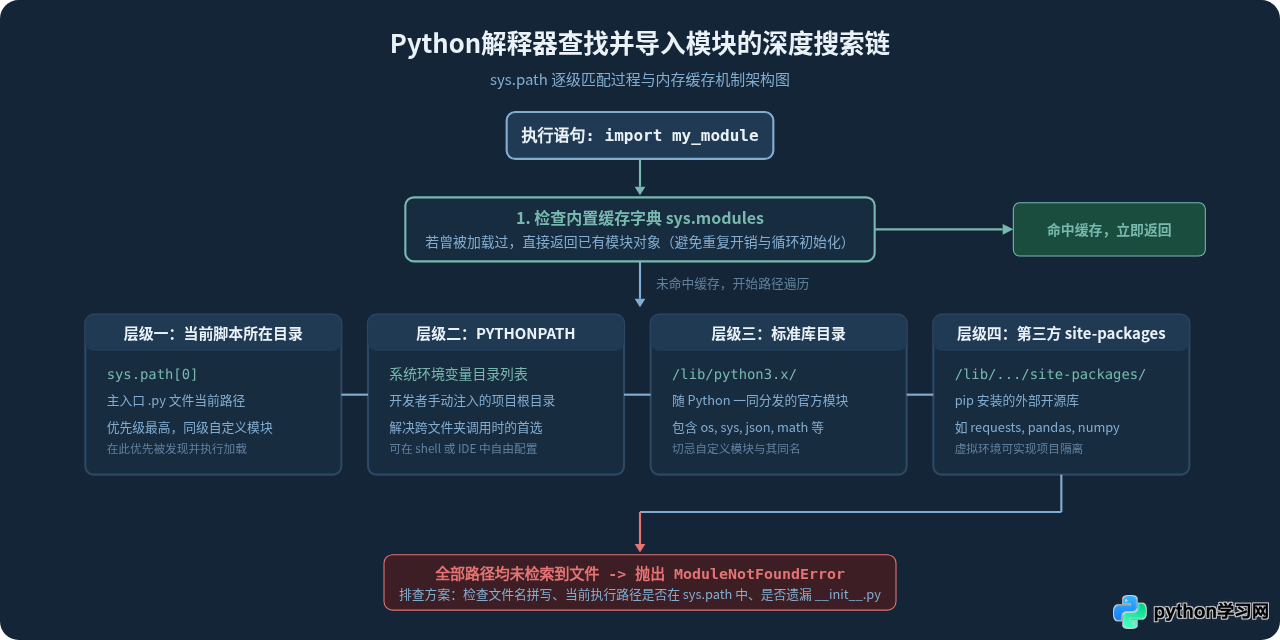
当执行 import xxx 时,Python 解释器并不会漫无目的地搜寻全盘,而是按照严格的搜索顺序在列表 sys.path 包含的路径中逐一寻找:
- 已加载模块缓存(sys.modules):检查当前模块是否已经被导入过,若是则直接返回引用,避免重复加载。
- 当前主执行脚本所在的目录:入口脚本所在的直接父目录永远排在搜索列表的第一位。这也是同目录下模块可直接导入的原因。
- PYTHONPATH 环境变量:如果用户在系统环境中配置了该环境变量,Python 会优先扫描其中的目录。
- Python 标准库目录:系统自带的内置库路径(例如
os、sys、math等)。 - 第三方库目录(site-packages):通过
pip install安装的外部轮子均存放在此处。
如果遍历完所有上述路径仍未找到名为 xxx.py 的文件或包,解释器就会抛出 ModuleNotFoundError 异常。
五、模块开发中的三大常见误区与避坑方案
1. 文件名与标准库或第三方库“同名撞车”
很多新手随手将测试文件命名为 math.py、random.py、json.py 或 test.py。根据上一节介绍的 sys.path 优先级,当前目录排在最前面!如果你在同级目录下放了一个 math.py 并写了一句 import math,Python 会导入你自己写的空文件,从而导致后续调用 math.sqrt() 时报错 AttributeError: module 'math' has no attribute 'sqrt'。
custom_math_tools.py,绝对不要与 Python 内置关键字或常用库同名。
2. 模块间的循环导入(Circular Import)
当模块 A 在开头写了 import B,而模块 B 的开头又写了 import A 时,解释器在初始化 A 时会跳转去初始化 B,但在 B 中试图加载 A 的函数时,A 尚未完成定义,从而触发:
ImportError: cannot import name 'xxx' from partially initialized module 'A' (most likely due to a circular import)
解决办法:
- 代码解耦(首选):将两者共同依赖的数据结构或工具函数抽离到一个独立的第三模块(如
common.py)中。 - 延迟导入:将
import语句移入具体需要使用的函数体内部,在调用函数时再按需加载。
3. 模块热重载问题(交互式环境常见)
在 Jupyter Notebook 或 Python 交互式命令行中,如果外部的 math_tools.py 被修改了,仅仅在终端再次执行 import math_tools 并不会重新加载新代码,因为 sys.modules 缓存仍然有效。此时必须使用标准库的重载工具:
import importlib
import math_tools

# 强制重新读取磁盘上的最新代码
importlib.reload(math_tools)
六、进阶思考:从单文件模块到包(Package)
随着项目进一步扩大,单个 .py 模块可能会变得过于庞大。此时,Python 支持将多个模块组织成一个包(Package)。包在文件系统上体现为一个包含 __init__.py 文件的文件夹。在包结构下,你可以通过点号分层导入,例如:
from my_package.math_tools import add
from my_package.string_tools import clean_text
掌握了单文件模块的创建、四种导入语法、__name__ 防护和 sys.path 查找规则之后,迈向大型工程的包管理与模块架构就会变得水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









