

数据科学与AI领域为何首选Python:就业前景与生态优势
深度解析数据科学与AI领域首选Python的底层原因:从胶水语言的高性能C/C++/CUDA双层计算架构,到端到端全生命周期工具链闭环;系统对比Python与R、C++、Julia的工业落地差异,并提供四大主流岗位的技能矩阵与避坑实践指南。
一、生态协同优势:胶水语言与高性能计算底层的完美结合
初学者和软件工程师在初次接触数据科学时,常常提出一个直接疑问:“Python是单线程解释型语言,存在全局解释器锁(GIL),循环运行速度比C++慢数十倍甚至上百倍,为什么偏偏成为了算力开销极大的数据科学与AI的首选?”
看似合理的判断:在CPU单核上运行纯Python的多层嵌套 for 循环进行十亿次矩阵乘法,耗时确实极长,完全无法满足工业级训练与实时分析的要求。
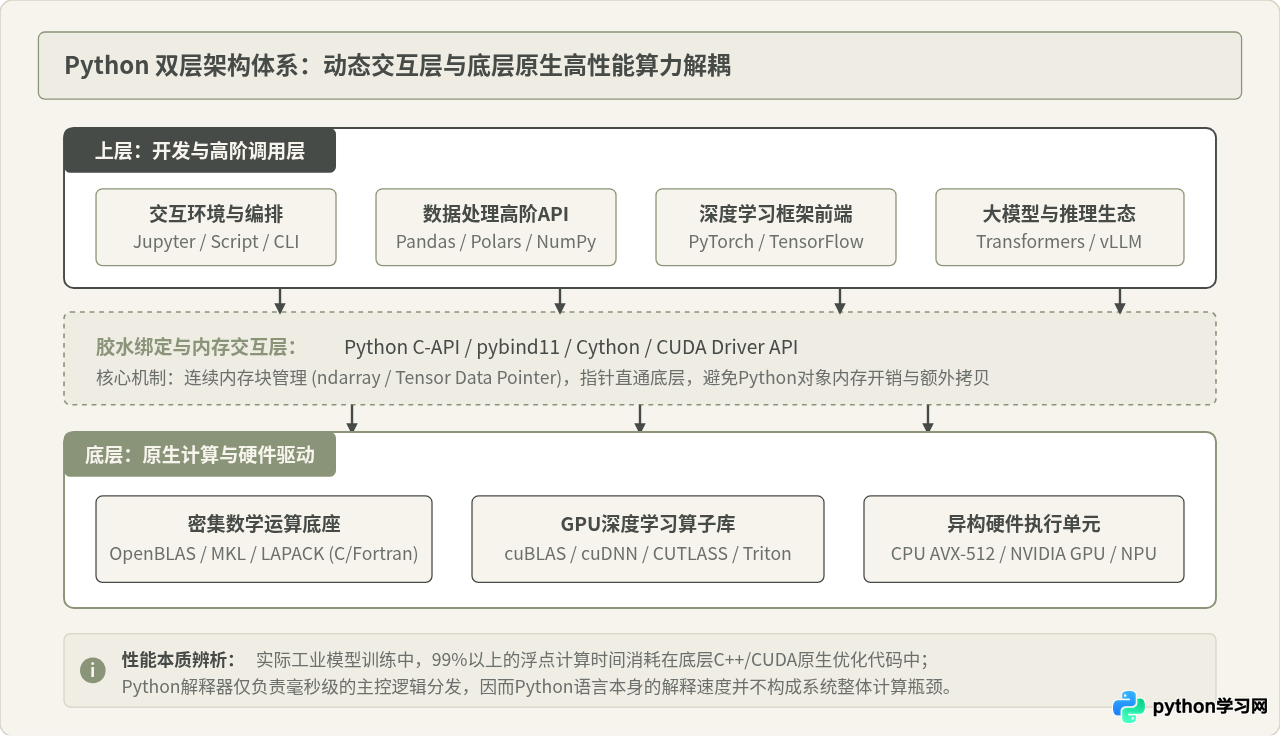
技术现实与修正:现代数据科学绝不会在Python层面做标量迭代。Python在系统架构中担任的是“高层业务编排器与胶水控制台”。真正的重度计算(张量乘法、卷积运算、自动微分、反向传播),全部由下层的C、C++、Fortran或CUDA实现(例如OpenBLAS、MKL、cuDNN、TensorRT)。Python通过紧凑的内存指针(如 PyArrayObject 与 at::Tensor)直接调用底层原生动态库,密集计算耗时占整机运算时间的99%以上,Python解释器仅耗费微秒级时间发起一次API分发,因此语言本身的解释速度根本不构成整体吞吐瓶颈。
这种“上层极度敏捷,底层极致高效”的双层架构设计,使算法工程师可以用接近数学伪代码的语法快速验证假设,同时享受到与硬件极限贴合的计算加速。以下架构图清晰展示了这一分层解耦机制:
以最基础的矩阵向量计算为例,我们可以通过一段简明的代码直观对比纯解释循环与底层向量化调用的性能差距:
import time
import numpy as np

size = 2_000_000
data_a = list(range(size))
data_b = list(range(size))

# 方式一:纯 Python 原生循环(仅在 Python 解释器内串行运算)
start_py = time.perf_counter()
result_py = [data_a[i] + data_b[i] for i in range(size)]
dur_py = time.perf_counter() - start_py

# 方式二:NumPy 向量化计算(Python 分发指令,底层 C 语言连续内存 SIMD 运算)
arr_a = np.array(data_a, dtype=np.int64)
arr_b = np.array(data_b, dtype=np.int64)
start_np = time.perf_counter()
result_np = arr_a + arr_b
dur_np = time.perf_counter() - start_np

print(f"原生Python列表推导耗时: {dur_py:.4f} 秒")
print(f"NumPy 底层C向量化耗时: {dur_np:.4f} 秒 (加速约 {dur_py / dur_np:.1f} 倍)")
# 示例输出参考(具体耗时取决于测试硬件配置):
# 原生Python列表推导耗时: 0.1650 秒
# NumPy 底层C向量化耗时: 0.0035 秒 (加速约 47.1 倍)for 循环操作大规模表格或矩阵数据,应优先使用向量化广播(Broadcasting)或批处理API。一旦在核心运算逻辑中引入了低效的Python对象拆箱装箱,双层架构的高性能优势将被抵消。
二、全生命周期工具链覆盖:从数据清洗到大模型微调
在现实的企业项目中,模型训练往往只占项目全生命周期的20%左右,剩余的80%工作涉及数据源抓取、数据质检、探索性分析(EDA)、特征工程、模型格式转换以及API服务化上线。如果不同阶段使用不同语言(例如数据提取用SQL、统计用R、训练用C++、后端部署用Java),整个跨部门团队将面临巨大的上下文切换成本与模型跨平台序列化开销。
Python无可替代的核心优势在于形成了涵盖数据全生命周期的完整软件生态。无论哪个环节,都有经过数十年工业验证的行业标准库:
- 数据摄取与清洗:
Pandas与新一代多线程计算引擎Polars提供了强大的表格操作能力;结合PyArrow实现大规模列式存储的零拷贝传递; - 科学计算与统计分析:
NumPy提供标准N维数组与线性代数,SciPy与Statsmodels覆盖正态检验、假设检验与因果分析; - 探索性可视化:
Matplotlib提供精细度最高的发表级制图,Seaborn简化统计图表生成,Plotly支持交互式看板; - 经典机器学习:
Scikit-learn、XGBoost与LightGBM规范了标准化Fit-Predict工作流,成为表格数据处理的工业支柱; - 深度学习与前沿大模型:
PyTorch成为全球顶会论文与开源项目的首选框架,Hugging Face Transformers成为NLP领域的事实工业规范,vLLM提供吞吐极高的大模型流式推理引擎。
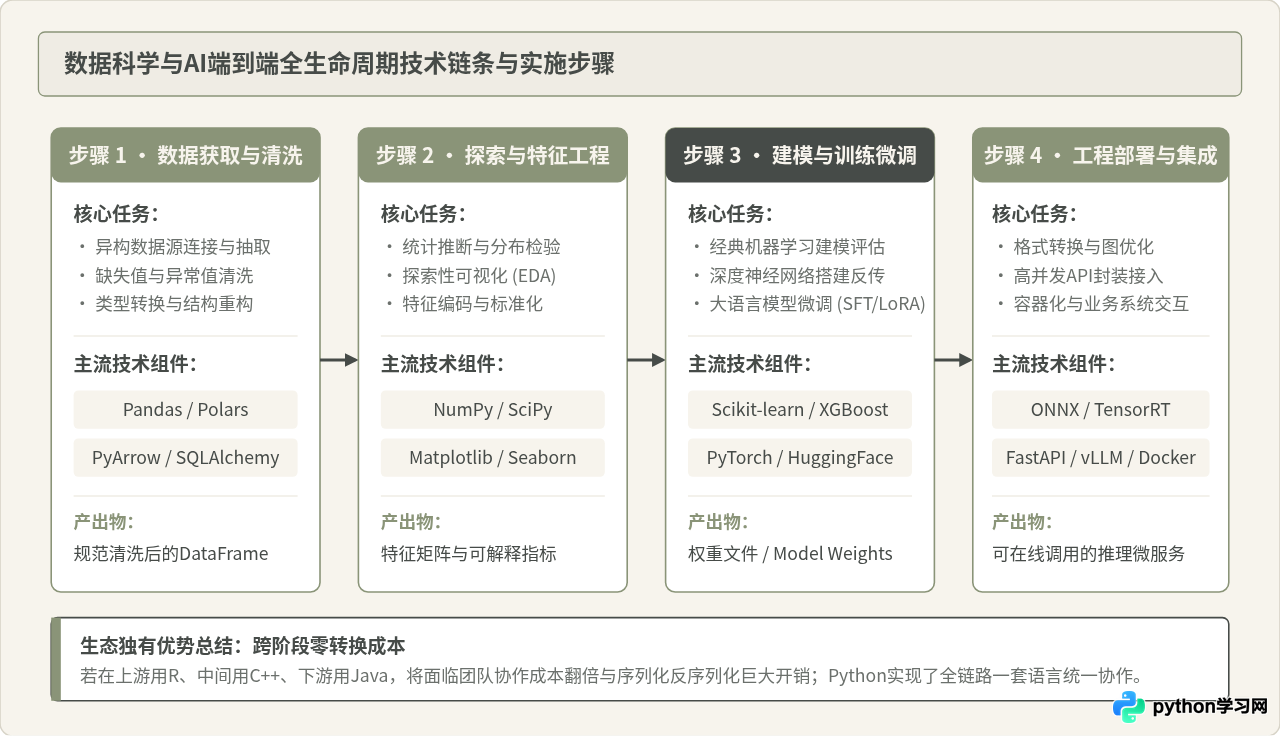
这一全流程链条的顺畅度体现在代码的连续性上。工程师无需在不同环境间做繁琐的格式导出,几行简洁代码即可完成从表格特征提取到PyTorch张量建模的衔接:
import pandas as pd
import torch
import torch.nn as nn
from sklearn.preprocessing import StandardScaler

# 1. 数据读取与预处理
df = pd.DataFrame({
    'feature_1': [12.5, 18.2, 14.1, 25.0, 31.2],
    'feature_2': [0.12, 0.45, 0.23, 0.88, 0.95],
    'target': [0, 1, 0, 1, 1]
})

# 2. 统计转换与特征标准化
scaler = StandardScaler()
features_scaled = scaler.fit_transform(df[['feature_1', 'feature_2']])

# 3. 零成本转化为深度学习张量(直接共享底层连续内存)
tensor_x = torch.from_numpy(features_scaled).float()
tensor_y = torch.tensor(df['target'].values, dtype=torch.float32).unsqueeze(1)

# 4. 构建轻量分类模型
model = nn.Sequential(
    nn.Linear(2, 4),
    nn.ReLU(),
    nn.Linear(4, 1),
    nn.Sigmoid()
)

output = model(tensor_x)
print(f"输入特征张量尺寸: {tensor_x.shape}, 模型前向预测输出尺寸: {output.shape}")
# 示例输出:输入特征张量尺寸: torch.Size([5, 2]), 模型前向预测输出尺寸: torch.Size([5, 1])
三、工业落地与多维选型:为什么Python赢得了就业市场
在数据分析与AI演进历史上,并非只有Python一种选择。统计学界有底蕴深厚的R语言,高性能计算有速度极限的C++与CUDA,科学计算领域有设计优雅的Julia,数据库内部有天然操作数据的SQL。理解Python为何最终脱颖而出,需要将其放置在工业落地与商业成本的全局视野中权衡。
看似合理的判断:R语言由统计学家设计,拥有CRAN上数万个极其细分的专业统计与计量经济学工具包,单就统计模型表达与生物医学实验分析而言,R代码往往比Python更加精确典雅。
技术现实与修正:在学术实验室与独立研究中,R确实表现优异;但商业企业的本质要求是“产品落地与系统闭环”。训练出的模型不能停留在数据科学家的个人笔记本里,它需要封装为高并发RESTful/gRPC接口、对接到用户APP、结合Kafka消费实时流数据、打包到Docker镜像中部署到Kubernetes集群。Python本身是一门完善的通用高级语言(General-Purpose Language),能够无缝调用 FastAPI、Celery、SQLAlchemy 等工程库,而R在通用软件工程集成方面配套偏弱。企业倾向于招聘能够“一条龙”推进到工程上线的Python人才,直接降低跨职能部门沟通的人员成本。
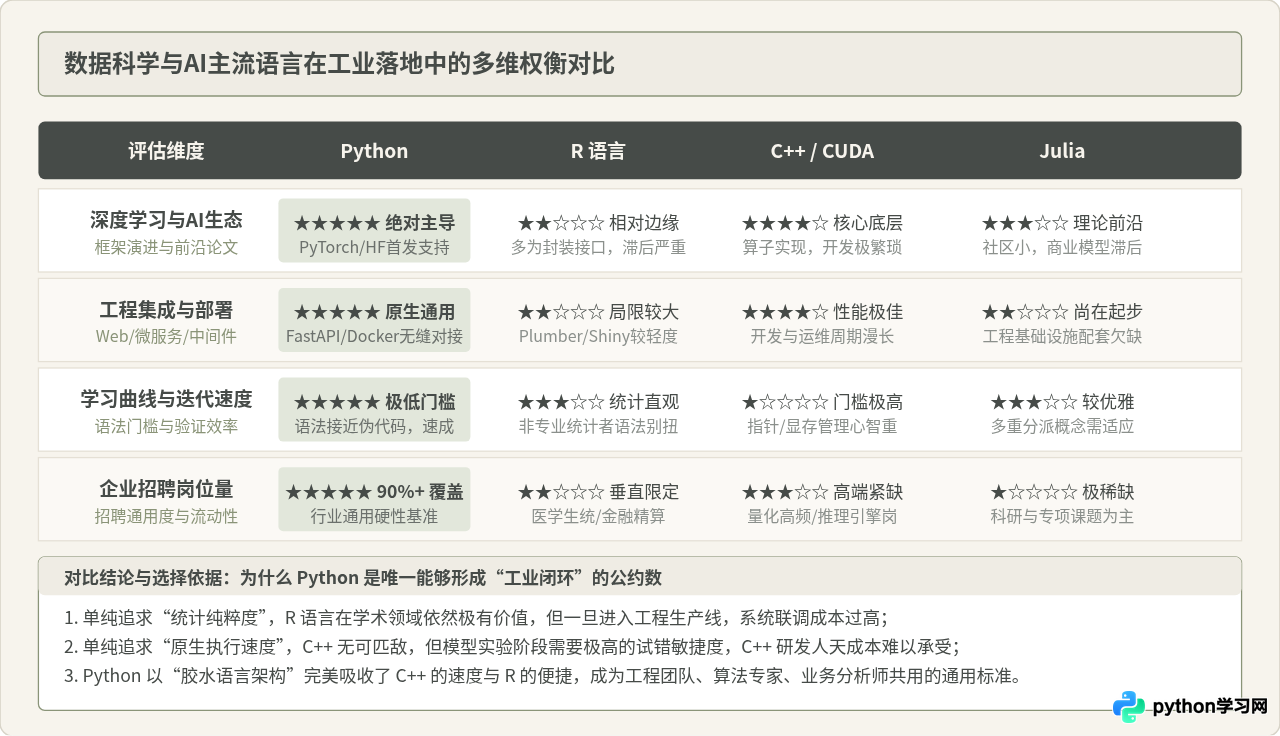
正是这种“兼顾算法敏捷度与通用工程集成度”的特性,使Python在各类企业招聘画像中成为覆盖面最广的核心要求。不论是互联网大厂、金融量化对冲基金,还是智能制造与传统产业数字化转型部门,Python均位列技术栈必备首位。
四、就业前景与技能映射:四大主流职业路径
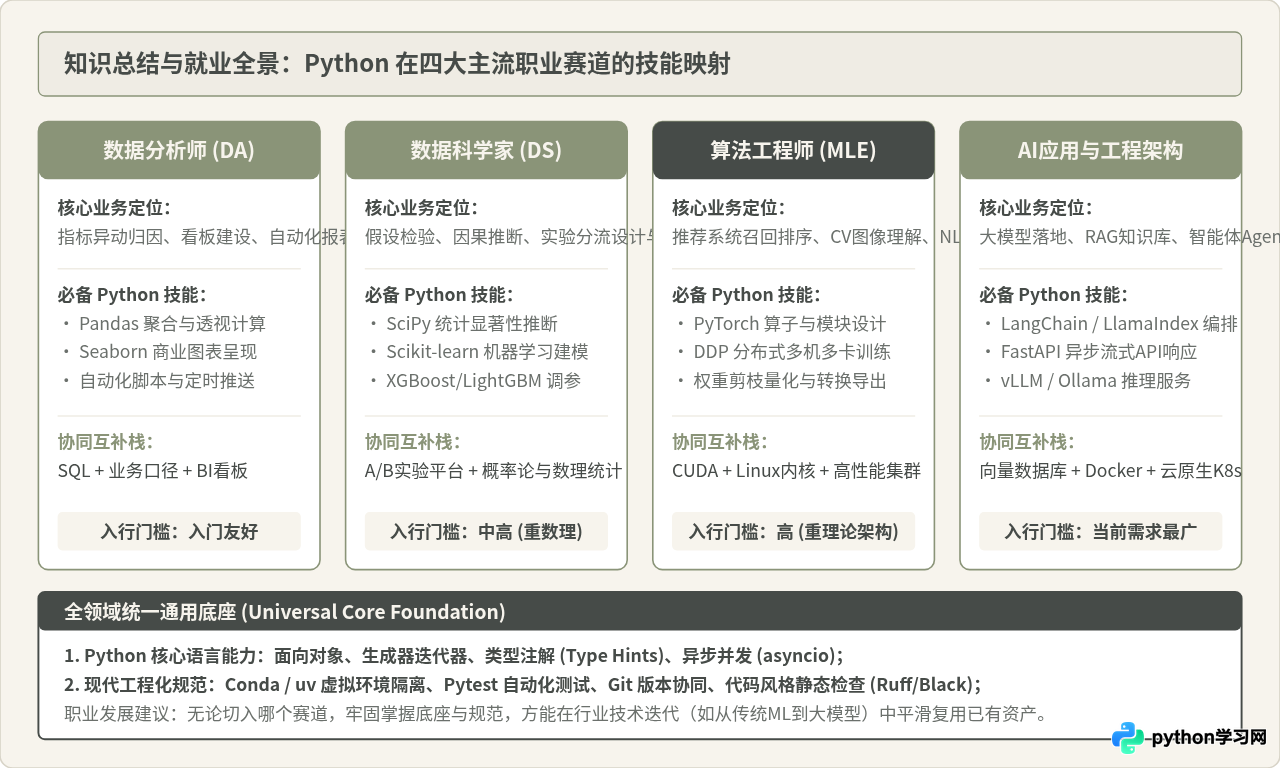
数据科学与AI并不是单一的岗位,而是由多个专业分工协同构成的职业集群。许多学习者面临的困惑往往不是“要不要学Python”,而是“学了Python语法后,该往哪个具体方向深入”。根据工业界的实际岗位划分,主要分为四大核心方向:
1. 数据分析师(Data Analyst)
岗位定位:业务的侦查兵与决策辅助者。核心任务是通过数据洞察发现业务增长点、诊断业务漏斗与异常波动。
核心技术栈:深入熟练使用 SQL 提取数仓数据,使用 Pandas 进行异构数据融合与透视,运用 Matplotlib/Seaborn 制作直观的业务图表,并编写自动化脚本替代繁琐的人工Excel报表操作。
2. 数据科学家(Data Scientist)
岗位定位:兼具扎实统计学素养与算法建模能力的业务专家。核心任务是设计因果推断框架、规划线上A/B测试分流、构建用户生命周期与流失预测模型。
核心技术栈:在熟练掌握数据分析的基础上,要求深入理解 SciPy 统计假设检验、Scikit-learn 特征管道,以及 XGBoost / LightGBM 等梯度提升树算法的超参数调优与特征贡献归因(SHAP值分析)。
3. 机器学习 / 深度学习算法工程师(ML/DL Engineer)
岗位定位:复杂AI模型的技术攻坚者,专注于计算机视觉(CV)、自然语言处理(NLP)或推荐搜索系统的核心算法设计。
核心技术栈:精通 PyTorch 计算图机制与自定义算子编写,熟练掌握多机多卡分布式数据并行训练(DDP),掌握模型低比特量化(INT8/FP4)、剪枝与ONNX格式导出,对底层显存优化与CUDA内核原理有深入理解。
4. AI应用与大模型工程架构师(AI Application / LLM Engineer)
岗位定位:当前招聘市场增长最迅速的新兴赛道,专注于将前沿大语言模型与企业私有知识库及核心业务流程无缝打通。
核心技术栈:精通 LangChain 或 LlamaIndex 编排框架,熟练构建企业级检索引擎与向量检索(RAG)管道,掌握 FastAPI 异步流式接口开发,能够使用 vLLM 等高效推理框架在私有GPU集群上部署开源大模型并进行LoRA轻量化微调。
五、工程化落地避坑指南与实施建议
要想在实际项目和团队协作中真正发挥Python的生态优势,避免沦为“只能在本地Notebook跑玩具脚本”的初级开发者,必须建立严格的工程化习惯:
- 必须使用严格的环境隔离工具:数据科学库(尤其是涉及CUDA编译依赖的PyTorch、TensorFlow和vLLM)对底层C++动态库及驱动版本极其敏感。切勿在系统全局Python环境中直接
pip install。建议使用conda、mamba或现代轻量工具uv,为每个独立项目维护明确的虚拟环境与requirements.txt/pyproject.toml。 - 规避大对象隐式拷贝造成的内存溢出(OOM):在Pandas中进行多表关联(
merge)或大批量特征衍生时,优先使用inplace操作或就地重新赋值,处理超千万行的大数据集时可迁移至基于Rust开发的Polars,以享受惰性求值(Lazy Evaluation)和多核并行优化的内存红利。 - 规范从实验到生产的代码重构:Jupyter Notebook是绝佳的探索与验证工具,但严禁将充满乱序执行单元格的
.ipynb文件直接扔上生产服务器。探索完成后,应将通用数据清洗函数与特征计算逻辑抽离为结构化的.py模块,编写对应的单元测试(pytest),并通过Docker容器打包部署,确保线上线下环境行为完全一致。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









