

Python使用pathlib动态构建Excel文件路径的最佳实践
详细解析在Python中使用标准库pathlib动态构建Excel文件路径的最佳实践,包含代码基准锚定、动态时间戳分卷、幂等目录初始化、路径穿越安全防御以及生产级自动化封装。
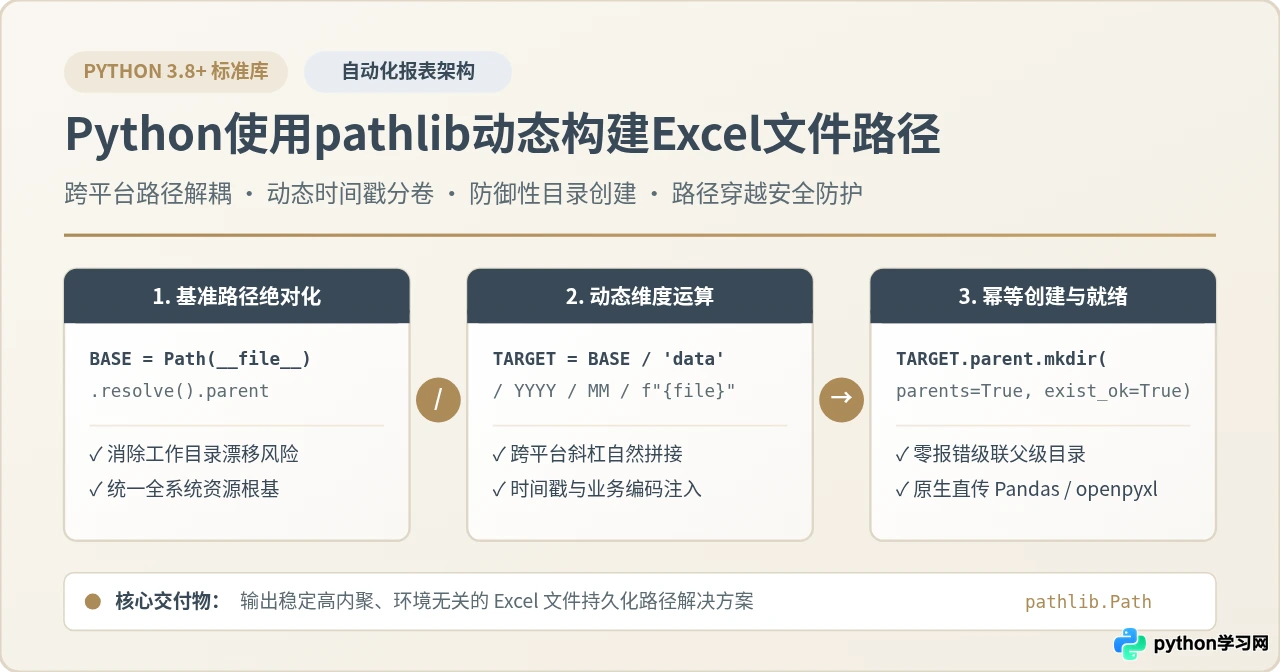
pathlib.Path,可以通过基于代码文件的绝对基准锚定、/ 运算符的强类型拼接、结合 strftime 的动态命名,以及 mkdir(parents=True, exist_ok=True) 幂等创建,彻底解决多操作系统路径分隔符不一致、工作目录漂移及路径穿越安全隐患。
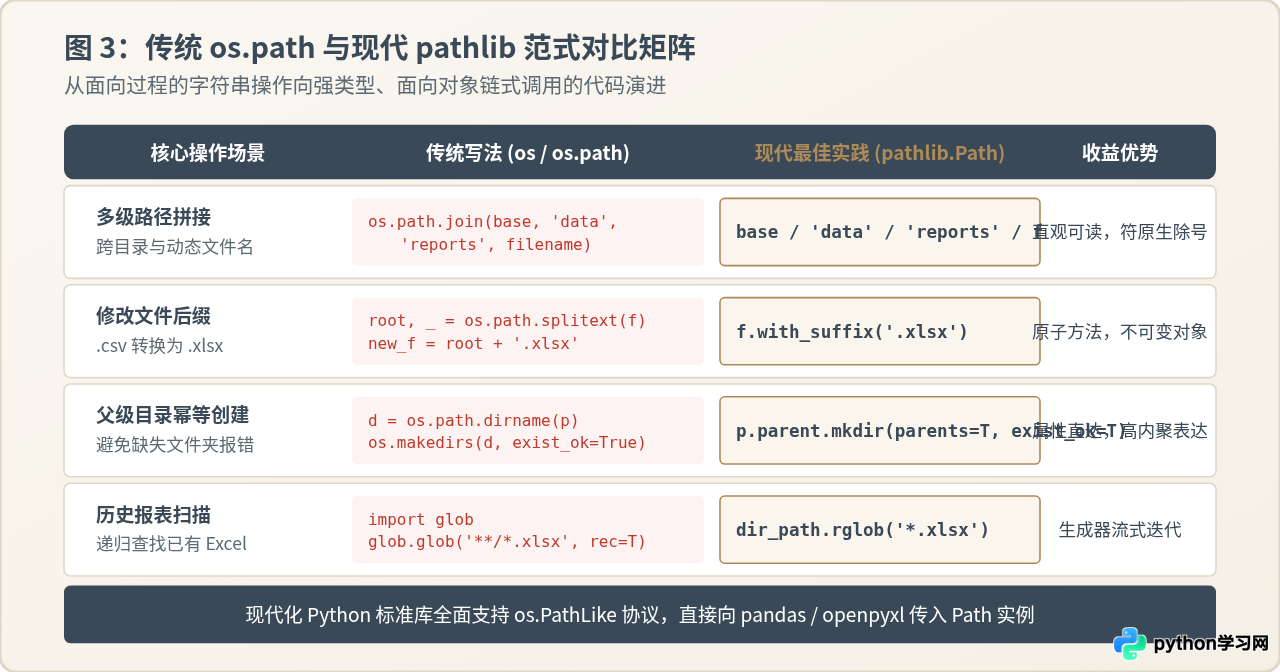
一、弃用 os.path:现代路径处理的范式转变
早期 Python 脚本广泛采用 os.path.join()、os.path.dirname() 与字符串加号拼接来构造报表文件名。这种做法的本质是将文件路径视作纯文本字符串。纯字符串操作在动态处理 Excel 路径时往往暴露出几项明显缺陷:不同操作系统间斜杠方向(Windows 的反斜杠 \ 与 POSIX 的正斜杠 /)极易引发转义失误;使用加号手动拼接扩展名 .xlsx 容易导致双重后缀或遗漏点号;且每次在创建父目录、获取上级路径时,都需要嵌套调用多层面向过程函数,代码可读性与可维护性较低。
Python 3.4 引入并在 3.6+ 全面成熟的 pathlib 模块改变了这一模式。它将文件与目录路径抽象为纯正的面向对象类型(Path 实例)。在 pathlib 中,路径拼接直接使用重载的除法运算符 /,底层会自动根据当前宿主操作系统解析正确的分隔符。此外,自 Python 3.6 起,标准库全面支持 PEP 519(文件系统路径协议),无论是 pandas.DataFrame.to_excel() 还是 openpyxl.load_workbook(),均原生接受 Path 对象,无需任何显式 str() 转换。
二、基准锚定:消除当前工作目录(CWD)漂移
很多自动化脚本在本地编辑器运行正常,但在接入 Crontab 定时任务、Airflow 调度器或以模块方式调用时,往往抛出 FileNotFoundError。其根本原因在于开发人员使用了相对于“当前工作目录”(即 os.getcwd())的相对路径(如 output/2026/report.xlsx)。脚本的当前工作目录取决于执行 python 命令时终端所在的路径,而非脚本代码本身所在的位置。
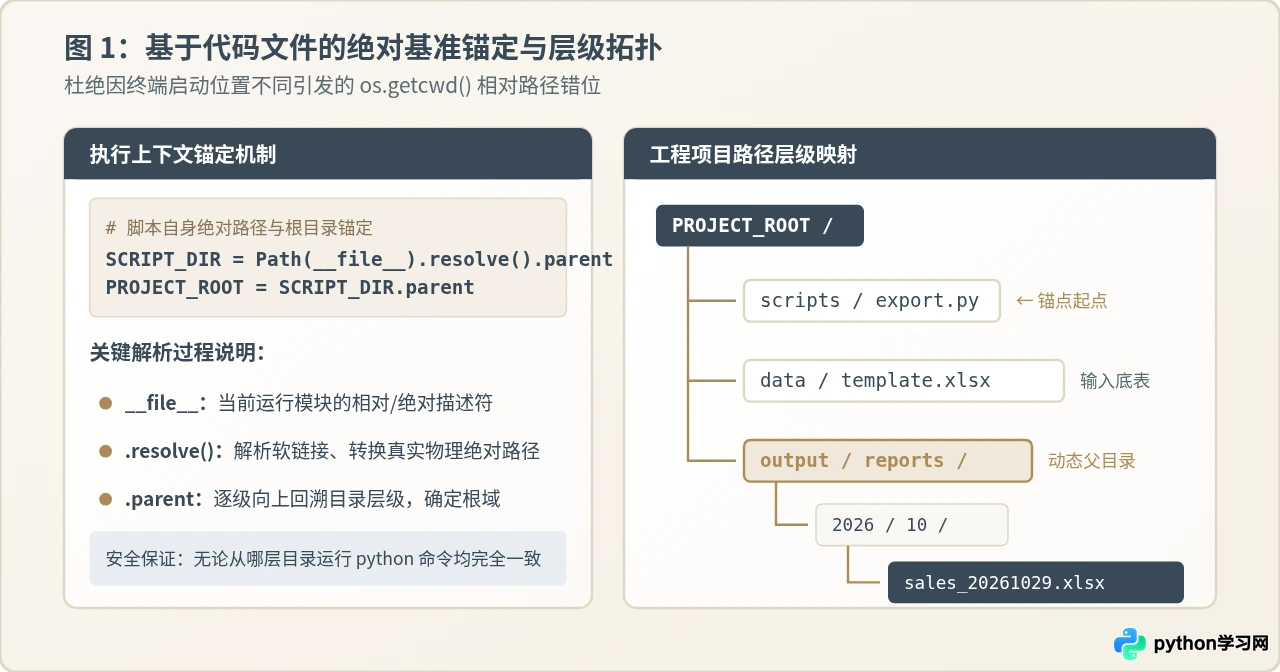
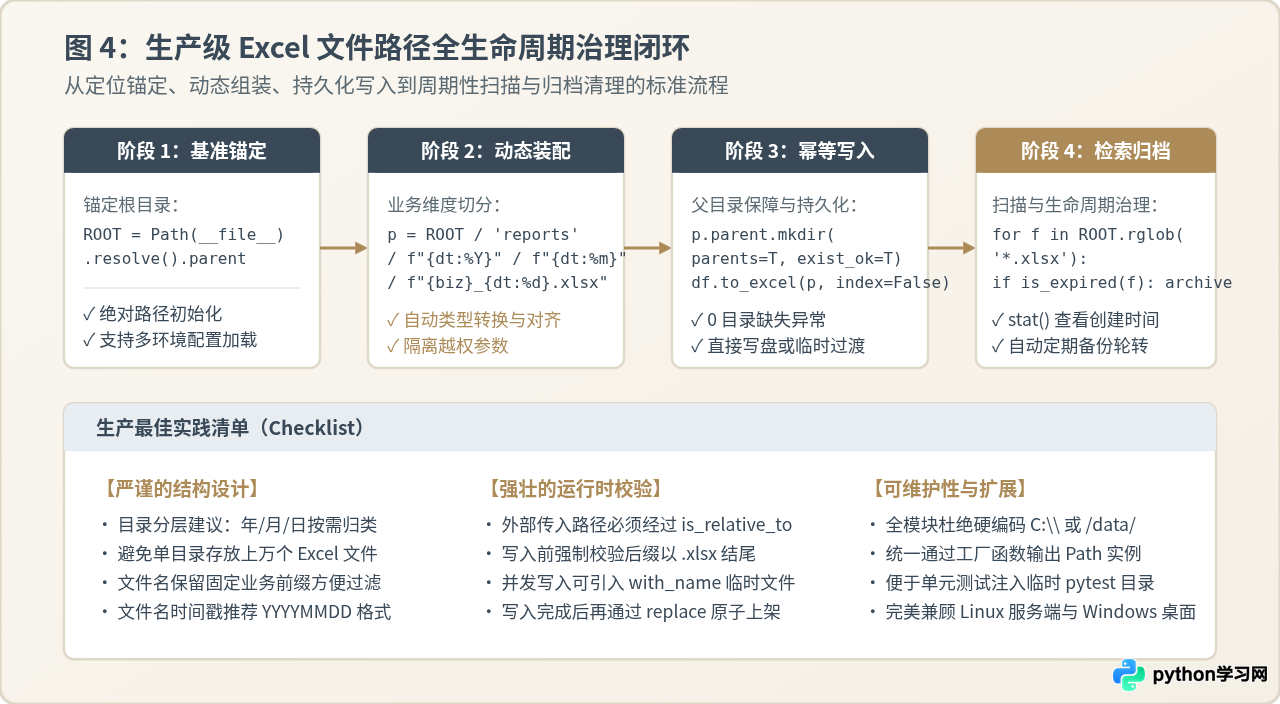
构建动态 Excel 路径的第一步,必须是基准路径的显式绝对化锚定。工程实践中推荐使用当前脚本文件的魔术变量 __file__,通过 Path(__file__).resolve().parent 计算出确定无疑的脚本所在物理目录,再按工程分层向上回溯定位项目根目录:
from pathlib import Path

# 获取当前脚本文件的绝对父目录
CURRENT_SCRIPT_DIR = Path(__file__).resolve().parent

# 定位项目工程根目录(假设脚本位于 /scripts 目录下)
PROJECT_ROOT = CURRENT_SCRIPT_DIR.parent

# 确立数据输入与导出根基准
TEMPLATES_DIR = PROJECT_ROOT / "data" / "templates"
EXCEL_OUTPUT_DIR = PROJECT_ROOT / "output" / "reports"
Path.resolve() 方法能够彻底解析任何相对符号链接(Symlink)与相对引用(如 ..),将其展开为唯一的、物理层面的绝对路径。确立了 PROJECT_ROOT 之后,后续所有业务报表子目录与动态文件名均以此为根源逐步派生。
三、动态构建规则:时间切片与业务维度组合
生产环境中的 Excel 报表绝大部分具有时态属性(日结报表、周度对账单、月度汇算清缴)和维度属性(部门编号、业务条线、客户代号)。若将所有报表平铺在一个单级文件夹中,随着运行周期推移,目录检索性能急剧恶化,且极易因同名覆盖引发数据灾难。
最佳实践是采用分层存储架构,结合 Python 的 datetime 对象与 f-string 语法,在路径中按年、月划分层级,在文件名中内嵌精确日期与业务标签:
from datetime import datetime
from pathlib import Path

def build_report_path(base_dir: Path, dept_code: str, report_date: datetime) -> Path:
    # 1. 提取时间维度
    year_str = report_date.strftime("%Y")
    month_str = report_date.strftime("%m")
    date_str = report_date.strftime("%Y%m%d")

    # 2. 规范化业务代号(去除非法字符与首尾空格)
    clean_dept = dept_code.strip().lower()

    # 3. 构造具象文件名:业务前缀_日期_类型.xlsx
    file_name = f"{clean_dept}_summary_{date_str}.xlsx"

    # 4. 动态分层拼接
    target_path = base_dir / year_str / month_str / file_name
    return target_path
datetime.now().isoformat())直接写入路径,因为 ISO 格式包含冒号 :,在 Windows 文件系统中属于非法文件名保留字符,将导致静默失败或写入抛错。推荐统一使用紧凑下划线格式(例如 YYYYMMDD_HHMMSS)。
四、防御性安全设计与目录幂等初始化
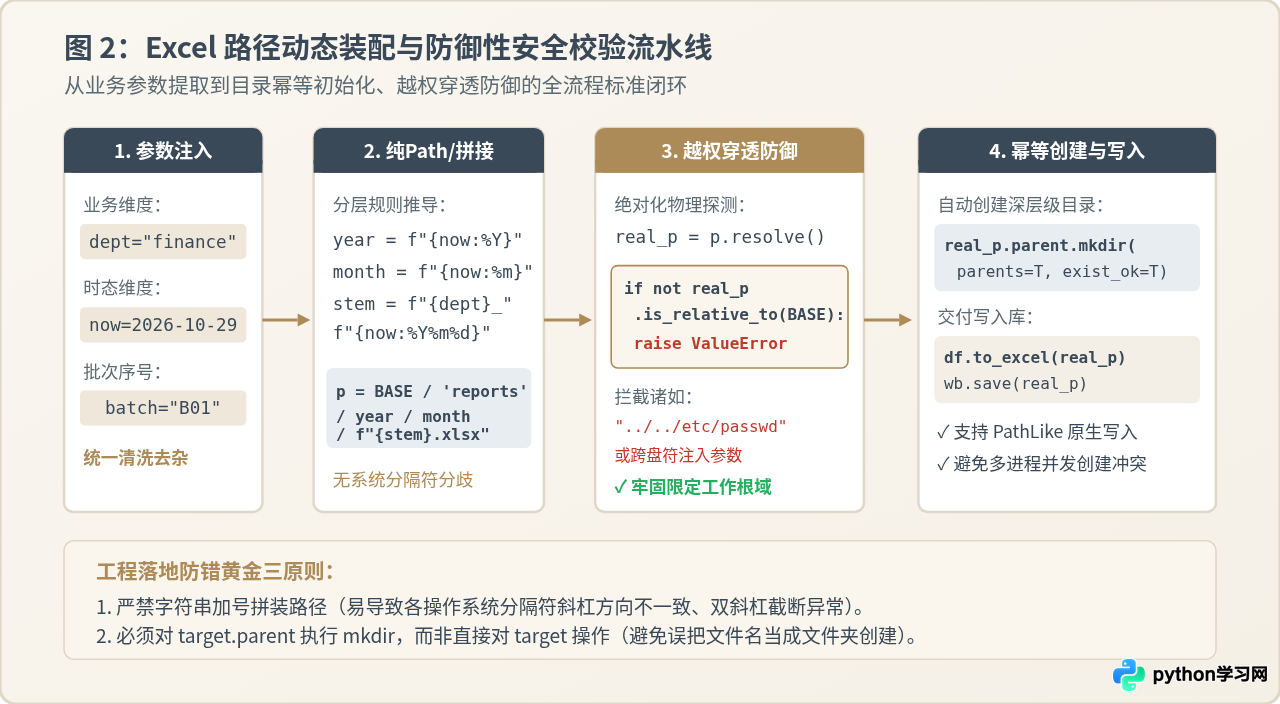
动态组装路径之后,不能直接将其交给 Pandas 进行写入。生产代码必须经过两道关键防线:路径穿越校验与幂等目录预建。
1. 防御路径穿越漏洞(Path Traversal)
在许多 Web 报表导出系统或接受外界参数(如前端传参、消息队列指令)的任务中,dept_code 或业务子目录名称可能由不可信输入提供。如果攻击者传入 ../../etc 或恶意的跨目录字符串,直接使用 / 进行拼接可能使最终路径跳出预期的基准目录。
Python 3.9+ 提供了原生方法 path.is_relative_to(base),可严密校验目标路径是否严格受控于根存储域内:
def safe_resolve_path(target_path: Path, allowed_base: Path) -> Path:
    resolved = target_path.resolve()
    # 严密检查:目标绝对路径必须位于允许的根目录下
    if not resolved.is_relative_to(allowed_base.resolve()):
        raise ValueError(f"检测到非法路径穿越尝试:{resolved} 不在 {allowed_base} 范围内")
    return resolved
2. 幂等目录初始化
直接向一个尚未存在的深层级路径保存 Excel 文件时(如 output/reports/2026/10/summary.xlsx),Excel 引擎(如 openpyxl / xlsxwriter)会直接抛出 FileNotFoundError: [Errno 2] No such file or directory。
传统做法是在写文件前进行 os.path.exists() 检查并调用 os.makedirs(),这不仅繁琐,还在高并发场景下存在检查-创建(TOCTOU)竞态问题。使用 pathlib 时,只需一行代码对目标文件的父级对象调用 mkdir:
# 核心操作:对 target_path.parent 进行级联幂等创建
target_path.parent.mkdir(parents=True, exist_ok=True)
参数 parents=True 保证从根部到叶子节点缺失的每一级中间文件夹均被自动补齐;exist_ok=True 保证目录已存在或多个进程同时创建时静默放行,无需编写繁杂的 try-except 保护块。
五、后缀原子管理与历史报表扫描
在报表自动化流程中,经常遇到导入 CSV 底表并转换输出为 Excel,或在 .xlsx 与 .xlsm 之间变更格式的需求。pathlib 提供了极具表现力的原子属性和方法:
path.suffix:快速读取文件扩展名(返回字符串,如.xlsx)。path.stem:获取纯文件名,剥离所有扩展名(如sales_20261029)。path.with_suffix('.xlsx'):返回一个具有新扩展名的全新Path对象,无需人工处理截断与点号。path.with_name('new_file.xlsx'):替换同目录下的文件名,常用于快速生成临时交换文件。
当需要对归档目录下的历史 Excel 报表执行巡检、合并或清理时,无需引入 glob 模块,直接调用路径对象的 rglob() 即可进行递归生成器迭代:
# 递归查找 output_dir 及其所有子目录下全部 .xlsx 报表
for excel_file in EXCEL_OUTPUT_DIR.rglob("*.xlsx"):
    # 忽略临时备份文件与系统隐藏文件
    if excel_file.stem.startswith("~"):
        continue
    file_size_kb = excel_file.stat().st_size / 1024
    print(f"发现报表: {excel_file.relative_to(PROJECT_ROOT)} ({file_size_kb:.1f} KB)")
六、生产级完整实战封装
以下提供一套在实际工业生产中可直接落地的完整 Excel 报表路径构建器与导出函数,已集成上述基准锚定、类型安全、路径穿越防御与并发安全控制:
import re
from datetime import datetime
from pathlib import Path
from typing import Optional
import pandas as pd

class ExcelPathFactory:
    '''生产级 Excel 动态路径构建与生命周期管理工厂'''

    def __init__(self, base_root: Optional[Path] = None):
        # 锚定基准:若未显式指定,则绑定为当前执行脚本的物理父级工程目录
        if base_root is None:
            self.base_root = Path(__file__).resolve().parent.parent / "storage" / "reports"
        else:
            self.base_root = base_root.resolve()

    def generate_path(
        self,
        business_unit: str,
        report_tag: str,
        target_date: Optional[datetime] = None,
        extension: str = ".xlsx"
    ) -> Path:
        '''
        动态构建标准 Excel 导出目标路径
        '''
        dt = target_date or datetime.now()

        # 1. 业务标识清洗:仅允许英文字母、数字及中文
        clean_bu = re.sub(r"[^a-zA-Z0-9_\u4e00-\u9fa5-]", "", business_unit).strip()
        clean_tag = re.sub(r"[^a-zA-Z0-9_\u4e00-\u9fa5-]", "", report_tag).strip()

        # 2. 规范扩展名
        normalized_ext = extension if extension.startswith(".") else f".{extension}"

        # 3. 分层构建文件名:年/月/业务单元_标签_年月日_时分秒.xlsx
        year_str = dt.strftime("%Y")
        month_str = dt.strftime("%m")
        file_name = f"{clean_bu}_{clean_tag}_{dt.strftime('%Y%m%d_%H%M%S')}{normalized_ext}"

        candidate_path = self.base_root / year_str / month_str / file_name

        # 4. 越权校验与物理绝对路径解析
        final_path = candidate_path.resolve()
        if not final_path.is_relative_to(self.base_root):
            raise PermissionError(f"路径安全性违规:{candidate_path} 试图逃逸根目录")

        # 5. 幂等自动建立父级目录
        final_path.parent.mkdir(parents=True, exist_ok=True)
        return final_path

    def export_dataframe_atomic(
        self,
        df: pd.DataFrame,
        target_path: Path,
        sheet_name: str = "Sheet1"
    ) -> Path:
        '''
        原子化写入 Excel:先写入临时文件,成功后再重命名上架,避免中途报错损坏原文件
        '''
        # 使用 with_name 派生同目录临时文件
        temp_path = target_path.with_name(f".tmp_{target_path.stem}_{datetime.now().microsecond}.xlsx")
        try:
            # Pandas 原生支持传入 Path 对象
            df.to_excel(temp_path, sheet_name=sheet_name, index=False, engine="openpyxl")
            # 原子重命名覆盖目标文件
            temp_path.replace(target_path)
            return target_path
        except Exception as err:
            # 异常发生时清理残留临时文件
            if temp_path.exists():
                temp_path.unlink()
            raise IOError(f"导出 Excel 报表失败:{err}") from err


# 生产场景模拟调用示例
if __name__ == "__main__":
    factory = ExcelPathFactory()

    # 模拟业务报表数据
    sample_df = pd.DataFrame({
        "订单号": ["ORD2026102901", "ORD2026102902"],
        "销售金额": [12850.50, 43900.00],
        "状态": ["已核销", "处理中"]
    })

    # 动态组装路径
    excel_path = factory.generate_path(
        business_unit="华东事业部",
        report_tag="日营收汇算",
        target_date=datetime.now()
    )

    print(f"动态构建的目标路径: {excel_path}")
    print(f"父级文件夹已自动就绪: {excel_path.parent.exists()}")
七、生产落地避坑指南
| 常见错误写法 | 潜在隐患与报错表现 | pathlib 最佳实践推荐 |
|---|---|---|
path + "/file.xlsx" |
Path 对象与字符串相加抛出 TypeError;易导致斜杠方向与操作系统冲突。 |
统一使用除号操作符:path / "file.xlsx"。 |
target.mkdir() |
直接对包含文件名的路径创建目录,会导致生成一个名为 xxx.xlsx 的文件夹。 |
始终对其父目录操作:target.parent.mkdir(parents=True, exist_ok=True)。 |
Path("output/report.xlsx") |
依赖相对路径,当工作进程在不同子目录下启动时,文件被散落写入未知路径。 | 始终以 Path(__file__).resolve().parent 为根基锚定绝对路径。 |
p.with_suffix("xlsx") |
遗漏点号,导致生成的文件名变为 reportxlsx,损坏扩展名关联。 |
严格包含前导点号:p.with_suffix(".xlsx")。 |
八、总结
在 Python 中处理动态 Excel 文件路径时,将 pathlib.Path 作为贯穿全流程的一等公民,能够从根本上消除字符串拼接带来的隐式缺陷。通过“以代码位置绝对锚定、以面向对象操作符装配维度、以 is_relative_to 守护安全边界、以 parent.mkdir 幂等兜底”的四步法则,能够为自动化报表、数据导出管道提供兼具高可靠性与优雅架构的底层路径解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









