

Python使用requests库下载单张图片的代码示例
本文提供使用Python requests库下载单张图片的完整代码示例,深入解析流式分块写入、请求头伪装、状态校验与异常排查等核心实践细节。
在 Python 中下载网络图片,最直接且工业级通用的解决方案是使用 requests 库发起 HTTP GET 请求,并将返回的原始二进制字节流写入本地文件。为避免大尺寸图片占用过多内存,规范的标准做法是开启流式模式(stream=True)并按块(Chunk)逐步写入磁盘。本文将提供清晰完整的代码实现,并拆解从网络请求到持久化存储的关键细节与注意事项。
一、下载核心原理与标准执行流程
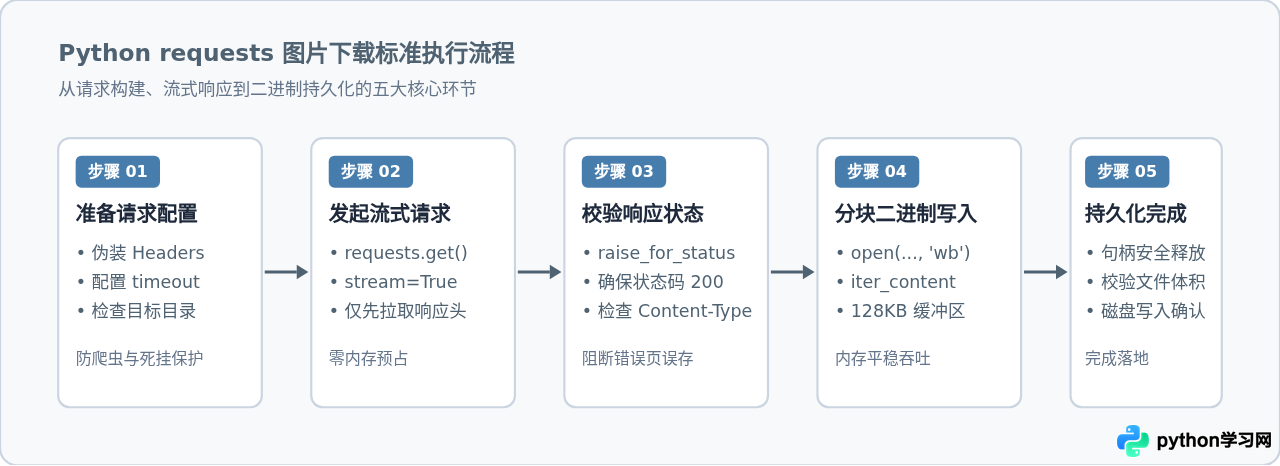
在 HTTP 协议中,图片文件与普通的 JSON 或网页 HTML 不同,它由未经字符编码的原始二进制字节构成。下载图片的底层逻辑可以精炼为以下五个关键环节:
- 构建请求配置:明确目标图片 URL,配置防拦截的
User-Agent标头以及合理的网络超时时限。 - 发起流式请求:调用
requests.get()时开启stream=True,该参数使客户端先接收 HTTP 响应头,暂不把正文全部灌入内存。 - 验证响应状态:通过
response.raise_for_status()判断状态码是否为 200,并可选校验Content-Type是否为图片。 - 以二进制模式分块写入:使用 Python 内置的
open(..., 'wb')打开目标路径,通过response.iter_content()设定固定缓冲区(如 128KB)循环写入。 - 安全关闭连接:利用
with上下文管理器自动关闭本地文件描述符与底层 TCP 连接,确保文件写入完整且无资源泄漏。
二、完整实战代码示例
以下代码提供了一个开箱即用、具备完备防御机制的函数 download_single_image。该示例已将请求头模拟、流式写入、多层异常捕获整合在一起:
import os
import requests

def download_single_image(image_url: str, save_path: str, timeout: int = 15) -> bool:
    """
    使用 requests 库下载单张图片并以二进制形式保存到指定本地文件。

    :param image_url: 图片的完整 HTTP/HTTPS 链接
    :param save_path: 保存到本地的目标文件路径(如 'images/sample.jpg')
    :param timeout: 超时时限(秒),防止由于网络阻塞导致程序无限挂起
    :return: 下载成功返回 True,发生任何异常返回 False
    """
    # 1. 模拟常见的现代浏览器请求头,避免大部分防爬虫与防盗链拦截
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/124.0.0.0 Safari/537.36"
        ),
        "Accept": "image/avif,image/webp,image/apng,image/svg+xml,image/*,*/*;q=0.8",
    }

    try:
        # 2. 自动检查并创建目标存放目录,避免 FileNotFoundError
        directory = os.path.dirname(save_path)
        if directory and not os.path.exists(directory):
            os.makedirs(directory, exist_ok=True)

        # 3. 发起请求,启用 stream=True 模式
        with requests.get(image_url, headers=headers, stream=True, timeout=timeout) as response:
            # 遇到 404 Not Found 或 403 Forbidden 等状态码时,立即抛出 HTTPError 异常
            response.raise_for_status()

            # 4. 可选检查:确保返回的数据确实属于图像类型
            content_type = response.headers.get("Content-Type", "")
            if content_type and not content_type.startswith("image/"):
                print(f"提示: 返回的 Content-Type ({content_type}) 可能不是图片资源。")

            # 5. 以二进制写模式 ('wb') 打开文件,分块写入磁盘
            # 缓冲区大小推荐设为 128KB (131072 字节)
            with open(save_path, "wb") as f:
                for chunk in response.iter_content(chunk_size=131072):
                    if chunk:
                        f.write(chunk)

        print(f"下载成功: {save_path}")
        return True

    except requests.exceptions.Timeout:
        print(f"下载失败: 请求超时 (超过 {timeout} 秒未响应)")
    except requests.exceptions.HTTPError as err_h:
        print(f"下载失败: HTTP 状态错误 ({err_h})")
    except requests.exceptions.RequestException as err_r:
        print(f"下载失败: 网络通信异常 ({err_r})")
    except OSError as err_os:
        print(f"下载失败: 磁盘写入或路径错误 ({err_os})")

    return False

if __name__ == "__main__":
    # 调用示例:下载一张测试图片并保存为 local_banner.png
    target_url = "https://www.python.org/static/community_logos/python-logo-master-v3-TM.png"
    target_file = "downloaded_python_logo.png"

    success = download_single_image(target_url, target_file)
    if success:
        print("图片已妥善保存到当前工作目录。")
    else:
        print("请根据上述提示排查下载错误。")
代码核心要点解析
stream=True:请求发出后,连接处于保持状态,仅传输 HTTP 响应头;只有在迭代response.iter_content()时才从网络套接字逐步读取实际数据块。mode="wb":必须以wb(Binary Write)打开文件。如果误写为w,Python 会将字节流按照系统默认文本编码(如 UTF-8)进行编解码,直接破坏 PNG/JPEG 的文件头魔数(Magic Number),导致图片彻底损坏无法打开。response.raise_for_status():当服务器返回 404、403 或 500 等错误时,requests.get()默认不会抛出异常,而是返回带有 HTML 报错内容的响应。若不加校验,程序会将这些 HTML 错误页直接写入.jpg文件,造成假成功。该语句能确保只有 200 系列状态码才进入写入环节。
三、写入机制对比:直接载入 vs 流式分块
部分初学者常习惯使用 open('pic.jpg', 'wb').write(response.content) 的方式来保存图片。虽然在图片仅有数十 KB 的情况下这种做法同样有效,但在通用代码和生产环境中,两者的内存吞吐特性有着显著差异:
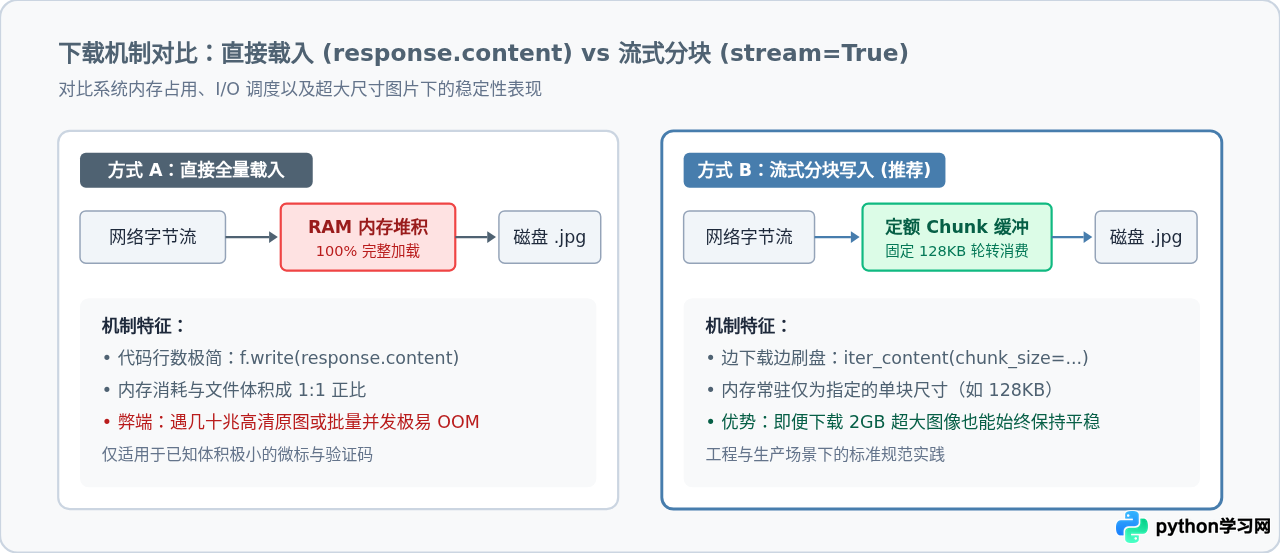
chunk_size 的取舍建议:通常推荐设置为 64KB(65536 字节)至 128KB(131072 字节)。块太小(例如 1024 字节)会增加 Python 与操作系统之间的系统调用(Syscall)开销;块太大(如 16MB)则削弱了流式下载节省内存的初衷。
四、请求头伪装与网络交互细节
很多图片服务器部署了防盗链机制(Hotlinking Protection)或反爬虫防火墙。直接使用默认的 requests.get(url) 往往会触发 403 Forbidden,因为默认请求头中 User-Agent 为 python-requests/x.xx.x,容易被识别并拒绝服务。
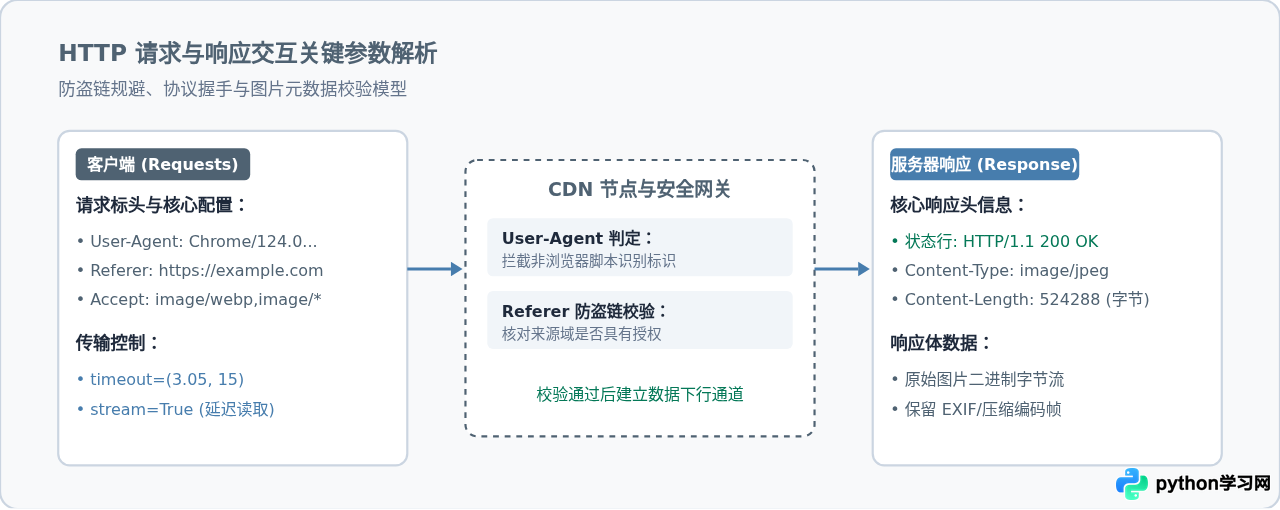
关键配置指导
- User-Agent 伪装:必须配置。如果不配置,大部分公共图床会直接返回
403 Forbidden。 - Referer 规避防盗链:部分网站(如微博图床、某些社交平台)要求
Referer必须为指定域名。如果发现下载的文件提示 403,可尝试将Referer设置为该图片所在的来源网页地址。 - 精细化 Timeout 控制:
requests.get(..., timeout=(3.05, 15))允许传入一个元组:第一个数值表示 TCP 连接建立超时(通常设定略大于 3 秒,避免重试延迟),第二个数值表示数据包读取超时(针对大图建议设为 15 秒以上)。
五、常见异常排查与防御决策
网络环境充满了不确定性。无论是 DNS 解析失败、握手超时,还是服务器下发了非预期的 HTML 错误页,都需要建立一套清晰的排查分支策略:
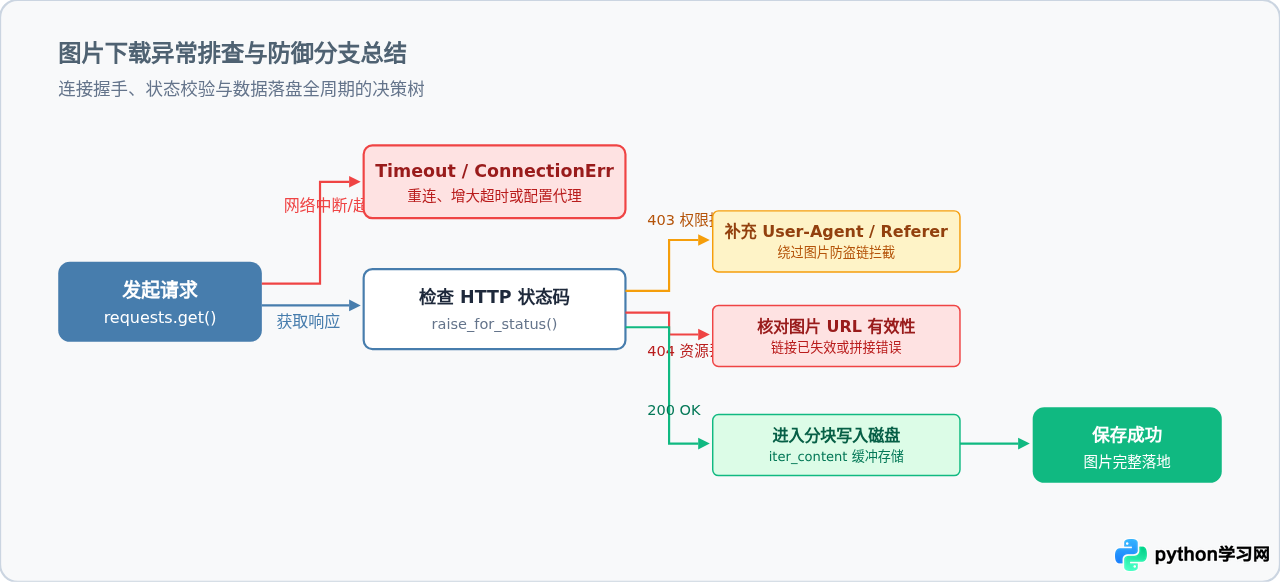
常见错误速查与处理表
| 现象 / 异常类型 | 根本原因 | 解决措施 |
|---|---|---|
HTTPError: 403 Forbidden |
服务器识别到非浏览器客户端,或开启了图片防盗链 | 在 headers 中补充合法的 User-Agent 和与目标站点一致的 Referer |
HTTPError: 404 Not Found |
图片路径无效,或链接中包含了未处理的相对路径 / 特殊转义字符 | 在浏览器地址栏手动访问图片 URL,确认地址无误并处理 URL 编码 |
requests.exceptions.ReadTimeout |
网络延迟过高或图片文件过大,超出指定秒数未收到任何后续数据 | 增大 timeout 阈值,或拆分为 (connect_timeout, read_timeout) |
| 保存后的图片提示“文件损坏无法打开” | 使用了普通文本模式 w 打开文件,或将 404/500 的 HTML 页面写入了图片 |
务必确认写入模式为 wb,并在写入前执行 response.raise_for_status() |
六、总结与落地建议
使用 Python requests 库完成单张图片下载,核心要求是“稳健可靠”。总结起来有三个核心法则:
- 使用
stream=True和iter_content():把内存消耗锁死在较小的块缓冲区内,兼顾小图的灵活性与高分辨率大图的安全性。 - 务必指定二进制写入模式
open(..., 'wb'):切勿使用字符串默认写入,确保每一个原始图片字节原样落盘。 - 必须校验
raise_for_status()并设置合理的timeout:网络通信必须有边界意识,严防假成功与长时间进程挂起。
遵循以上规范,便可构建出兼顾安全性、高性能与高容错率的单张图片下载模块。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









