

Python正则表达式能解决哪些自然语言处理预处理问题
深入解析Python正则表达式在自然语言处理(NLP)数据预处理阶段的具体应用场景、操作方法与能力边界,涵盖文本噪声清洗、格式规范化、规则分词与敏感信息脱敏等关键问题。
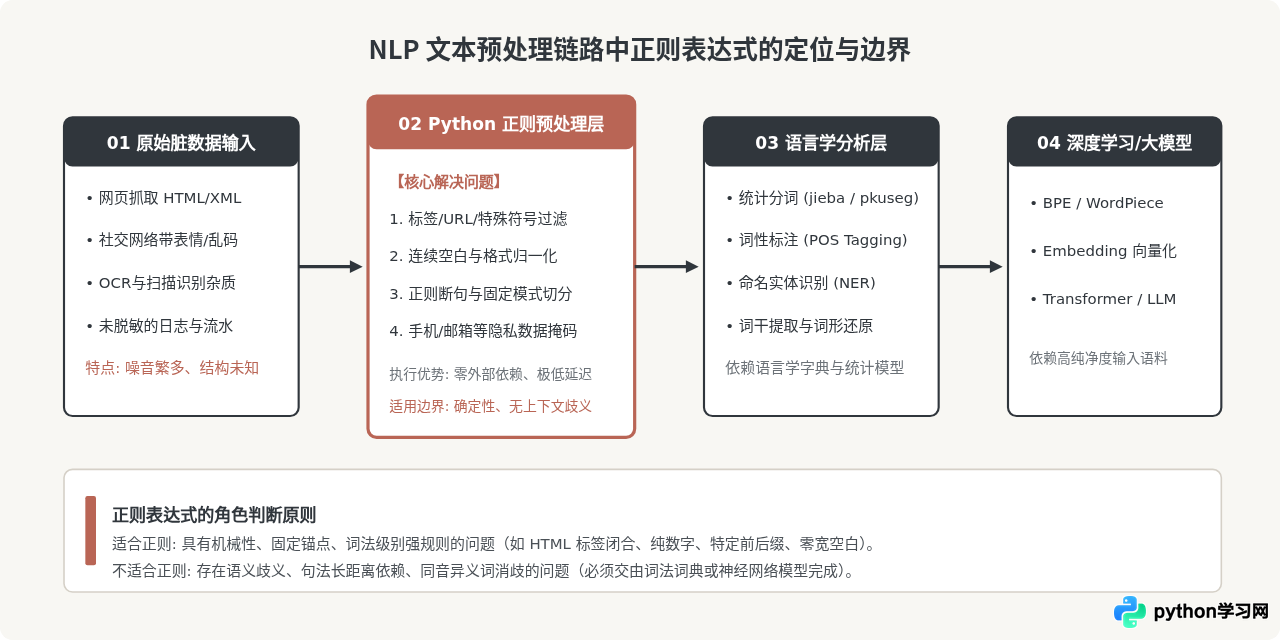
在自然语言处理(NLP)流程中,原始语料通常充斥着网页标签、控制字符、乱序空白、格式不一致的数字以及敏感个人信息。Python 的 re 模块凭借轻量、高效且规则确定的特性,承担着文本进入复杂分词模型或深度学习网络前的“门禁与初筛”职责。本文将从文本噪声清理、格式标准化、规则抽取分词以及敏感信息脱敏四个核心维度,详细拆解 Python 正则表达式能够解决的具体预处理问题,并明确其适用边界与运行规范。
一、文本清洗与噪声去除
真实世界采集的文本数据中,包含大量非自然语言的结构化代码或通信残留。如果直接输入分词工具,会导致词表膨胀并引入无意义的噪声特征。Python 正则表达式能够快速定位并剥离这些冗余字符。
1. 剔除 HTML 与 XML 标签
从维基百科、论坛或网页爬虫采集的数据常残留 <div>、<a href="..."> 等标记。通过匹配尖括号闭合区间,可以迅速将其替换为空字符:
import re

# 编译正则:非贪婪匹配尖括号标签
HTML_TAG_PATTERN = re.compile(r'<[^>]+>')

raw_html = "<p>自然语言处理<span class='highlight'>预处理</span>是基础步骤。</p>"
clean_text = HTML_TAG_PATTERN.sub('', raw_html)
# 输出: 自然语言处理预处理是基础步骤。
2. 清理 URL 超链接与邮件标记
社交媒体评论或问答文本常夹杂外部引用链接。对于情感分析或主题分类任务,这些链接无助于语义判断,反而会割裂上下文:
# 匹配 http/https 开头的链接以及 www 格式网址
URL_PATTERN = re.compile(r'https?://[a-zA-Z0-9./?=_-]+|www\.[a-zA-Z0-9./?=_-]+')

raw_post = "技术详情见:https://example.com/nlp?id=1024 欢迎查阅。"
text_no_url = URL_PATTERN.sub('', raw_post)
# 输出: 技术详情见: 欢迎查阅。
3. 去除不可见字符与零宽空格
网络复制文本中经常包含零宽空格(Zero-width space,如 \u200b、\ufeff)以及 ANSI 控制字符。这类字符肉眼不可见,但在 Python 字符串比较、分词及 Hash 编码时会引发异常截断:
# 匹配常见的不可见字符和字节顺序标记(BOM)
INVISIBLE_CHARS_PATTERN = re.compile(r'[\u200b-\u200f\ufeff\xa0]')

corrupted_text = "Python\u200b正则\ufeff表达式"
sanitized_text = INVISIBLE_CHARS_PATTERN.sub('', corrupted_text)
# sanitized_text 变为纯净的 "Python正则表达式"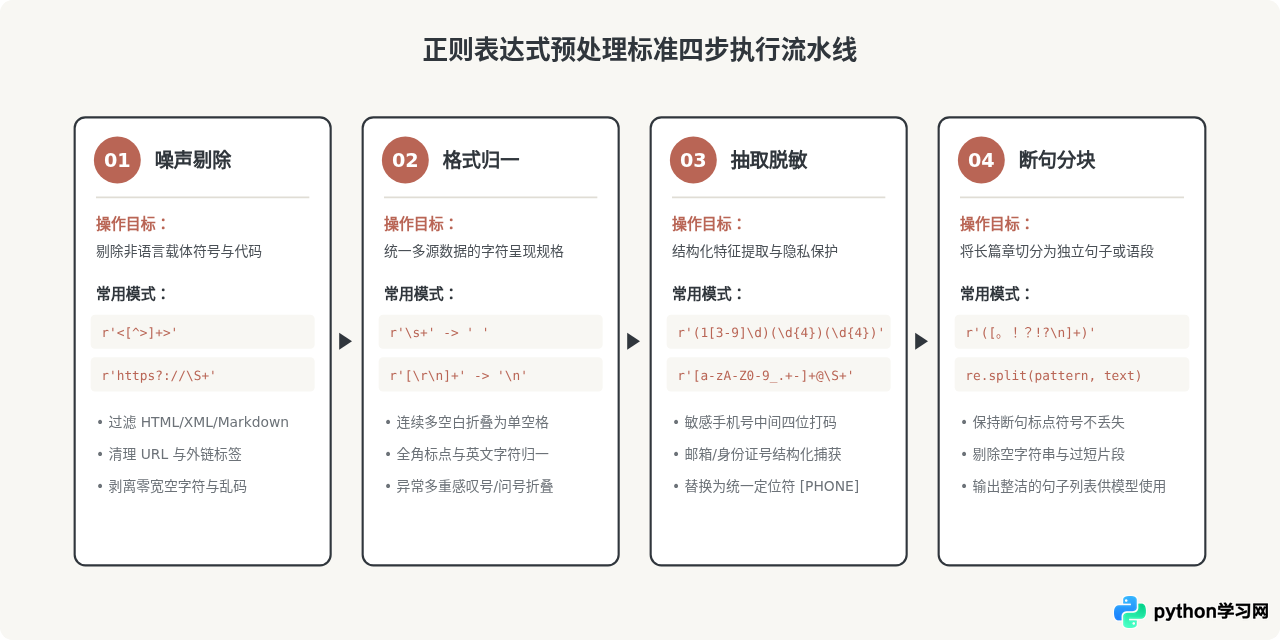
二、格式规范化与标准化
多源采集的语料由于输入法差异或排版习惯,格式往往极不规整。例如重复的标点符号、混乱的空格以及全角半角混杂。规范化旨在降低词表的稀疏性,使同一语义表达映射到同一字符形式。
1. 空白字符与换行折叠
文本中连续出现的多个制表符、半角空格或换行符,如果不做压缩,不仅会徒增语料体积,还会在统计模型计算词频或 Transformer 构建位置编码时产生偏差:
# 将多个连续空格与制表符压缩为单个空格
WHITESPACE_PATTERN = re.compile(r'[ \t]+')
# 将多个连续换行折叠为单个标准换行
NEWLINE_PATTERN = re.compile(r'[\r\n]+')

raw_text = "数据预处理    是非常重要的\n\n\n基础环节。"
normalized_space = WHITESPACE_PATTERN.sub(' ', raw_text)
normalized_text = NEWLINE_PATTERN.sub('\n', normalized_space)
# normalized_text 变为: "数据预处理 是非常重要的\n基础环节。"
2. 异常重复标点压缩
在网络论坛和社交媒体评论中,用户常习惯使用重复的感叹号或问号强化情绪(如“真的吗????太好了!!!!!”)。对情感分类任务而言,保留情绪信号即可,重复过多的字符应收拢为标准长度:
# 将连续两个以上的问号或感叹号压缩为一个
PUNCT_COLLAPSE = re.compile(r'([!?!?]){2,}')

comment = "这个模型效果真的不错!!!!难道不是吗????"
cleaned_comment = PUNCT_COLLAPSE.sub(r'\1', comment)
# 输出: "这个模型效果真的不错!难道不是吗?"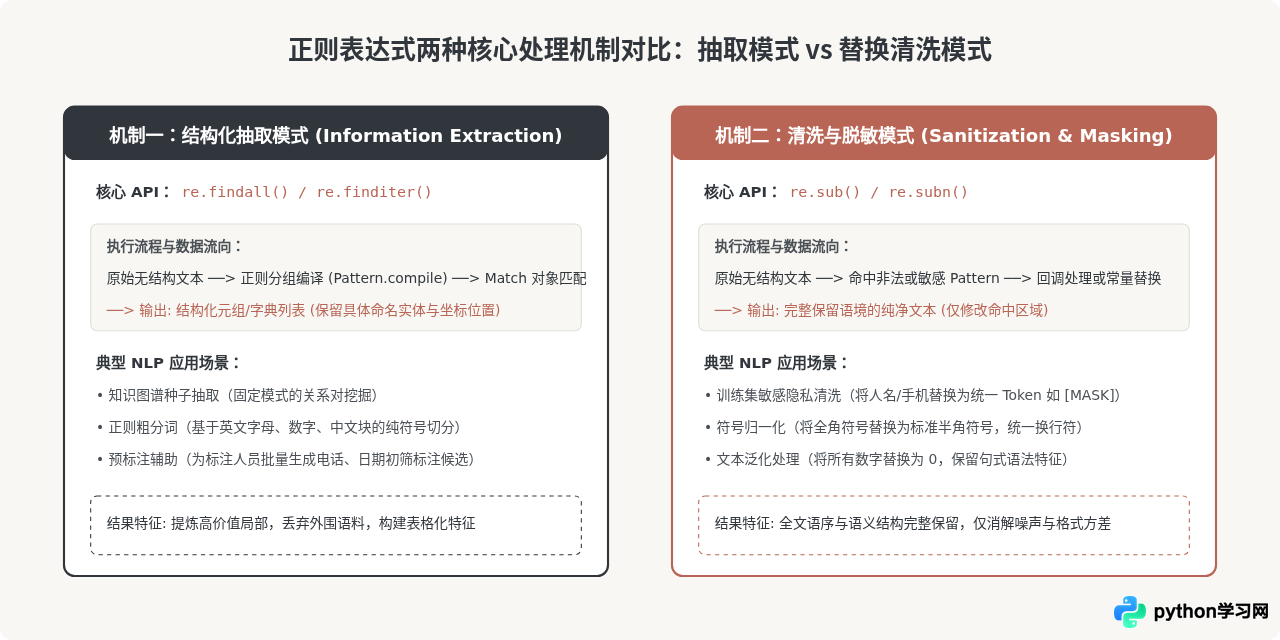
三、规则分词、句子切分与特定实体抽取
虽然复杂的中文分词需要借助隐马尔可夫模型(HMM)或条件随机场(CRF),但在许多前置处理环节,纯规则分词与断句在效率上占据绝对优势。
1. 依据标点符号的高效断句
深度学习模型(如 BERT 或 GPT)通常具有最大输入长度限制(如 512 或 2048 个 Token)。在分批送入模型前,长文档必须切分为独立的句子。使用 re.split 并结合捕获括号,可以在切分的同时保留标点本身:
# 匹配句末标点,使用捕获括号保留分隔符
SENTENCE_SPLIT_PATTERN = re.compile(r'([。!?!?\n]+)')

document = "Python具有强大的文本处理能力。你经常使用re模块吗?确实很高效!"
parts = SENTENCE_SPLIT_PATTERN.split(document)

# 还原带标点的完整句子列表
sentences = []
for i in range(0, len(parts) - 1, 2):
    sentences.append(parts[i] + parts[i+1])
if len(parts) % 2 != 0 and parts[-1].strip():
    sentences.append(parts[-1])

# sentences:
# ['Python具有强大的文本处理能力。', '你经常使用re模块吗?', '确实很高效!']
2. 固定格式命名实体捕获
在自然语言理解(NLU)中,像电子邮件、中国大陆手机号码、身份证号、IPv4 地址等,其命名规则高度严格。在训练深度学习实体识别模型前,直接使用正则表达式进行初筛匹配,准确率接近 100%,且几乎不消耗 GPU 资源:
# 提取中国大陆11位手机号码与邮箱
PHONE_PATTERN = re.compile(r'(?<!\d)1[3-9]\d{9}(?!\d)')
EMAIL_PATTERN = re.compile(r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+')

text = "如有疑问请致电 13812345678 或联系 support@example.org 发送邮件。"
phones = PHONE_PATTERN.findall(text)
emails = EMAIL_PATTERN.findall(text)
# phones: ['13812345678']
# emails: ['support@example.org']
四、隐私保护与敏感信息脱敏
在构建公开数据集、向云端大模型 API 发送 Prompt 或微调金融医疗垂直领域模型时,保护个人隐私(PII, Personally Identifiable Information)是硬性合规要求。通过正则捕获组或替换函数(Callback),可以实现细粒度的局部掩码:
# 手机号脱敏:保留前三位和后四位,中间四位替换为星号
def mask_phone(match):
    prefix = match.group(1)
    suffix = match.group(3)
    return f"{prefix}****{suffix}"

PHONE_MASK_PATTERN = re.compile(r'(1[3-9]\d)(\d{4})(\d{4})')
raw_dialogue = "用户反馈:张三联系方式为 13912345678,请尽快核实。"
masked_dialogue = PHONE_MASK_PATTERN.sub(mask_phone, raw_dialogue)
# 输出: "用户反馈:张三联系方式为 139****5678,请尽快核实。"
五、正则表达式在 NLP 中的适用边界与工程陷阱
尽管正则表达式功能强大,但其在 NLP 体系中绝不能越界替代分词器与上下文模型。了解其局限性有助于避免工程事故:
- 无法解决上下文语义歧义: 正则属于形式语言学中的“正则文法”(Chomsky 3型文法),无法记忆深层状态。例如“南京市长江大桥”是切分为“南京市 / 长江大桥”还是“南京市长 / 江大桥”,必须依赖词频统计和上下文语义,正则无法可靠区分。
- 灾难性回溯(ReDoS 漏洞): 当模式中包含嵌套的贪婪量词(如
(a+)+$)且输入了不匹配的长字符串时,正则引擎会发生指数级回溯,导致 CPU 占用率 100% 并卡死服务。在编写预处理规则时,应尽量使用非贪婪匹配或独占匹配,并避免无界嵌套。 - 预编译优化原则: 在处理十万级以上的语料时,严禁在循环体内直接调用
re.sub(...)。应当在模块初始化时使用re.compile(...)将模式对象缓存在内存中,避免每次调用重复进行语法解析。
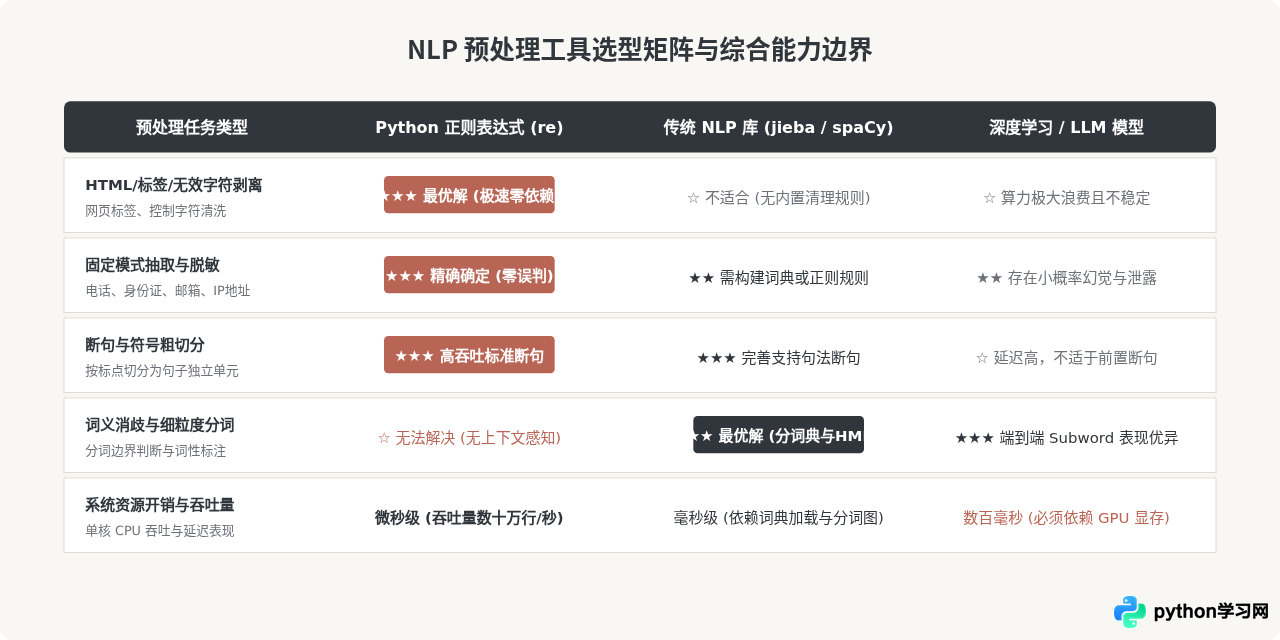
总结
Python 正则表达式在自然语言处理中扮演的是“前哨清洁工”的角色。它以极高的执行效率和确定性,解决了数据集中最机械、最繁琐的格式问题,包括但不限于网页标签剥离、多余空白压缩、标点归一化、长文本断句以及敏感个人信息掩码。然而,在处理词义消歧、语法依存和复杂命名实体识别时,必须将处理权限移交至统计分词工具或预训练语言模型。在实际的 NLP 生产系统中,构建以“正则表达式快速初筛 + 分词器结构化解析 + 深度模型语义理解”为阶梯的三层处理流水线,是兼顾吞吐效率与处理精度的成熟实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









