

实战案例:用Python正则表达式清洗杂乱文本数据
实战案例:用Python正则表达式清洗杂乱文本数据。详细演示如何使用Python内置re模块剥离HTML标签、归一化连续空白、剔除异常符号、提取关键信息并完成格式脱敏。
在网页抓取、业务系统接口对接以及日志采集等场景中,收集到的原始文本往往充斥着网页标签残留、混乱多余的空格与制表符、乱码符号以及未格式化的联系方式。处理这些脏数据是后续进行文本分类、信息抽取或存入数据库的前提。本文以一段真实的复杂脏文本为处理对象,通过 Python 自带的 re 模块,逐步演示如何构建一套模块化、可复用的正则表达式清洗流水线,直接解决文本去噪、排版规范化与敏感信息格式化问题。
一、清洗流水线设计与执行顺序
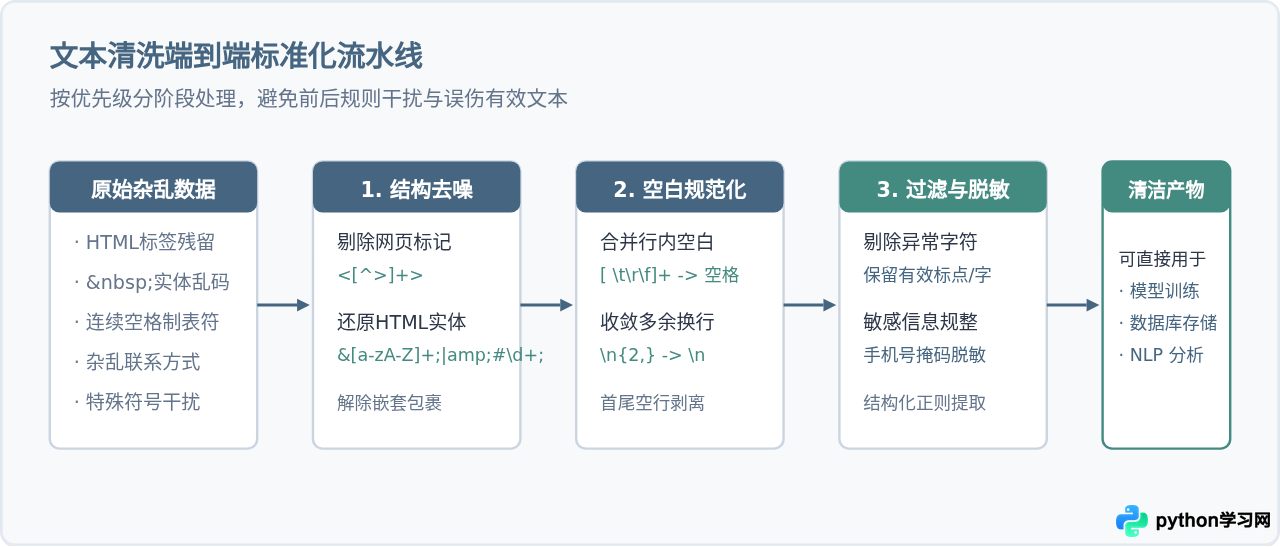
文本清洗不能随机调用替换函数,合理的处理次序能够避免不同规则之间的冲突。例如,如果先删除特殊字符再清理 HTML 标签,可能会破坏原本完整的 <div> 结构,导致标签无法被准确识别。标准的清洗流程遵循“由宏观到微观、由结构到细节”的原则:首先剥离外部容器结构(如 HTML 标签和转义实体),其次归一化多余的空白与换行,接着过滤无效的乱码噪点,最后针对目标字段进行提取与格式归一化。
二、关键清洗步骤与正则原理拆解
1. 剔除 HTML 标签与实体字符
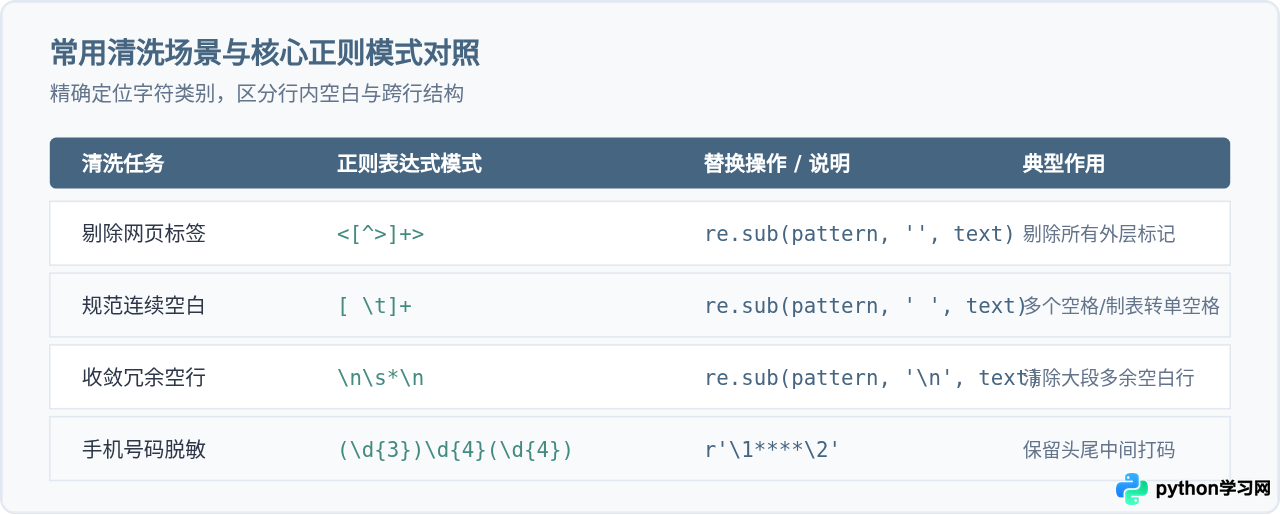
抓取到的内容常带有 <div class="entry">、<p>、<br/> 等标签,以及 、> 等实体字符。我们使用非贪婪模式匹配所有标签并清除,同时用 Python 内置的 html.unescape 或正则替换实体。
import re
import html
def remove_html(text: str) -> str:
# 匹配并去除任何 <...> 形式的 HTML 标签
clean = re.sub(r'<[^>]+>', '', text)
# 将 < > 等字符实体还原为普通符号或空格
clean = html.unescape(clean)
return clean2. 规范化空白字符与多余换行
很多杂乱文本中存在多个制表符 \t、全角/半角空格混乱交织的情况,还有连续多行空行。如果直接用 \s+ 替换为空格,会把正常的换行段落也合并成一行,破坏段落结构。因此,需将“行内水平空白”与“行间垂直换行”分开处理:
- 行内空白:将连续的空格与制表符
[ \t\f\r]+替换为单个标准空格; - 段落换行:将连续两次及以上的换行
\n{2,}收敛为规范的双换行或单换行,并剥离每行首尾多余空格。
3. 剔除非法乱码与噪点符号
很多网页或扫描文本中会出现 、▲、■、不可见控制字符等杂质。若想仅保留有效的中文字符、英文字母、阿拉伯数字以及常规标点符号,可以构建“反向白名单”:
def remove_noise_symbols(text: str) -> str:
    # 允许的字符集:中文汉字、英文字母、数字、常见中英文标点
    # [^\u4e00-\u9fa5a-zA-Z0-9\s,,.。!!??::;;"'"'、()()\-_] 匹配一切不在白名单内的符号
    clean = re.sub(r'[^\u4e00-\u9fa5a-zA-Z0-9\s,,.。!!??::;;\'\"“”‘’、()()\-_]', '', text)
    return clean
4. 敏感信息脱敏与结构化字段抽取
在数据公开或传递给大语言模型前,通常需要对手机号、身份证号或私人邮箱进行脱敏。利用正则分组 (),我们可以提取前缀与后缀并替换中间内容:
- 大陆手机号脱敏:
re.sub(r'(1[3-9]\d)\d{4}(\d{4})', r'\1****\2', text) - 邮箱脱敏:
re.sub(r'([a-zA-Z0-9_.+-]{1,2})[a-zA-Z0-9_.+-]+(@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+)', r'\1***\2', text)
三、完整实战代码与数据流转验证
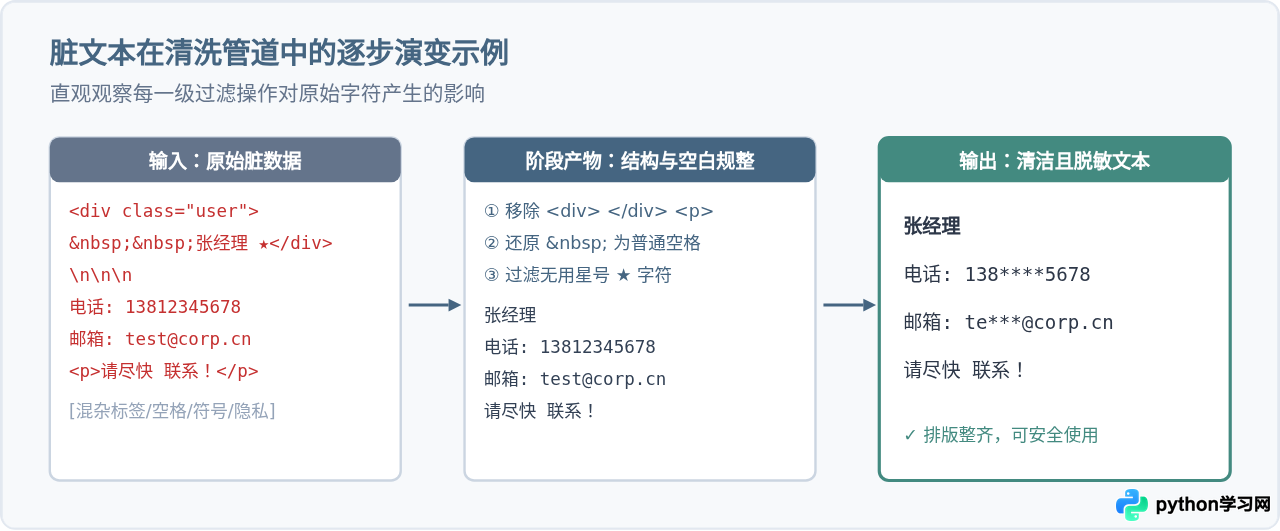
下面我们构造一段典型的脏数据样本,并调用一个完整的管道清洗函数。该样本包含 HTML 嵌套、多余空格、无意义乱码标记、全角半角混杂的电话及邮箱。
以下为完整的端到端 Python 实现:
import re
import html
class TextCleaner:
def __init__(self):
# 预编译常用正则表达式以提升执行效率
self.re_html_tag = re.compile(r'<[^>]+>')
self.re_inline_spaces = re.compile(r'[ \t\f\r]+')
self.re_empty_lines = re.compile(r'\n\s*\n+')
self.re_noise_chars = re.compile(r'[^\u4e00-\u9fa5a-zA-Z0-9\s,,.。!!??::;;\'\"“”‘’、()()\-_@]')
self.re_phone = re.compile(r'(1[3-9]\d)\d{4}(\d{4})')
self.re_email = re.compile(r'([a-zA-Z0-9_.+-]{1,2})[a-zA-Z0-9_.+-]+(@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+)')
def clean(self, raw_text: str, mask_privacy: bool = True) -> str:
if not raw_text:
return ""
# 1. 清理 HTML 标签与实体
text = self.re_html_tag.sub('', raw_text)
text = html.unescape(text)
# 2. 过滤未授权的特殊杂质字符(保留白名单内的文字与标点)
text = self.re_noise_chars.sub('', text)
# 3. 规范化行内空白
lines = []
for line in text.split('\n'):
line = self.re_inline_spaces.sub(' ', line).strip()
if line:
lines.append(line)
text = '\n'.join(lines)
# 4. 连续多行空行合并
text = self.re_empty_lines.sub('\n', text)
# 5. 敏感信息脱敏(可选)
if mask_privacy:
text = self.re_phone.sub(r'\1****\2', text)
text = self.re_email.sub(r'\1***\2', text)
return text.strip()
# 示例运行验证
if __name__ == '__main__':
messy_sample = """
<div class="profile-card">
用户姓名: 李工程师 ▲★
</div>
<p>联系电话: 13912345678 \t 邮箱: developer_01@company.com</p>
<div>备注: 业务系统导出异常,包含大量连续空格 与无意义标记!!</div>
"""
cleaner = TextCleaner()
result = cleaner.clean(messy_sample)
print("----- 清洗后结果 -----")
print(result)示例输出验证:
----- 清洗后结果 -----
用户姓名: 李工程师
联系电话: 139****5678 邮箱: de***@company.com
备注: 业务系统导出异常,包含大量连续空格 与无意义标记!!
四、避坑要点与性能优化
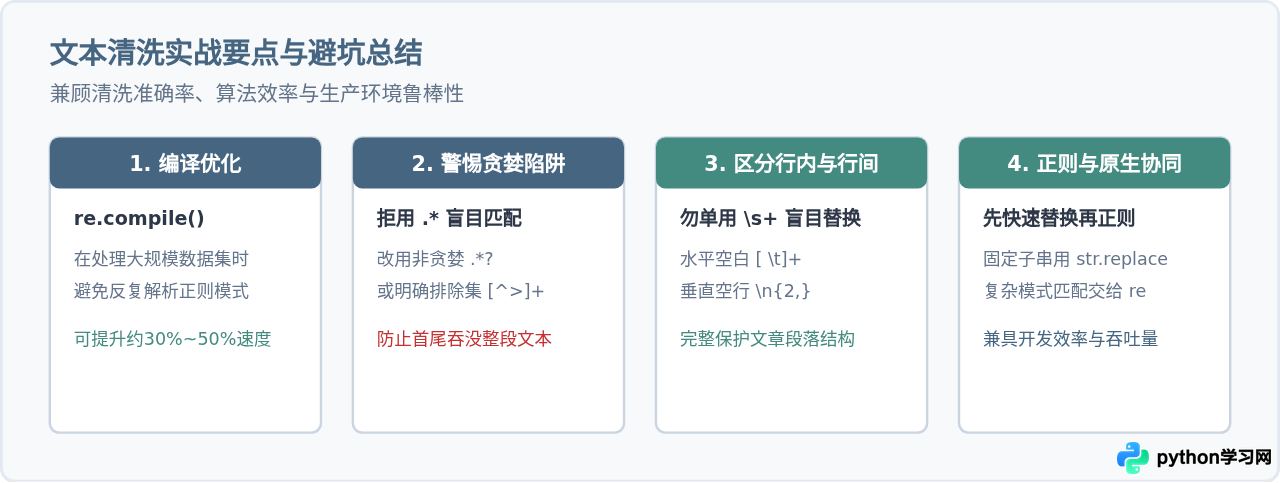
正则表达式功能强大,但在处理大规模文本数据时,若使用不当容易出现性能问题甚至引发灾难性的回溯。以下是在实战清洗中必须牢记的四个要点:
- 使用
re.compile()预编译模式: 在循环清洗成千上万行文本时,不要在循环体内部反复调用re.sub(r'...', ...)。预先编译正则对象能显著节省重复解析正则语法树的开销。 - 警惕贪婪匹配导致过度删除: 在清除类似 HTML 标签时,千万不要误写成
<.*>。在默认贪婪模式下,它会从第一个<一直匹配到全文最后一个>,把中间所有合法文本一并删光。应始终使用明确排除字符集<[^>]+>或非贪婪限定符<.*?>。 - 善用普通字符串操作做预处理: 如果只是简单替换固定字符(如将全角空格替换为半角空格、将制表符统一替换为普通空格),Python 原生的
str.replace()速度远超正则表达式。先做快速过滤,再用正则处理复杂模式,整体性能最优。 - 明确指定 Unicode 字符范围: 中文汉字通常使用
\u4e00-\u9fa5进行覆盖。对于罕见字或特定拓展区汉字,如需支持更广泛的字符范围,应扩展范围或结合unicodedata库做类别判定。
五、总结
文本清洗不是孤立地运行一两个替换语句,而是建立一套逻辑清晰、层次分明的处理链条。在 Python 中,通过封装 TextCleaner 类,先消除网页层标签,再规整空格与段落,随后过滤特殊字符白名单,最后配合捕获组实现关键信息提取与脱敏,能够以高内聚、易扩展的方式应对各种来源的杂乱文本数据。在实际工程落地时,注意配合预编译和性能防回溯原则,即可为后续的数据入库与算法建模提供干净、可信的基础语料。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









