

Python调用Node.js执行JS文件的完整步骤
详细讲解在Python中调用Node.js执行外部JavaScript脚本的完整步骤与工程实践,包括环境准备、参数双向传递、标准输入输出捕获、错误排查及与传统第三方库的对比。
subprocess 调用宿主系统中的 Node.js 运行时执行独立的 JS 脚本。本文梳理从环境检测、脚本编写、参数传递、输出解析到异常处理的完整落地步骤,并针对标准库子进程与第三方桥接方案进行深入对比。
一、调用原理与环境准备
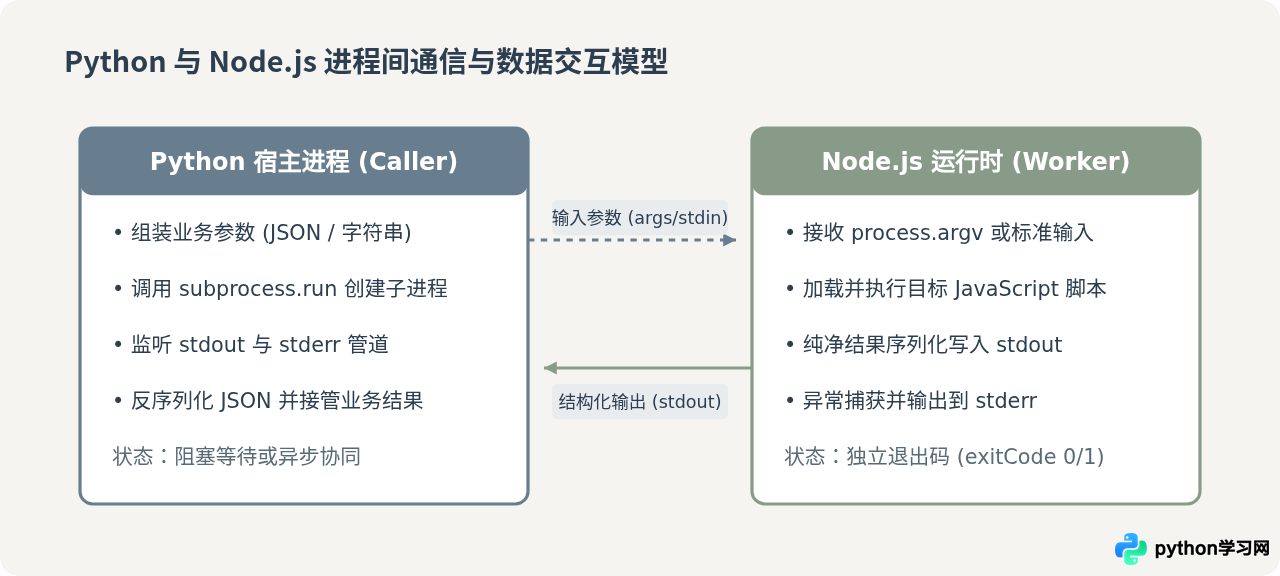
Python 调用 Node.js 的本质是操作系统级的跨进程协作。Python 作为父进程(Caller),通过系统 API 创建一个独立的 Node.js 子进程(Worker),并将待执行的 .js 文件路径与输入参数传递给 Node。Node.js 执行完毕后,将处理结果输出至标准输出流(stdout),错误信息输出至标准错误流(stderr),Python 进程捕获这些流数据并进行后续反序列化处理。
在正式编写代码前,必须确保运行环境中已正确安装 Node.js 并配置了全局环境变量。可以在终端中通过以下命令核验:
node -v
在 Python 代码中,推荐先使用标准库 shutil.which 确认 node 可执行文件路径。这能在程序启动时及早发现环境缺失问题,避免调用中途抛出模糊的系统错误:
import shutil

node_path = shutil.which("node")
if not node_path:
    raise EnvironmentError("未在系统 PATH 环境变量中检测到 Node.js,请先安装 Node.js 运行时。")
print(f"检测到 Node.js 路径:{node_path}")
二、核心操作步骤与代码实现
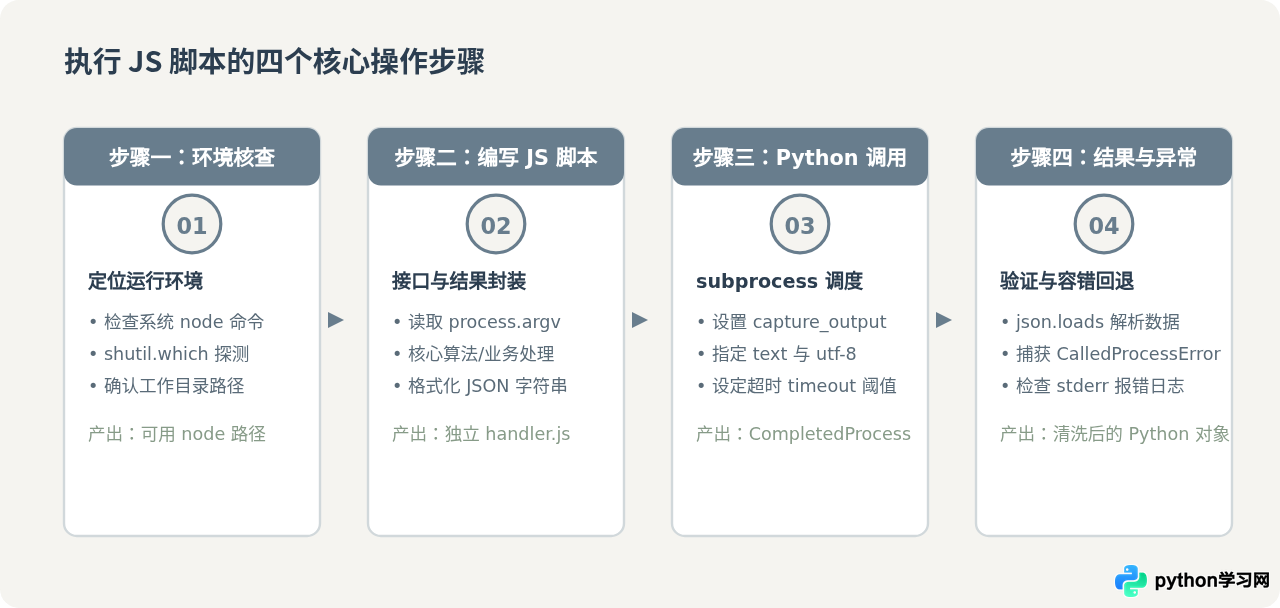
调用过程分为四个关键阶段:编写标准化的 JS 执行脚本、编写 Python 封装函数、处理结构化数据传参,以及异常捕获与验证。
步骤一:编写独立的 JavaScript 脚本
在同级目录创建名为 calculate.js 的脚本文件。为了方便 Python 捕获并解析结果,JS 脚本应遵循一个黄金准则:纯净输出。不要在脚本中间随意打印调试日志(如 console.log("start...")),所有业务输出应统一组织为 JSON 字符串并写入标准输出。
// calculate.js
const crypto = require('crypto');

function computeToken(username, timestamp) {
    const raw = `${username}:${timestamp}:secret_salt`;
    return crypto.createHash('sha256').update(raw).digest('hex');
}

function main() {
    try {
        // process.argv[0] 为 node 路径,process.argv[1] 为脚本路径,参数从下标 2 开始
        const username = process.argv[2] || "guest";
        const timestamp = process.argv[3] || Date.now().toString();

        const token = computeToken(username, timestamp);

        // 构造返回给 Python 的结构化数据
        const result = {
            status: "success",
            data: {
                username: username,
                timestamp: timestamp,
                token: token
            }
        };

        // 纯净输出到标准输出 (stdout)
        process.stdout.write(JSON.stringify(result));
        process.exit(0);
    } catch (err) {
        // 错误信息输出到标准错误 (stderr)
        process.stderr.write(JSON.stringify({
            status: "error",
            message: err.message
        }));
        process.exit(1);
    }
}

main();
步骤二:编写 Python 调用代码
在 Python 中,通过 subprocess.run 创建子进程并执行上述 JS 脚本。为确保脚本跨目录调用依然有效,建议使用 os.path 获取 JS 文件的绝对路径。
import os
import json
import subprocess

def run_js_script(username: str, timestamp: str) -> dict:
    # 构造目标 JS 脚本的绝对路径
    current_dir = os.path.dirname(os.path.abspath(__file__))
    js_file = os.path.join(current_dir, "calculate.js")

    # 构建命令行参数列表
    command = ["node", js_file, username, str(timestamp)]

    try:
        # 执行子进程并捕获标准输出与标准错误
        completed = subprocess.run(
            command,
            capture_output=True,
            text=True,
            encoding="utf-8",
            timeout=10,        # 设置 10 秒超时,防止子进程死锁
            check=True         # 当返回码非 0 时主动抛出 CalledProcessError
        )

        # 反序列化返回的 JSON 字符串
        output_data = json.loads(completed.stdout)
        return output_data

    except subprocess.TimeoutExpired as exc:
        raise RuntimeError(f"调用 Node.js 超时:超过 10 秒未响应。") from exc
    except subprocess.CalledProcessError as exc:
        raise RuntimeError(f"Node.js 执行失败 (返回码 {exc.returncode}),错误信息: {exc.stderr}") from exc
    except json.JSONDecodeError as exc:
        raise ValueError(f"解析 Node.js 输出结果失败,非合法 JSON: {completed.stdout}") from exc

if __name__ == "__main__":
    result = run_js_script("alice", "1700000000")
    print("Python 成功接收调用结果:")
    print(result)
步骤三:大数据量场景下的标准输入(stdin)管道交互
当需要传递庞大的 JSON 数据(例如数万条表格行或大型配置)给 JS 时,操作系统命令行参数的长度限制(如 Linux 的 ARG_MAX)可能会导致调用失败。此时应改为通过标准输入管道(stdin)向 Node.js 写入数据:
# Python 侧:通过 input 参数传递 JSON 字符串
payload = json.dumps({"items": [1, 2, 3, 4, 5], "action": "batch_process"})

completed = subprocess.run(
    ["node", "processor.js"],
    input=payload,
    capture_output=True,
    text=True,
    encoding="utf-8",
    timeout=15
)
对应 Node.js 脚本 processor.js 从 process.stdin 收集数据并在 end 事件中处理:
// processor.js
let inputChunks = '';

process.stdin.setEncoding('utf-8');
process.stdin.on('data', chunk => {
    inputChunks += chunk;
});

process.stdin.on('end', () => {
    try {
        const payload = JSON.parse(inputChunks);
        const processed = payload.items.map(x => x * 10);
        process.stdout.write(JSON.stringify({ status: "success", result: processed }));
    } catch (e) {
        process.stderr.write(e.message);
        process.exit(1);
    }
});
步骤四:验证执行输出
运行 Python 脚本进行验证。示例输出如下(明确标为示例输出):
[示例输出]
Python 成功接收调用结果:
{
  "status": "success",
  "data": {
    "username": "alice",
    "timestamp": "1700000000",
    "token": "7a353683a45c25608d4b3ff255b630e28eb38e8ec4d8f5ef1ffdf406dfec06e1"
  }
}
三、方案对比:原生 subprocess 与第三方库(如 PyExecJS)
在很多早期教程中,常推荐使用 PyExecJS 或类似第三方库在 Python 内执行 JS。为了帮助读者在工程实践中作出明确选择,下文在统一调用场景下对比两种方案的关键差异及影响。
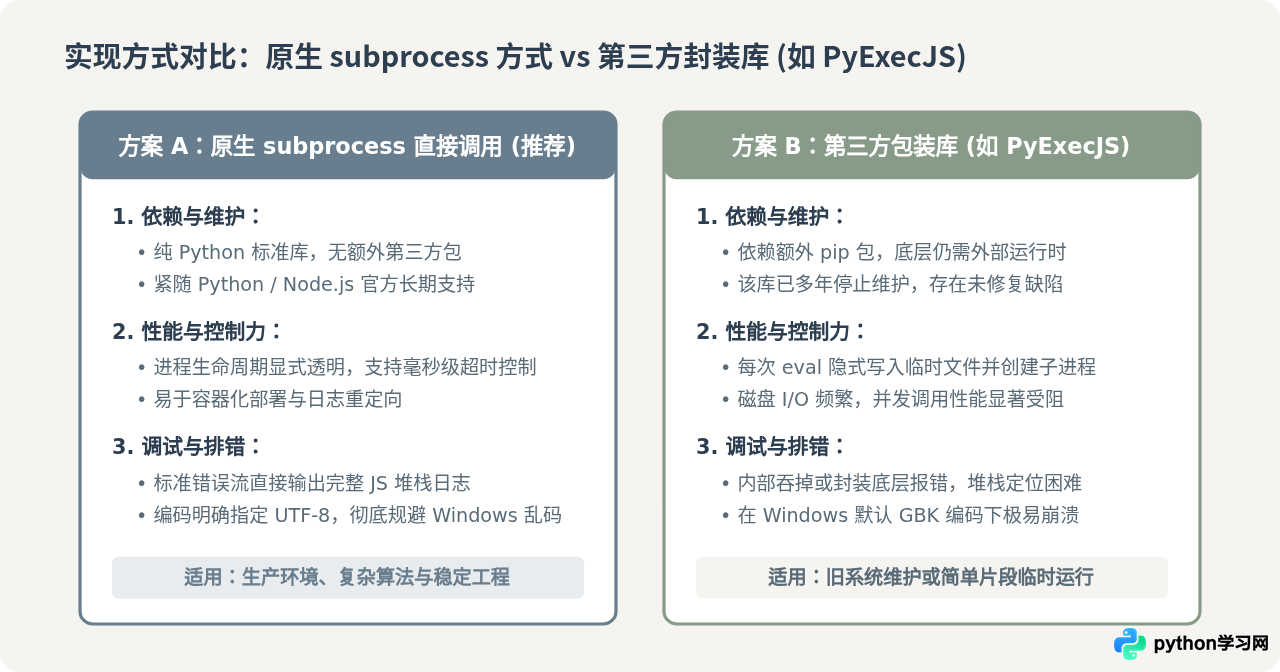
| 对比维度 | 原生 subprocess 方式 | PyExecJS 封装方式 |
|---|---|---|
| 外部依赖 | 仅依赖 Python 标准库与系统 Node.js | 需要额外的 pip 安装包 |
| 代码可维护性 | 逻辑清晰,JS 与 Python 文件职责明确 | 常将长篇 JS 代码硬编码为 Python 字符串 |
| 编码安全性 | 显式传入 encoding="utf-8",跨平台无乱码 |
依赖宿主系统默认代码页,Windows 上频发 GBK 报错 |
| 超时防僵尸 | 原生支持 timeout 参数,超时自动终止子进程 |
无直接超时中断机制,死循环易导致程序假死 |
四、常见问题排查与注意事项
在命令行中执行 python main.py 与从其他工作目录调用时,os.getcwd() 的结果完全不同。切忌使用 node ./calculate.js 这类相对路径,务必使用 os.path.dirname(os.path.abspath(__file__)) 计算绝对路径。
如果引入了第三方 npm 包,或者在 JS 代码中留有调试语句 console.log("ready"),这些字符同样会写入标准输出。这会导致 Python 在进行 json.loads() 反序列化时报 JSONDecodeError。生产环境中应确保普通日志重定向至 console.error()(即 stderr),让 stdout 专门保留结构化结果。
虽然 subprocess.run 非常稳定,但每次调用都会经历一次 Node.js 虚拟机的冷启动(通常耗时 50ms - 150ms)。如果业务场景是高并发或每秒数百次的微小计算,反复启动子进程会造成 CPU 浪费。此种情况下,应考虑将 Node.js 部分封装为一个常驻的本地微服务(例如 Express 或 Fastify),Python 通过轻量 HTTP 请求与之交互。
五、生产落地检查清单与总结
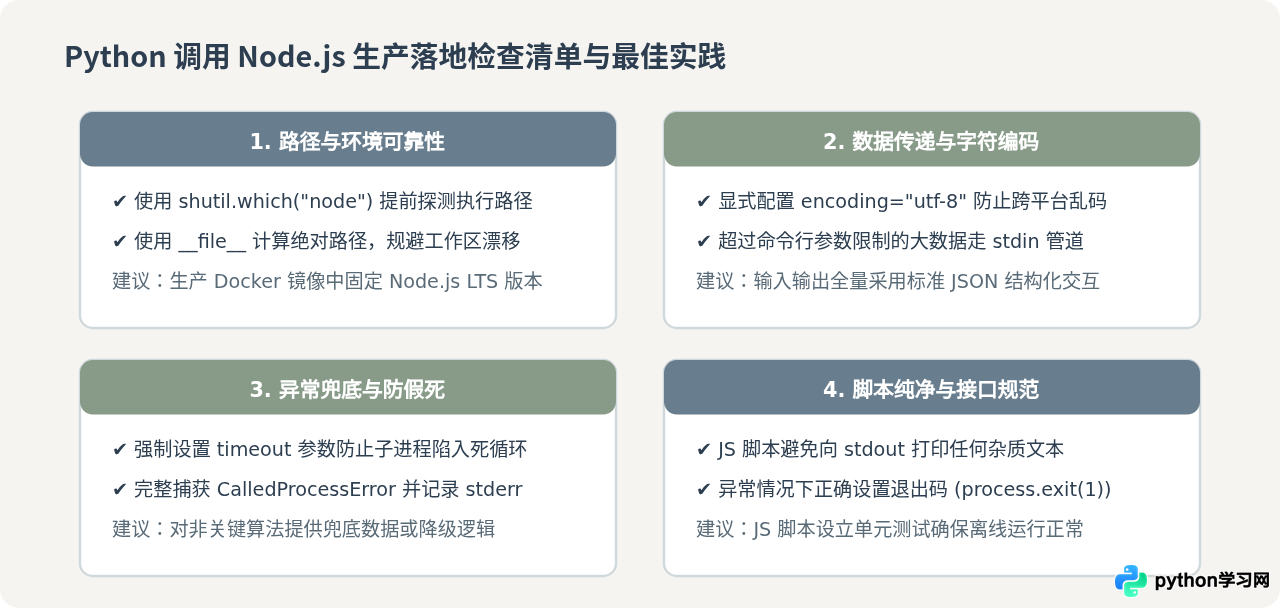
通过标准库 subprocess 调用 Node.js 是兼顾稳定性与轻量化的最佳实践。在将功能发布到生产环境之前,可以通过以下检查清单逐一复核各项配置。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









