

Python常用语法糖解析:列表推导式、解包赋值与切片
深入解析Python中高频使用的三种核心语法糖:列表推导式、解包赋值与序列切片。结合原理图解、代码示例、边界条件与避坑指南,帮助开发者写出更简洁高效的Pythonic代码。
语法糖(Syntactic Sugar)是指编程语言中添加的某种语法,这种语法并没有给语言增加新的核心功能,但能让代码更加直观、易读,并显著减少样板代码的堆砌。在日常 Python 开发中,列表推导式、解包赋值与切片操作是出现频次最高、收益最显著的三种语法糖。熟练运用它们不仅能使代码结构更加紧凑清晰,更能贴合 Pythonic 的设计哲学,同时在解释器底层往往享有更高效的执行优化。
一、核心知识与学习路径
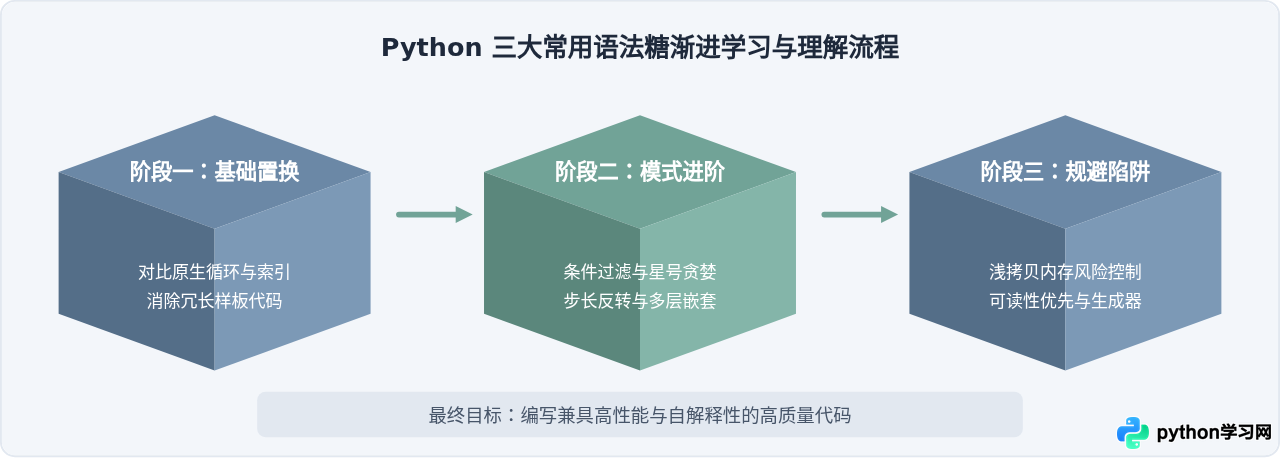
在深入具体语法前,建立整体的认知脉络能够帮助我们迅速厘清不同语法糖的适用边界。掌握这三项技术的核心学习路径可分为“理解等价逻辑”、“掌握扩展语法”与“明确性能及规避陷阱”三个阶段:
二、列表推导式(List Comprehension)
列表推导式是一种从现有可迭代对象快速构建新列表的声明式语法。传统写法需要显式声明空列表,配合 for 循环并在循环体中调用 .append() 方法,不仅代码繁琐,而且多次调用方法会带来轻微的函数调用开销。列表推导式则由 Python 虚拟机在字节码层面进行循环优化。
1. 推导执行机制与执行顺序
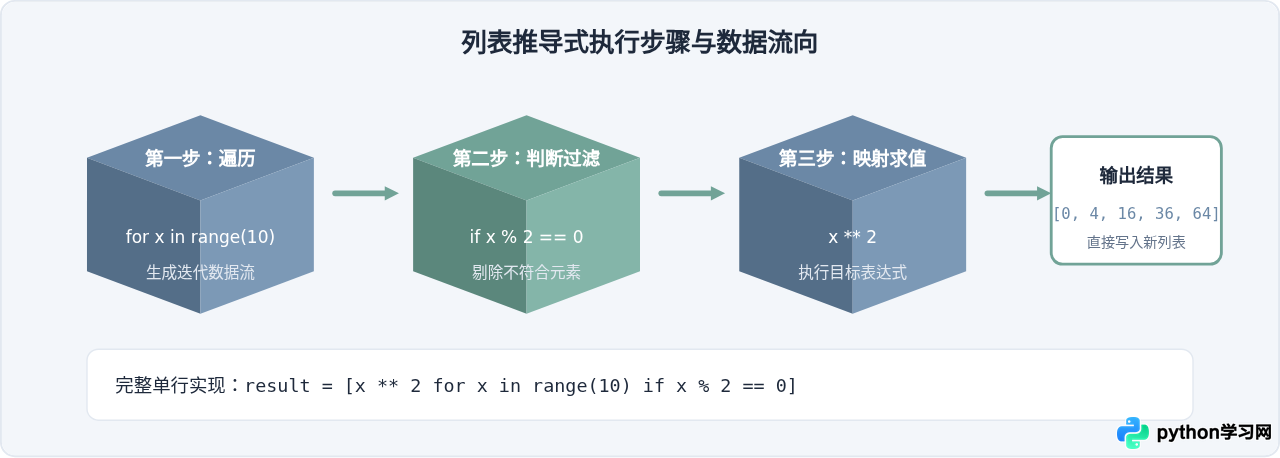
列表推导式的执行逻辑遵循统一的结构模式:[expression for item in iterable if condition]。很多初学者容易混淆多重循环或条件表达式的位置,通过下图可以直观理解其在内存中的执行步骤:
2. 典型用法与对比示例
# 场景:提取列表中所有大于 0 的偶数平方
raw_numbers = [-3, -2, 0, 1, 2, 4, 5]

# 【常规写法】
evens_squared_old = []
for n in raw_numbers:
    if n > 0 and n % 2 == 0:
        evens_squared_old.append(n ** 2)

# 【推导式写法】
evens_squared = [n ** 2 for n in raw_numbers if n > 0 and n % 2 == 0]

# 示例输出:evens_squared 等于 [4, 16]避坑提示:避免写超过两层嵌套的推导式。如果列表推导式中嵌套了多个 for 和 if,请还原为标准循环,否则会导致代码可读性急剧下降,给后续维护埋下隐患。
三、解包赋值(Unpacking Assignment)
解包赋值允许将序列或任意可迭代对象中的元素直接展开并赋值给多个变量。它彻底改变了传统通过索引逐个获取变量的冗余方式,也是 Python 中实现无需中间变量交换两值的底层机制。
1. 普通解包、变量交换与星号(*)解包
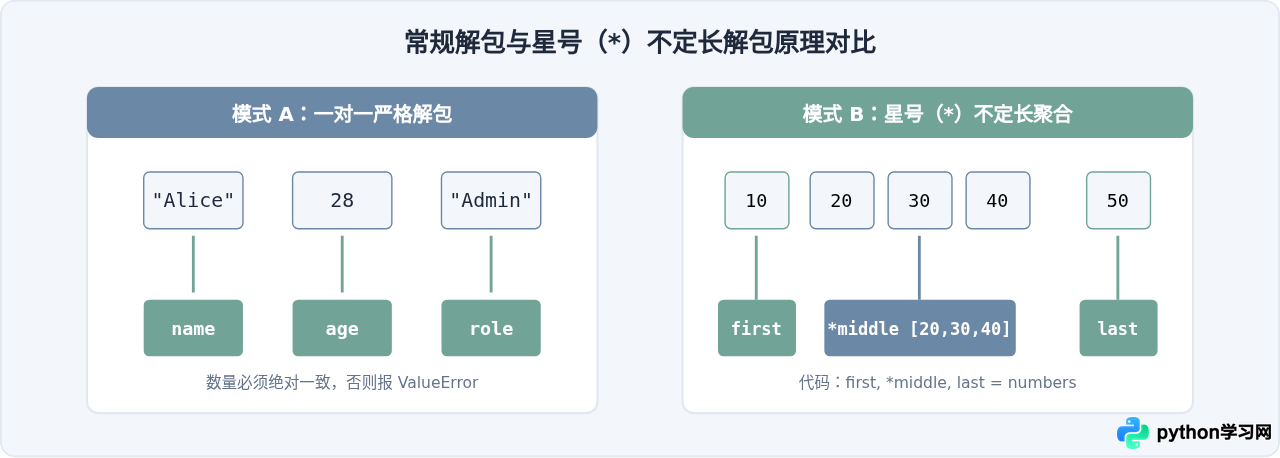
解包分为等量解包与不定长解包两种形态:
- 等长解包:左侧变量个数必须与右侧元素个数完全匹配,常用于坐标点、元组返回值与配置项拆分。
- 星号贪婪解包(
*args):当序列长度未知或仅需要首尾元素时,使用带*的变量吸收多余项,解析结果会自动转化为列表。
2. 解包的核心代码场景
# 1. 变量就地交换(无需临时中间变量 temp)
a = 10
b = 20
a, b = b, a  # 原理:右侧先构建元组 (20, 10),左侧解包赋值给 a 与 b

# 2. 截取首末元素与聚合中间值
scores = [98, 85, 92, 79, 94]
highest, *others, lowest = sorted(scores, reverse=True)
# 示例输出:highest 为 98, lowest 为 79, others 为 [94, 92, 85]

# 3. 字典解包(合并或传参)
dict_a = {"port": 8080}
dict_b = {"host": "127.0.0.1", "debug": True}
config = {**dict_b, **dict_a}
# 示例输出:config 为 {'host': '127.0.0.1', 'debug': True, 'port': 8080}
四、切片语法(Slicing)
切片操作通过 sequence[start:stop:step] 语法从序列类型(字符串、列表、元组等)中截取子序列。它最大的特征是“左闭右开”(包含 start,不包含 stop),且支持缺省参数与负数步长。
1. 切片三要素与正负索引定位
切片的三段参数均有明确的默认值与行为逻辑:
start:起始索引,若缺省在正步长时默认为0,负步长时默认为末尾。stop:终止边界(不含该位置对应元素),缺省时延续至序列边界。step:步长与提取方向。当step > 0时从左向右截取;当step < 0时自右向左逆向提取。
items = ["P", "y", "t", "h", "o", "n"]

# 基础提取:从第 1 位到第 4 位前
sub_1 = items[1:4]     # ['y', 't', 'h']

# 省略参数:前 3 个 / 倒数后 2 个
head = items[:3]       # ['P', 'y', 't']
tail = items[-2:]      # ['o', 'n']

# 步长提取:隔一个取一个
stepped = items[::2]   # ['P', 't', 'o']

# 逆序翻转序列
reversed_items = items[::-1] # ['n', 'o', 'h', 't', 'y', 'P']底层行为特性:切片操作不会修改原对象,而是会创建一个崭新的浅拷贝(Shallow Copy)。另外,切片索引具有极强的容错性,即使指定的 stop 远大于列表总长度,也不会触发 IndexError,而是自动截断到容器真实边缘。
五、综合总结与技术对比
为了在实际编码中做出最合适的设计选择,我们将本文分析的三种核心语法糖从语法形式、底层机制、典型优势及潜在风险进行系统横向对比:
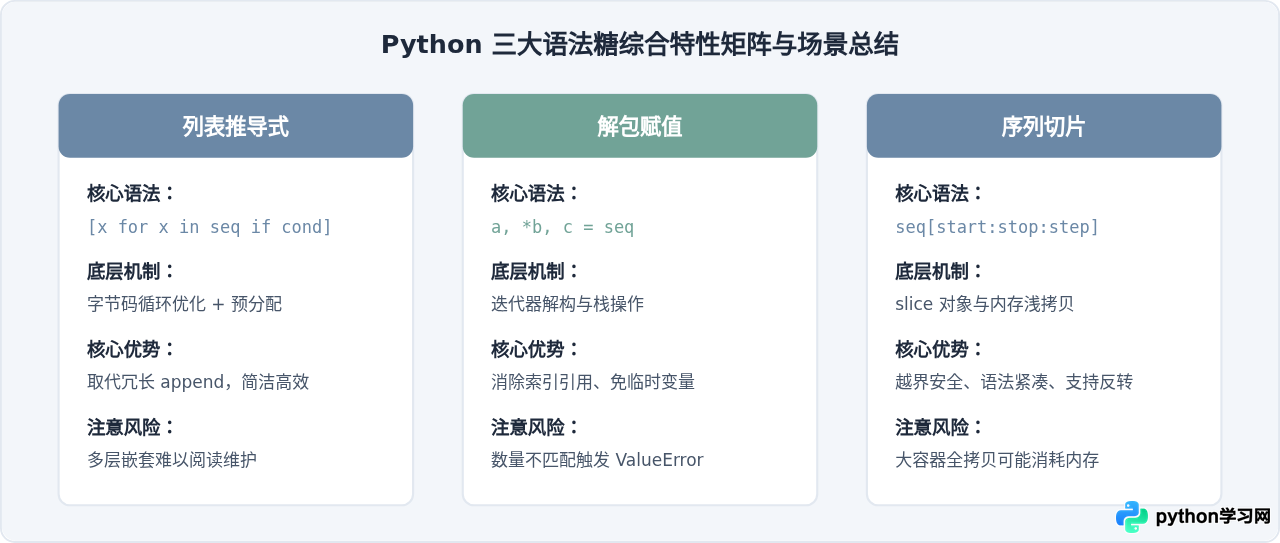
掌握列表推导式、解包赋值与序列切片是迈向成熟 Python 开发的关键一步。合理使用它们,可以在保证逻辑严密性的同时,让代码呈现出清晰、自解释且优雅的高品质质感。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









