

Python异常处理与日志记录代码示例
系统讲解Python中异常处理与日志记录的协同配合机制,提供标准库logging配置、堆栈捕获、多层异常分级及生产级轮转归档的完整代码示例与工程规范。
在编写实际运行的 Python 服务与工具脚本时,单纯使用 print 输出调试信息或在 except 块中直接 pass 忽略错误,往往是线上故障难以定位的主因。本文围绕 Python 原生 try...except 语句与标准库 logging 的深度协同,提供一套直接可运行、层次清晰的代码示例,涵盖基础配置、堆栈留存、分级治理与文件轮转归档,帮助你建立工业级的代码健壮性保障。
一、为什么必须将异常捕获与日志模块结合
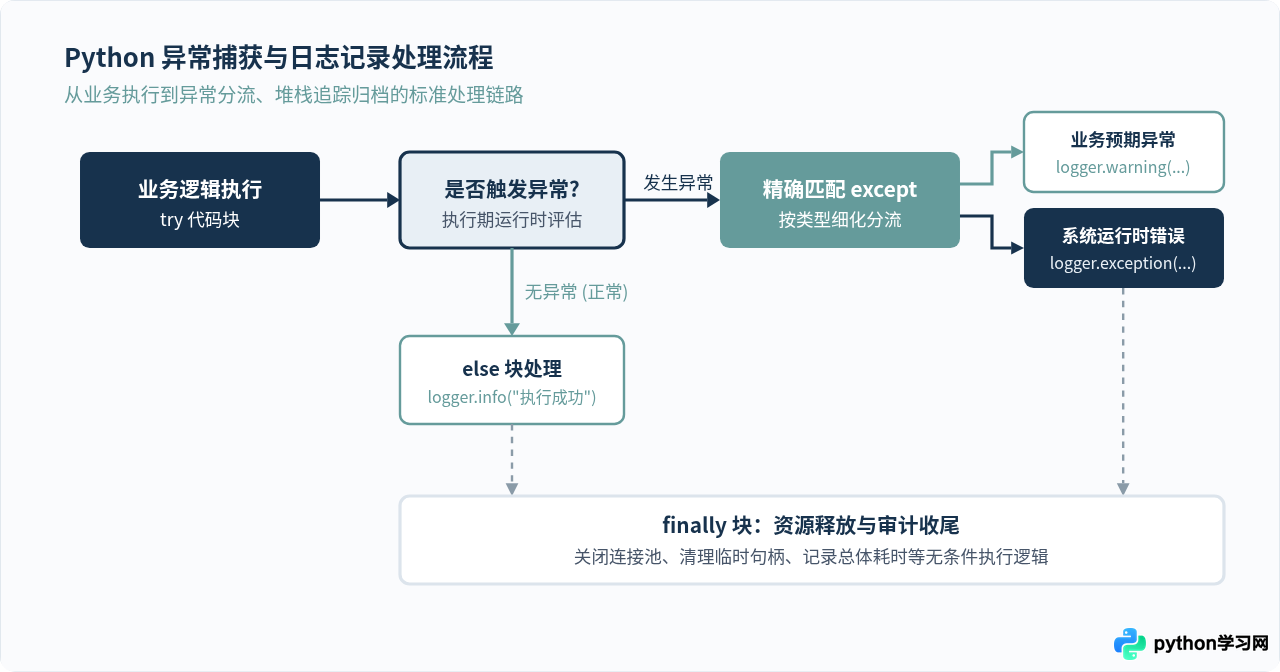
异常机制负责控制程序在遇到意外时的跳转路径,而日志系统负责记录程序在生命周期中的运行事实。两者结合的核心目标,是在程序遭遇不可恢复错误中断前,完整记录发生错误的时间点、模块位置、具体参数以及完整的执行堆栈(Traceback)。
很多初学者容易写出裸 except: 或仅通过 print(e) 打印错误文本的代码。这种做法会丢失引发异常的关键上下文:例如发生除以零或字典键缺失时,仅仅打印 'user_id' 或 division by zero,根本无法知道是哪一行源码触发的错误,更无法得知调用链路经过了哪些函数。利用 logging.exception() 或 logger.error(..., exc_info=True),可以在输出日志信息的同时,自动将当前线程的异常堆栈完整归档。
二、基础代码示例:从 try 块到 logger.exception
下面的代码演示了在常规计算函数中如何配置基础 logging 并安全捕获异常。请注意观察 logger.exception() 与普通输出的差别。
import logging

# 1. 基础配置:定义时间戳格式、日志级别与模块行号信息
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] [%(name)s:%(lineno)d] - %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S",
)

# 2. 获取当前模块专属的 Logger 对象
logger = logging.getLogger(__name__)

def compute_discount_rate(total_price: float, quantity: int) -> float:
    """计算单件平均折扣价,演示除零与负数异常的记录方式。"""
    try:
        if total_price < 0 or quantity < 0:
            raise ValueError(f"价格与数量必须大于零: total_price={total_price}, quantity={quantity}")

        result = total_price / quantity
        logger.info("计算折扣价成功: total_price=%.2f, quantity=%d, result=%.2f", total_price, quantity, result)
        return result

    except ZeroDivisionError:
        # 使用 logger.exception() 会默认传入 exc_info=True,自动输出完整堆栈
        logger.exception("计算折扣价失败:数量不能为 0 (total_price=%.2f)", total_price)
        return 0.0

    except ValueError as val_err:
        # 对于输入数据不合规的业务错误,记录 warning 并指出参数,不一定需要冗长堆栈
        logger.warning("业务参数校验不通过: %s", val_err)
        return 0.0

if __name__ == "__main__":
    compute_discount_rate(100.0, 5)   # 正常情况
    compute_discount_rate(50.0, 0)    # 触发 ZeroDivisionError 并输出堆栈
compute_discount_rate(-20.0, 3) # 触发 ValueError 并记录 warninglogger.exception("...") 必须只在 except 块中调用。如果在 try 外部调用,由于当前上下文不存在正在处理的异常,输出将缺失 Traceback。如果在除 except 之外的地方需要打印异常,应显式传入 exc_info=True。
三、深入理解 logging 架构与堆栈透传原理
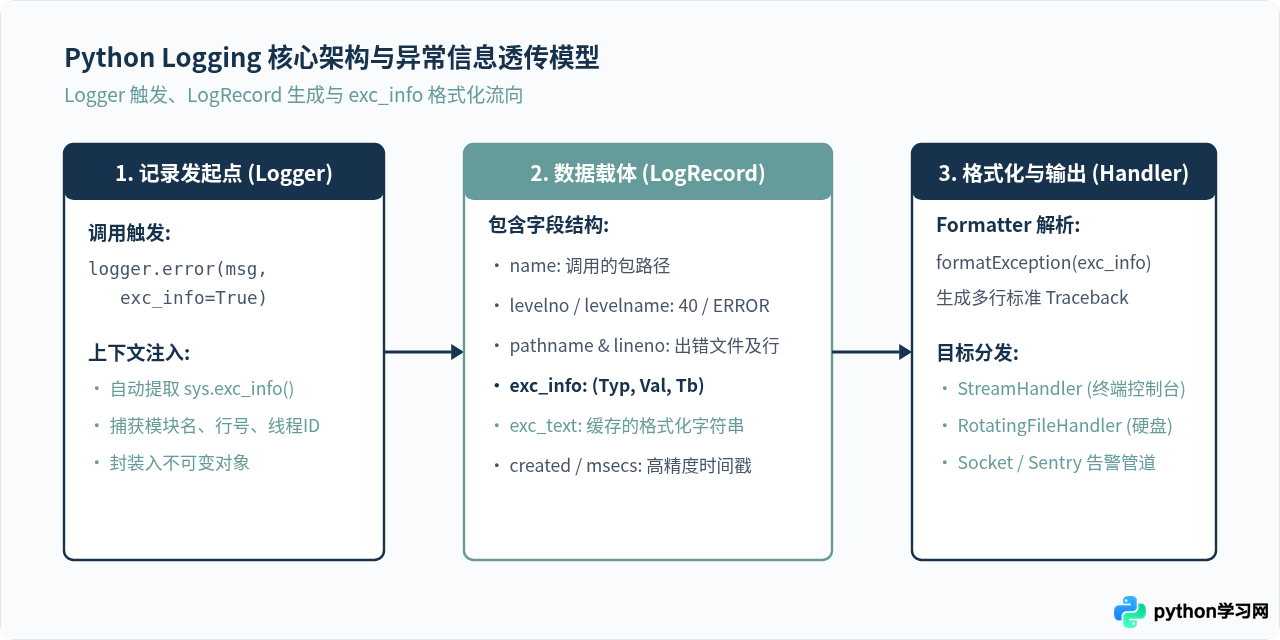
当 Python 捕获到异常时,解释器内部维护了 sys.exc_info(),它返回一个三元组:(type, value, traceback)。标准库 logging 在生成 LogRecord 实例时,正是接收并封装了这个三元组。
整个日志处理系统由 Logger、LogRecord、Handler 和 Formatter 四大核心组件协同运作。了解这些组件之间的信息流,有助于我们在大型工程中定制输出格式:
四、异常分类与日志级别的映射决策
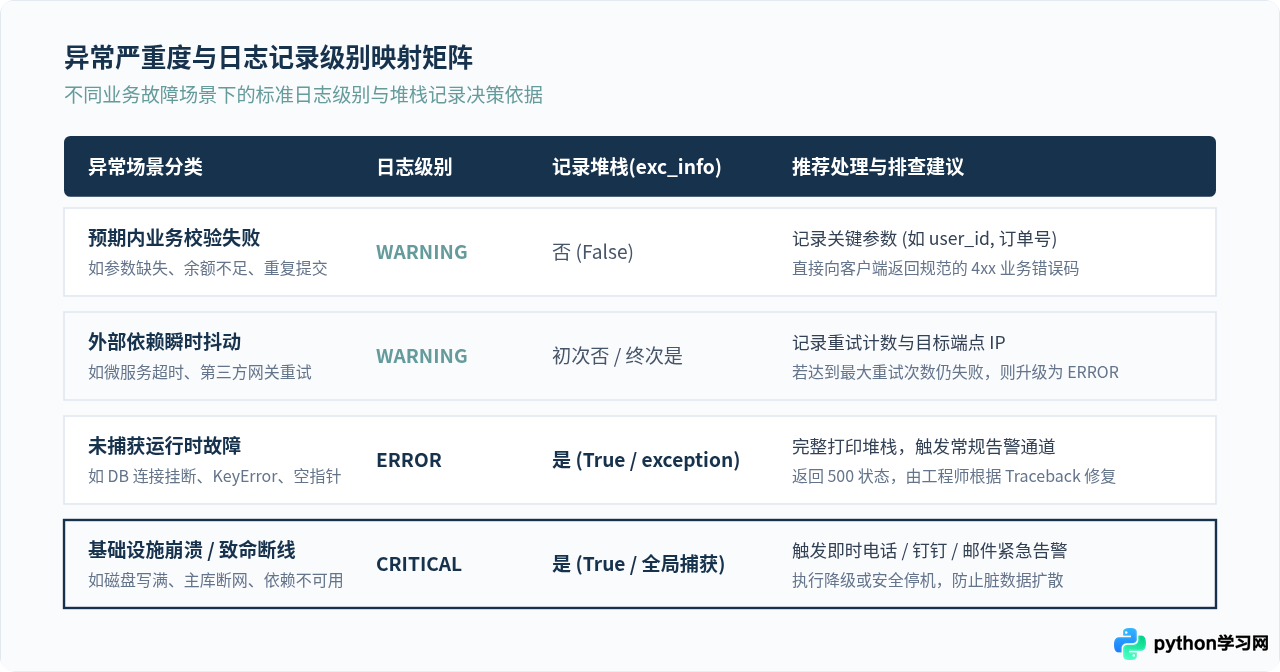
并非所有错误都需要打印全部堆栈。在大型高并发系统中,如果每一次常规的参数校验不合法(如手机号格式不对)都调用 logger.exception(),会导致日志文件迅速膨胀,充满大量无效堆栈,反而淹没了真正需要排查的系统崩溃。
合理的原则是:预期之内的业务分支异常用 WARNING 甚至 INFO,只有未预料的系统错误、外部接口崩塌、断网才用 ERROR 并打印完整堆栈。
五、工程级实战示例:自定义异常、重试与结构化上下文
以下示例展示了一个模拟交易订单扣款的完整场景。示例中定义了清晰的自定义异常层级,利用 try...except...else...finally 保证状态清晰,并在重试耗尽时正确记录错误堆栈:
import logging
import time
from typing import Dict, Any

logger = logging.getLogger("order_service")

# 1. 定义清晰的业务异常基类与子类
class OrderServiceError(Exception):
    """订单业务异常基类"""
    pass

class PaymentGatewayTimeoutError(OrderServiceError):
    """支付网关网络超时异常(可重试)"""
    pass

class InsufficientBalanceError(OrderServiceError):
    """账户余额不足异常(不可重试)"""
    pass

def mock_remote_gateway_call(order_id: str, amount: float, attempt: int) -> bool:
    """模拟外部网关调用"""
    if amount > 10000:
        raise InsufficientBalanceError(f"账户余额不足以支付 {amount} 元")
    if attempt < 2:
        raise PaymentGatewayTimeoutError("网关连接超时 (HTTP 504)")
    return True

def process_order_payment(order_id: str, amount: float, max_retries: int = 3) -> bool:
    """处理订单支付逻辑,包含重试、分级日志与收尾清理"""
    start_time = time.time()
    logger.info("开始处理订单支付 [订单ID: %s, 支付金额: %.2f]", order_id, amount)

    for attempt in range(1, max_retries + 1):
        try:
            # 核心业务执行
            success = mock_remote_gateway_call(order_id, amount, attempt)
            if success:
                logger.info("支付网关调用成功 [订单ID: %s, 尝试次数: %d]", order_id, attempt)
                return True

        except InsufficientBalanceError as balance_err:
            # 业务类错误:无需重试,记录 warning,不打印堆栈
            logger.warning("订单支付失败 (业务校验未通过) [订单ID: %s]: %s", order_id, balance_err)
            raise

        except PaymentGatewayTimeoutError as timeout_err:
            if attempt < max_retries:
                logger.warning(
                    "网关响应超时,准备第 %d 次重试 [订单ID: %s, 原因: %s]",
                    attempt + 1, order_id, timeout_err
                )
                time.sleep(0.5 * attempt)  # 线性避让
            else:
                # 重试耗尽:记录为 ERROR 并输出堆栈
                logger.error(
                    "网关超时重试耗尽,支付最终失败 [订单ID: %s, 总重试: %d]",
                    order_id, max_retries, exc_info=True
                )
                raise OrderServiceError("支付系统繁忙,请稍后重试") from timeout_err

        except Exception as unexpected_err:
            # 未知系统异常:必须捕获并记录 CRITICAL
            logger.critical(
                "订单支付发生严重未知异常 [订单ID: %s]: %s",
                order_id, unexpected_err, exc_info=True
            )
            raise

        finally:
            # 每次尝试或结束时的审计记录
            elapsed = time.time() - start_time
            logger.debug("阶段耗时统计 [订单ID: %s, 耗时: %.4f 秒]", order_id, elapsed)

    return False
六、生产环境配置:日志文件按大小轮转 (RotatingFileHandler)
在服务长期稳定运行的过程中,日志不能直接打在单一文件中,否则会导致文件过大无法打开或挤爆磁盘。标准库 logging.handlers.RotatingFileHandler 能够实现达到指定大小时自动重命名归档,并限制最大保留历史份数。
import os
import logging
from logging.handlers import RotatingFileHandler

def setup_production_logging(log_directory: str = "logs") -> logging.Logger:
    """初始化生产级日志配置:包含控制台与滚动文件双目标输出"""
    os.makedirs(log_directory, exist_ok=True)
    log_file_path = os.path.join(log_directory, "service.log")

    app_logger = logging.getLogger("production_app")
    app_logger.setLevel(logging.DEBUG)  # 捕获所有级别的事件,具体由 Handler 过滤

    # 防止重复添加 Handler 导致日志多重打印
    if not app_logger.handlers:
        # 1. 控制台 Handler:只展示 INFO 及以上内容,适合容器环境日志收集
        console_handler = logging.StreamHandler()
        console_handler.setLevel(logging.INFO)

        # 2. 文件轮转 Handler:单文件最大 10MB,保留 5 个备份文件
        file_handler = RotatingFileHandler(
            log_file_path,
            maxBytes=10 * 1024 * 1024,  # 10 MB
            backupCount=5,
            encoding="utf-8"
        )
        file_handler.setLevel(logging.DEBUG)

        # 3. 规范格式化:时间 | 级别 | 线程名 | 文件名:行号 | 消息主体
        log_format = logging.Formatter(
            fmt="%(asctime)s | %(levelname)-8s | [%(threadName)s] | [%(filename)s:%(lineno)d] - %(message)s",
            datefmt="%Y-%m-%d %H:%M:%S"
        )

        console_handler.setFormatter(log_format)
        file_handler.setFormatter(log_format)

        app_logger.addHandler(console_handler)
        app_logger.addHandler(file_handler)

    return app_logger
七、异常与日志工程化落地总结
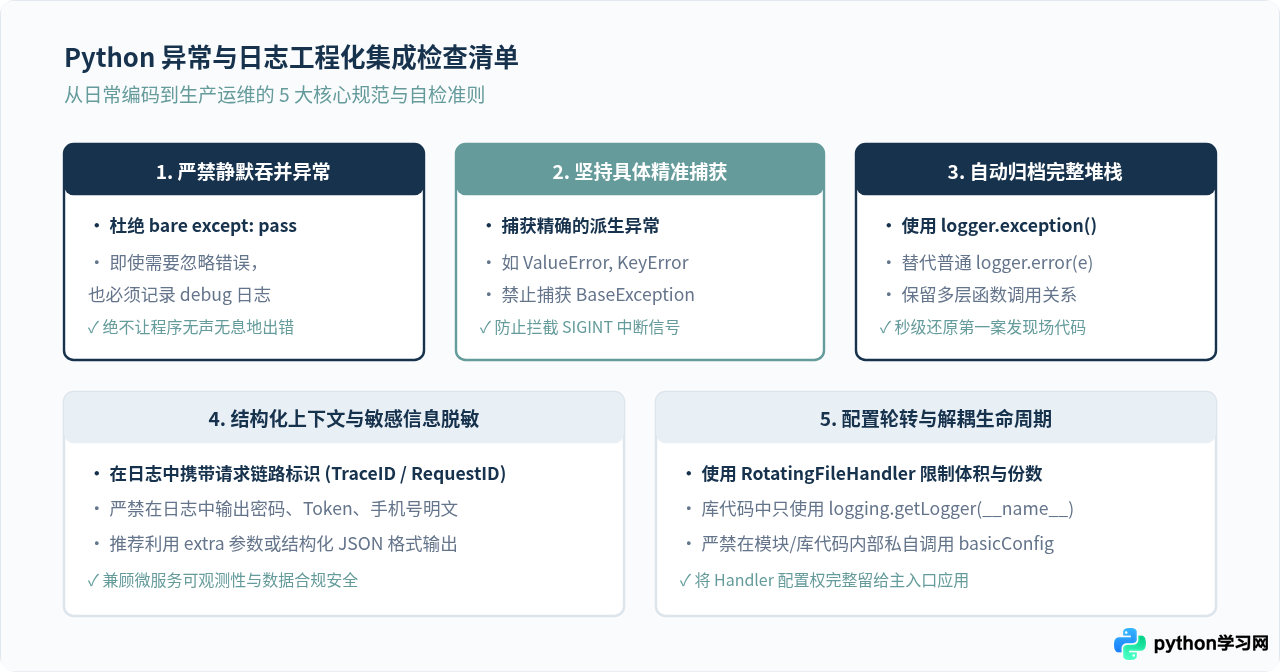
将异常处理与日志记录结合并非单纯堆砌代码,而是一项贯穿软件生命周期的防御性编程实践。以下 5 条自检原则是日常编码时应当遵循的基准:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









