

头歌Python正则表达式实训常见考题代码解析
针对头歌Python正则表达式实训中的常见考题进行系统解析,涵盖字符匹配、贪婪与非贪婪机制、分组捕获以及re.sub文本替换,提供完整可复现代码与避坑指南。
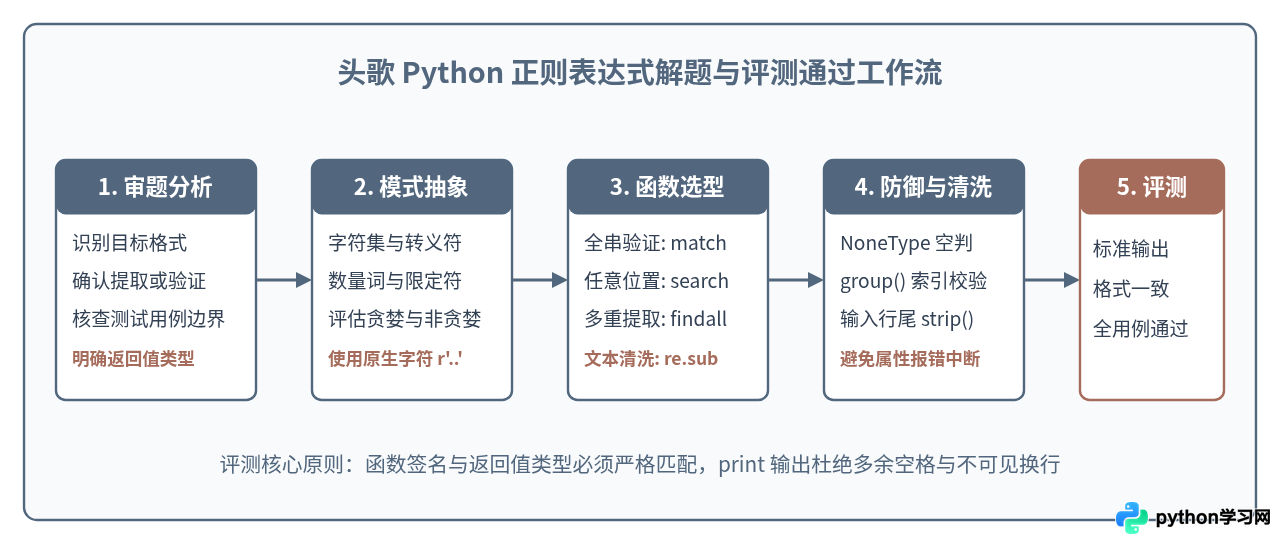
在头歌(Educoder)等在线实训平台上做 Python 正则表达式练习时,很多学习者常遇到一个令人沮丧的现象:在本地交互式解释器里随便输入几个测试字符串都能跑通,一提交测评系统却全线标红。这种情况往往并不是因为核心正则元字符背错了,而是忽略了匹配函数的返回值机制、贪婪量词在跨行文本中的边界判定,或是没有处理 NoneType 异常。本文围绕头歌平台中高频出现的五类典型考题,从题目要求、模式推导到完整代码逐一拆解,理清通过测评所需的关键细节。
一、常见考题一:格式验证类(手机号与电子邮箱校验)
格式验证是头歌第一关或基础关卡最常见的题型。这类题目通常要求编写一个函数,接收一个字符串并判断其是否完全符合特定规范(如合法的中国大陆手机号或标准邮箱地址),若符合则返回 True 或提取出来的号码,否则返回 False 或 None。
1. 核心考点与规则推导
中国大陆手机号的校验规则通常为:以数字 1 开头,第二位是 3-9,后面跟随 9 位数字,总长度刚好为 11 位。若只写 1[3-9]\d{9},在测试字符串 "13800138000123" 上用 re.search() 依然会匹配成功,因为该正则没有对字符串的首尾边界进行约束。
严格匹配必须使用起始锚点 ^ 和结束锚点 $,或者使用 re.fullmatch()。在头歌较老的 Python 评测镜像中,平台更推荐显式书写 ^1[3-9]\d{9}$ 并搭配 re.match()。
2. 实训标准参考代码
import re

def validate_phone(phone_str):
    """
    验证手机号是否合法
    :param phone_str: 输入字符串
    :return: 布尔值 True 或 False
    """
    if not isinstance(phone_str, str):
        return False
    # 去除可能存在的首尾换行或空白字符
    clean_str = phone_str.strip()
    # 严格限定以1开头,第2位3-9,后续9位数字,且全长结束
    pattern = r'^1[3-9]\d{9}$'
    return bool(re.match(pattern, clean_str))

def validate_email(email_str):
    """
    验证标准电子邮箱格式
    :param email_str: 输入字符串
    :return: 匹配成功返回邮箱,失败返回 None
    """
    clean_str = email_str.strip()
    # 用户名允许字母、数字、下划线、中划线和点,域名包含两级以上
    pattern = r'^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$'
    match = re.match(pattern, clean_str)
    return match.group(0) if match else None

# 测评测试调用示例
if __name__ == '__main__':
    test_phone = "13912345678"
    print(validate_phone(test_phone))  # 预期输出: True
    print(validate_phone("12345678901"))  # 预期输出: False
re.match() 的结果调用 .group()。如果未匹配成功,re.match() 会返回 None,直接调用 None.group() 会立刻触发 AttributeError: 'NoneType' object has no attribute 'group',导致平台判题报错退出。
二、常见考题二:模式定位与匹配函数选型对比
实训中第二类失分高发题是混合文本中的模式检索。许多初学者不清楚 re.match()、re.search() 和 re.findall() 的本质差别,常把本该在中间搜索的模式套用了 match(),导致明明写对了正则表达式却拿不到任何结果。
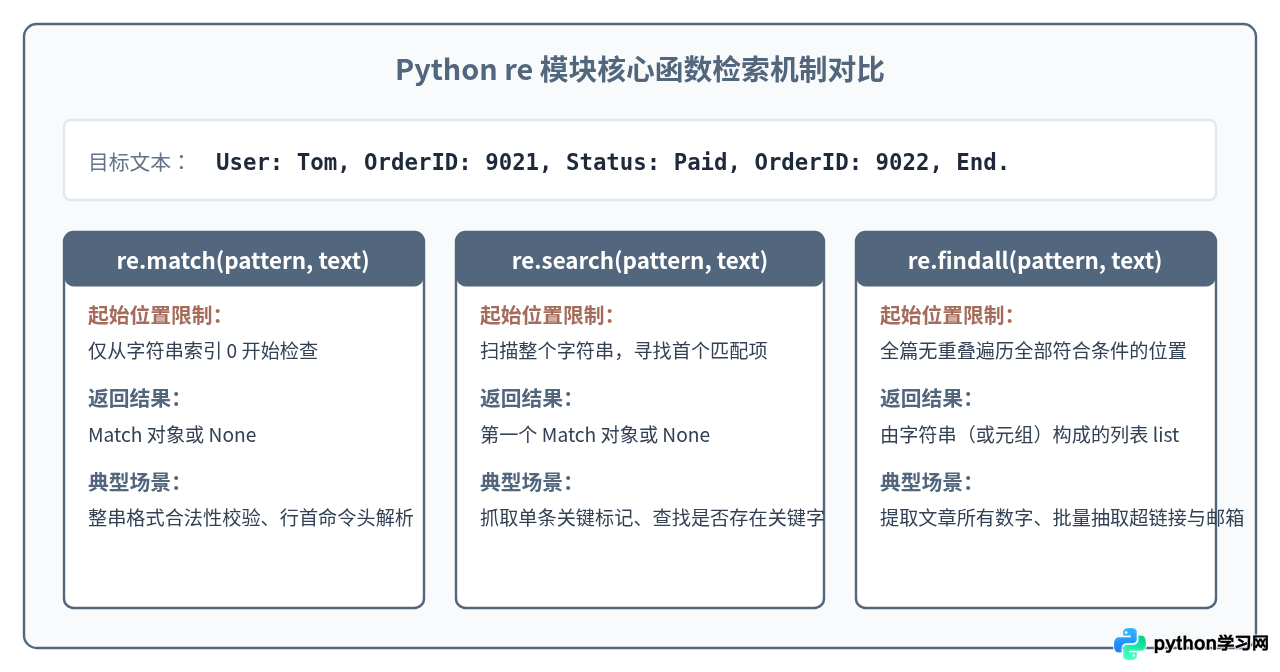
1. 考题场景:提取日志中的首次错误码与全部订单号
题目要求:给定一段应用运行日志,先提取出其中出现的第一个状态错误码(如 ERROR 404 中的 404);再提取出文本中包含的所有订单编号(如 ORD_1001、ORD_1002),以列表形式返回。
2. 实训标准参考代码
import re

def extract_log_data(log_text):
    """
    解析日志文本,提取首个错误码与所有订单号
    """
    # 提取首个错误码:使用 search 扫描全文,避免 match 在首字符未匹配即返回 None
    error_pattern = r'ERROR\s+(\d+)'
    err_match = re.search(error_pattern, log_text)
    first_error_code = err_match.group(1) if err_match else None

    # 提取全部订单编号:使用 findall 提取所有满足条件的订单号
    order_pattern = r'ORD_\d+'
    all_orders = re.findall(order_pattern, log_text)

    return first_error_code, all_orders

# 验证测试
raw_log = "2026-10-27 INFO init; ORD_1001 created; ERROR 500 database down; ORD_1002 retry."
err_code, orders = extract_log_data(raw_log)
print("错误码:", err_code)  # 预期: 500
print("订单列表:", orders)   # 预期: ['ORD_1001', 'ORD_1002']
三、常见考题三:爬虫网页数据提取与贪婪度控制
在涉及网络爬虫的综合实训单元,考题往往给出一段简易 HTML 源码片段,要求从中提取所有链接的 href 属性以及标签内的文本内容。这里最常见的错误是滥用 .* 导致贪婪匹配过度扩展。
1. 贪婪与非贪婪的机制区别
正则表达式中的量词 *、+ 默认是贪婪的,它们会尽可能多地消耗字符,直到整行末尾甚至最后一个闭合标签。如果书写 <a.*>(.*)</a> 去匹配单行中的两个 <a> 标签:
<a href="url1">标题1</a> 其他内容 <a href="url2">标题2</a>贪婪模式下的 <a.*> 会直接吞噬到第二个 <a href="url2">,最终只匹配出一个跨越两个标签的超大结果。在量词后加上问号 ?(即 .*? 或 .+?)可以将其转为惰性/非贪婪模式,一旦遇到紧随其后的界定字符立刻停止消耗。
2. 实训标准参考代码
import re

def extract_html_links(html_content):
    """
    从HTML片段中精准抽取所有链接与超链接文本
    :param html_content: HTML字符串
    :return: 包含 (url, text) 元组的列表
    """
    # 使用非贪婪匹配 href="(.*?)" 并匹配标签内部文本 >(.*?)<
    # re.S (即 re.DOTALL) 保证即使标签内存在换行也能正常跨行匹配
    pattern = r'<a\s+[^>]*?href=[\'"](.*?)[\'"][^>]*?>(.*?)</a>'
    matches = re.findall(pattern, html_content, flags=re.S)

    # 进一步清洗文本内的空白换行
    results = []
    for href, text in matches:
        results.append((href.strip(), text.strip()))
    return results

# 测试验证
html_snippet = '''
<div class="nav">
    <a href="https://educoder.net/path1"> 实训主页 </a>
    <span>间隔</span>
    <a href="https://educoder.net/path2"> 任务指南 </a>
</div>
'''
print(extract_html_links(html_snippet))
# 预期输出: [('https://educoder.net/path1', '实训主页'), ('https://educoder.net/path2', '任务指南')]
四、常见考题四:分组捕获与结构化字段抽取
在较复杂的解析题目中,通常要求将非结构化的文本串拆解并组装成字典或特定元组结构。正则表达式通过圆括号 () 实现子模式捕获。头歌实训通常考查两种方式:基于位置的常规索引捕获与命名捕获组 (?P<name>...)。
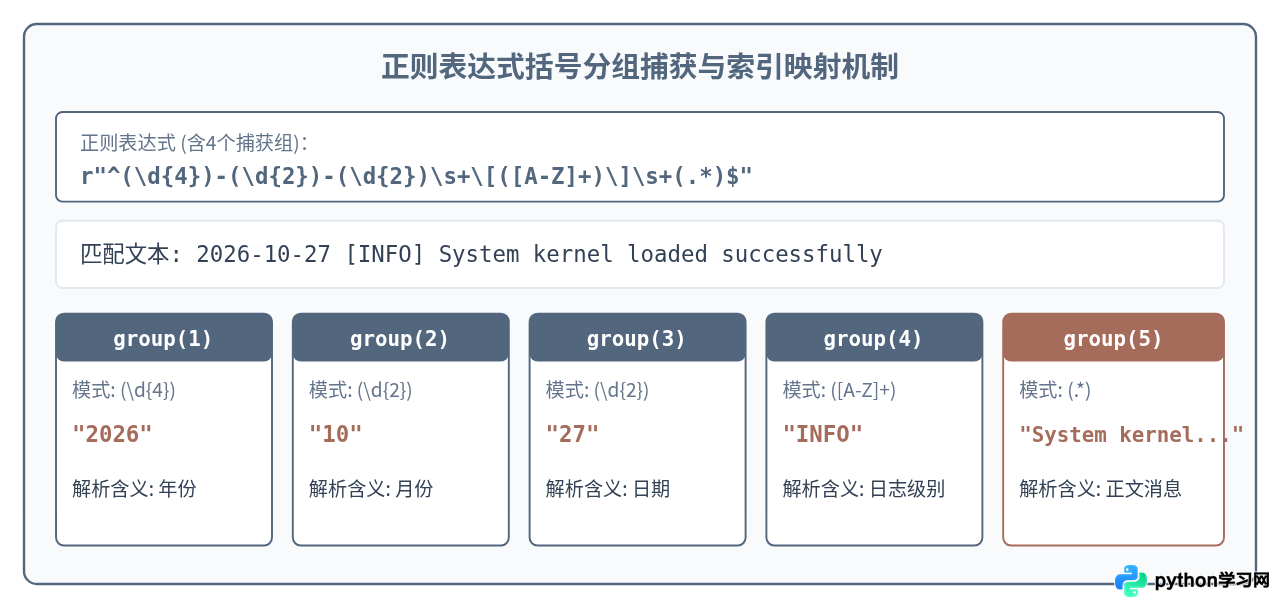
1. 命名捕获组的优势与头歌出题倾向
当正则表达式中包含多个圆括号时,依靠数字索引 group(1)、group(2) 容易产生序号偏移(特别是在后续维护中插入了新的括号)。利用语法 (?P<name>pattern) 可以为匹配组赋予语义化标签,并直接调用 match.groupdict() 生成标准 Python 字典。头歌的综合大题常以此作为核心考查点。
2. 实训标准参考代码
import re

def parse_log_line(log_line):
    """
    使用命名分组将日志行解析为字典
    :param log_line: 单行日志字符串
    :return: 包含 date, level, message 的字典,未匹配则返回空字典
    """
    pattern = r'^(?P<date>\d{4}-\d{2}-\d{2})\s+\[(?P<level>[A-Z]+)\]\s+(?P<message>.*)$'
    match = re.match(pattern, log_line.strip())
    if match:
        return match.groupdict()
    return {}

# 测试执行
sample_line = "2026-10-27 [WARNING] Disk storage usage exceeds 85%"
result = parse_log_line(sample_line)
print(result)
# 预期输出: {'date': '2026-10-27', 'level': 'WARNING', 'message': 'Disk storage usage exceeds 85%'}
五、常见考题五:文本替换与脱敏清洗(re.sub 应用)
在数据清洗单元,考题往往要求对敏感信息(如用户身份证号、电话号码)进行打码脱敏,或者把连续的多余空白压缩为单一空格。这类题目的解题核心是 re.sub() 的后向引用以及回调函数。
1. 后向引用语法机制
在替换字符串中,可以使用 \1、\2 或 \g<1>、\g<name> 指代前面正则表达式中捕获的第 1、第 2 个分组。例如将 11 位手机号中间 4 位替换为星号:原串为 13812345678,模式写成 r'(\d{3})\d{4}(\d{4})',替换串写作 r'\1****\2',即可精确保留前后部分,仅替换中间 4 位。
2. 实训标准参考代码
import re

def mask_sensitive_info(text):
    """
    对文本中的手机号与身份证号进行脱敏清洗
    手机号: 13812345678 -> 138****5678
    身份证号: 18位 -> 前6位保留,后4位保留,中间8位星号
    """
    # 手机号脱敏
    phone_pattern = r'(1[3-9]\d)\d{4}(\d{4})'
    text_masked = re.sub(phone_pattern, r'\1****\2', text)

    # 18位身份证脱敏
    id_pattern = r'(\d{6})\d{8}(\d{3}[\dXx])'
    text_masked = re.sub(id_pattern, r'\1********\2', text_masked)

    return text_masked

# 测试用例
user_info = "用户张三,手机号:13912345678,身份证号:110101199003072345 已实名。"
print(mask_sensitive_info(user_info))
# 预期输出: 用户张三,手机号:139****5678,身份证号:110101********2345 已实名。
六、头歌评测机制避坑总结
在头歌实训提交代码时,除了核心逻辑正确外,平台特有的评测机制也决定了能否顺利通过。许多本地运行无误的代码,往往在面对隐藏测试用例时暴露隐藏问题。
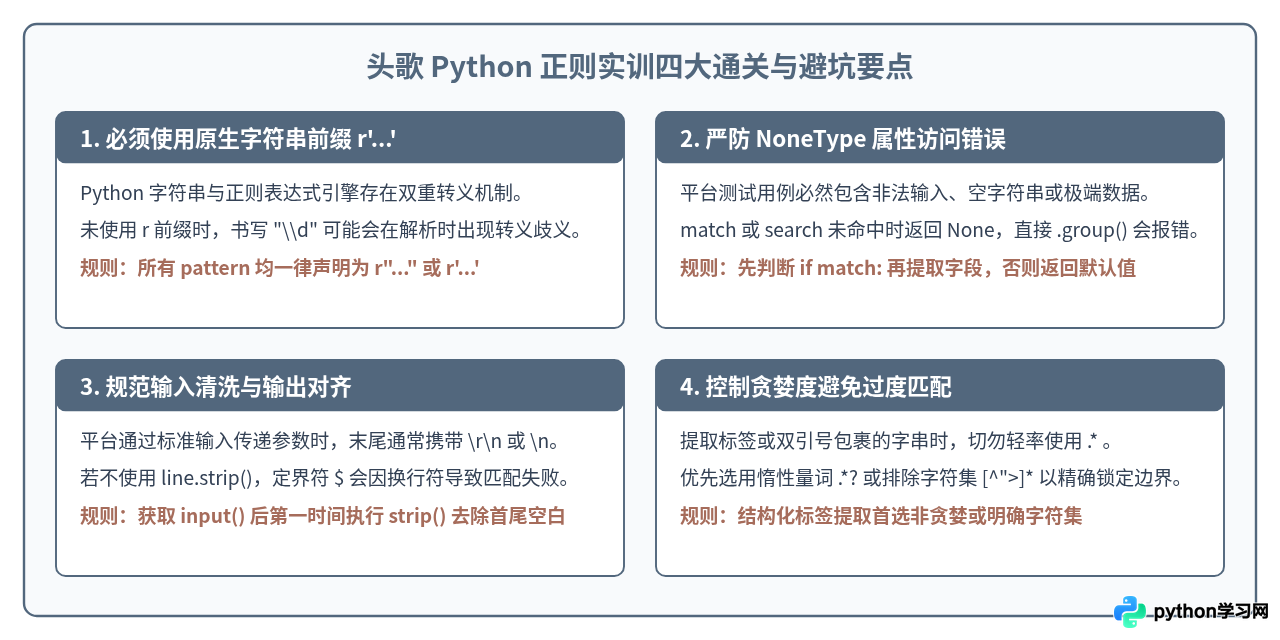
掌握以上五类考题模式后,面对平台实训的大多数关卡都可以迅速形成解题思路。编写代码时,先在草稿中理清边界,始终坚持使用原生字符串,做好空值判断,并利用 strip() 过滤换行杂质,便能稳定通过各类隐藏测评用例。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









