

Python日期处理库怎么选?datetime、dateutil与pandas对比
对比Python中三大主流日期处理方案datetime、python-dateutil与pandas的核心差异,从字符串解析、日历偏移计算、时区支持与运行性能等维度提供清晰的选型依据。
在 Python 中处理日期与时间,选型核心取决于两个指标:数据吞吐规模与日历推算逻辑的复杂度。对于单一时间戳记录或轻量后端逻辑,标准库 datetime 零外部依赖且速度极快;当面对模糊格式字符串清洗或跨月、跨周等复杂自然日历推算时,第三方库 python-dateutil 是针对性补强的利器;而一旦进入数据分析、表格导入、多时序重采样或百万级批量向量化处理,pandas 则是具备性能优势的处理框架。本文从接口特性、解析能力、计算规则及运行时开销切入,帮助你在不同开发场景中做出准确选择。
一、库定位与设计目标差异
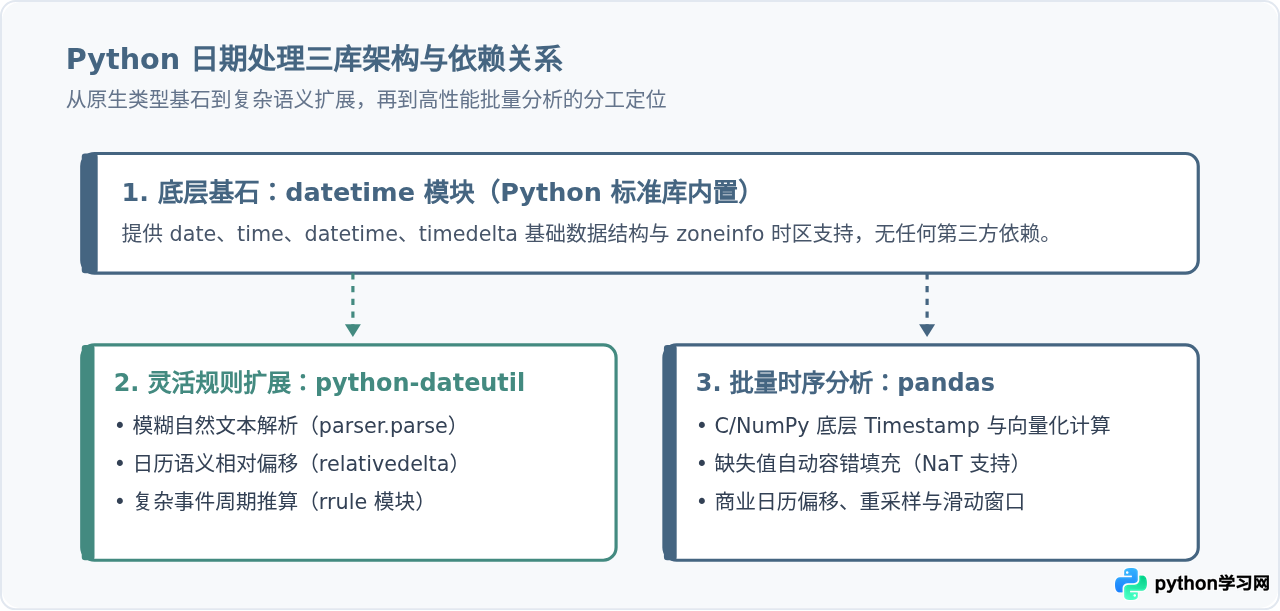
在编写业务代码前,必须先厘清三个库在 Python 生态中承担的具体角色:
datetime:作为 Python 标准库,其定位是“轻量、基础、严谨”。它定义了不可变的date、time、datetime与timedelta类型。标准库不追求自动猜测或复杂统计,核心目标是保证类型安全与最低运行开销。python-dateutil:作为datetime的增强插件库,它并非替代datetime,而是返回原生datetime实例。其核心目标是弥补原生库在“非标准字符串解析”和“人类日历规则(如按月、按星期五递增)”上的不足。pandas:定位是“表格与时序数据分析引擎”。它将单个时间对象封装为pd.Timestamp,将序列组织为pd.DatetimeIndex,通过底层 C 语言数组实现高吞吐运算。引入它通常意味着需要对表格整列执行变换。
二、日期字符串解析:严格匹配 vs 模糊推断 vs 批量容错
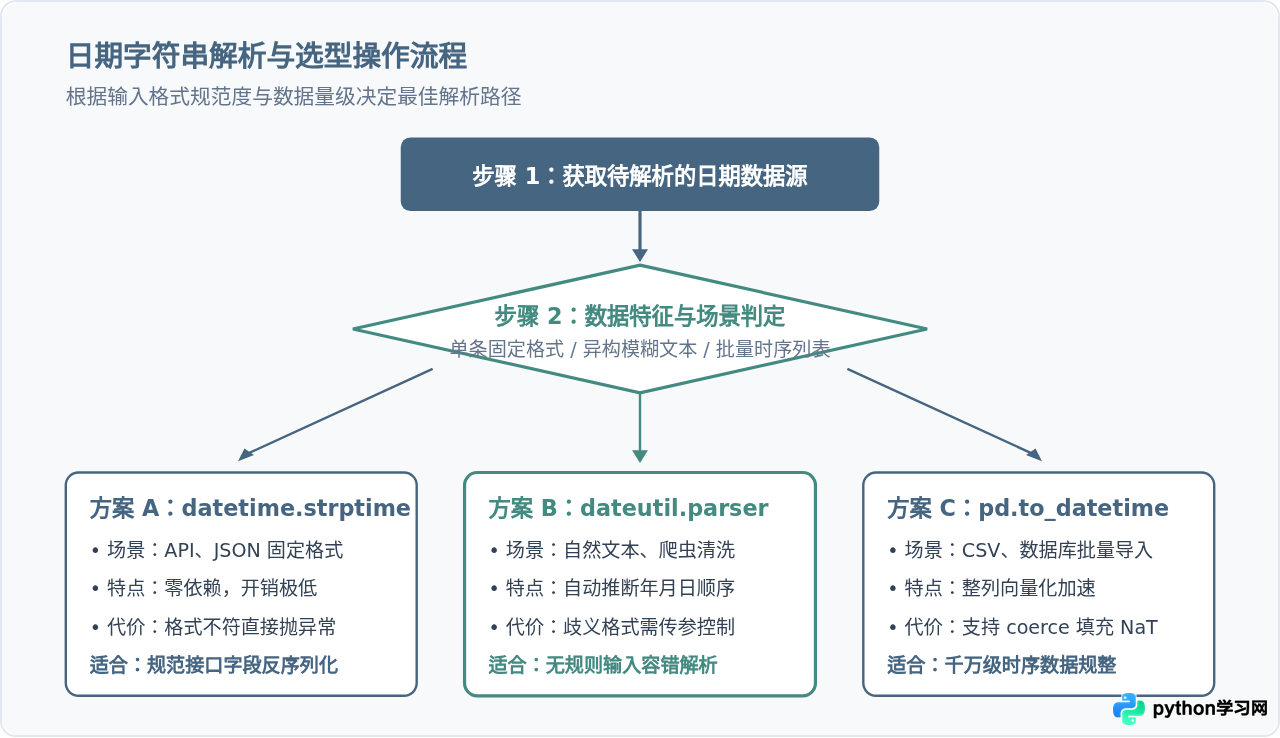
将外部输入的字符串转换为可计算的时间对象,是业务中最频繁的步骤。三个库在解析策略上呈现截然不同的设计哲学:
1. datetime:确定格式下的严苛校验
当格式固定且可预期时,datetime.strptime 保证了解析结果的精确性。它的优势是快速且不产生解析歧义:
from datetime import datetime

# 规范输入:格式必须与模式字符串完全对应
date_str = "2026-03-15 14:30:00"
dt = datetime.strptime(date_str, "%Y-%m-%d %H:%M:%S")

# 示例输出:2026-03-15 14:30:00
print(f"解析成功: {dt}")
若外部输入偶尔带毫秒或微秒,或者日期连接符在 - 与 / 之间跳跃,strptime 会立即抛出 ValueError,需要开发者手动编写异常捕获逻辑。
2. dateutil:模糊输入与复杂格式的智能推断
dateutil.parser.parse 能自动识别绝大多数常见格式,甚至能剥离包裹在日历中的英文字符与多余空格:
from dateutil import parser

# 格式各异的混合来源
samples = [
    "2026.03.15",
    "March 15, 2026 2:30 PM",
    "2026-03-15T14:30:00+08:00",
    "Logged at 2026-03-15 by admin"
]

for item in samples:
    # fuzzy=True 可自动忽略非日期文本干扰
    parsed = parser.parse(item, fuzzy=True)
print(f"原文本: '{item}' -> 解析结果: {parsed}")面对诸如 03/04/2026 这类既可读作 3月4日 也可读作 4月3日 的文本,dateutil 默认采用美式排布(月前日前)。处理中国或欧洲标准数据时,需显式传入 parser.parse(s, dayfirst=True) 以避免隐蔽业务逻辑错误。
3. pandas:大规模整列批量转换与容错清洗
若数据来自 Excel 导出或百兆级日志,逐行调用 dateutil 会导致漫长的解释器循环。pandas.to_datetime 能进行整列矢量化解析:
import pandas as pd

raw_series = pd.Series([
    "2026-01-01",
    "2026/02/01",
    "invalid_date_format",
    "2026-04-01 10:00:00"
])

# errors='coerce' 会将无法解析的脏数据平滑转换为 NaT(Not a Time),不中断整体流程
clean_dates = pd.to_datetime(raw_series, errors='coerce')
print(clean_dates)
三、时间算术运算:物理差值、日历语义与商业周期
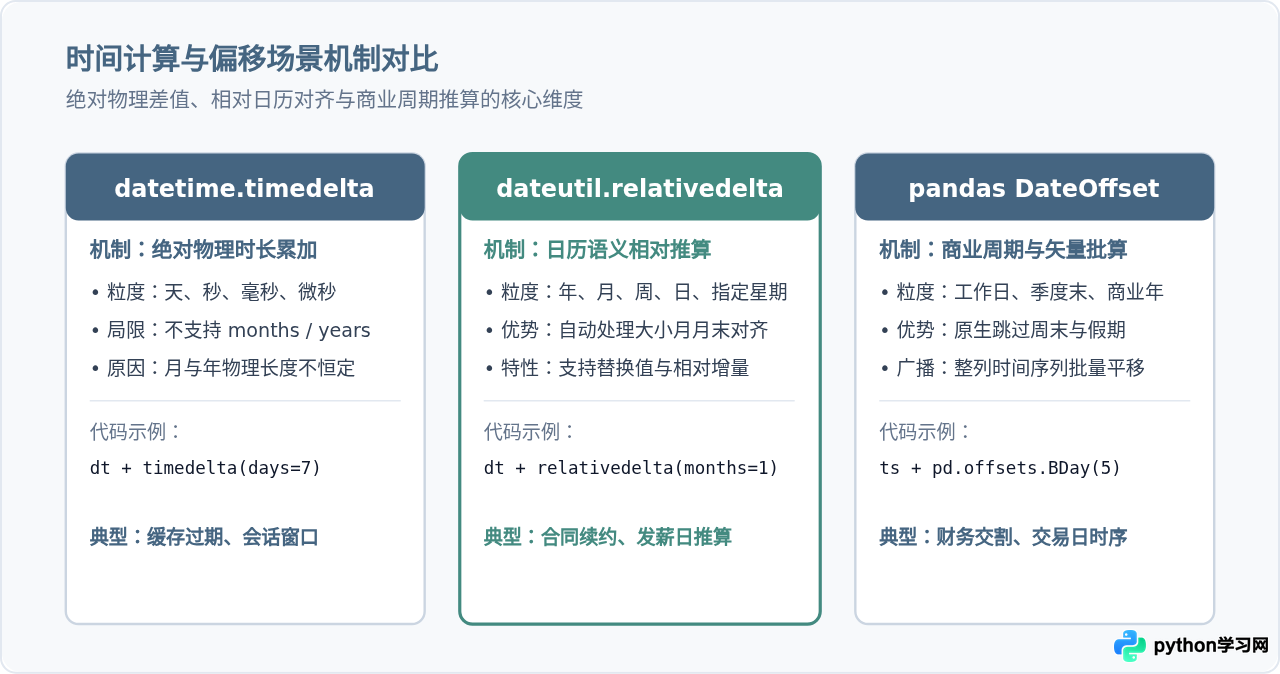
计算“当前时间加 30 天”与计算“当前时间加 1 个月”,在日历逻辑上是两套完全不同的规则。下表展示了三个库在时间加减维度的核心能力差异:
1. 原生 timedelta 的物理边界
标准库 timedelta 仅接收 days, seconds, microseconds, milliseconds, minutes, hours, weeks。如果你尝试传入 months=1,会直接引发类型初始化错误。因为在真实世界中,“一个月”可能包含 28、29、30 或 31 天,标准库为了语义严谨,拒绝假设月份长度。
2. relativedelta 的自然日历对齐
处理“下月最后一天”或“往后顺延两年”等业务,python-dateutil.relativedelta 提供了完整的日历语义支持:
from datetime import datetime
from dateutil.relativedelta import relativedelta, FR

base_date = datetime(2026, 1, 31)

# 场景 A:1月31日加1个月,自动对齐到平年2月28日
next_month = base_date + relativedelta(months=1)
print(f"平年月末顺延: {next_month}")  # 2026-02-28 00:00:00

# 场景 B:获取下个月的最后一个星期五
target_friday = base_date + relativedelta(months=1, day=31, weekday=FR(-1))
print(f"下月最终周五: {target_friday}")
3. pandas 的商业日历与频率重采样
对于“5 个工作日后结款(排除周六日)”这类统计需求,pandas.offsets 能直接对整个数据表广播应用:
import pandas as pd

# 创建连续多天的基准时间序列
dates = pd.date_range("2026-05-01", periods=3, freq="D")

# 批量顺延 3 个商业工作日(自动跳过周末)
settle_dates = dates + pd.offsets.BDay(3)
print(settle_dates)
四、时区处理与冬令时转换
在时区支持上,各库经历了明显的版本演进:
- Python 3.9+ 时代的 datetime:Python 3.9 引入了标准库
zoneinfo,彻底取代了历史遗留的第三方库pytz。通过datetime.now(zoneinfo.ZoneInfo("Asia/Shanghai"))即可获取标准的带时区(Aware)对象,无需额外安装任何库。 - dateutil.tz 的系统探测:
dateutil.tz.tzlocal()能够自动嗅探当前主机的本地时区规则,在编写需要适应不同宿主机环境的客户端命令行工具时非常便捷。 - pandas 向量化时区转换:对于包含百万行时间戳的 DataFrame,逐行做时区转换会极其耗时。通过
Series.dt.tz_localize('UTC').dt.tz_convert('Asia/Shanghai')可以在底层数组上完成毫秒级转换。
五、执行性能与内存开销实测分析
为了直观说明性能差异,我们以单对象高频调用与十万条批量处理两个典型极端场景做对比:
- 单时间戳操作开销:
datetime实例是极其轻量且固化的 C 结构体。生成一个datetime.now()仅需约 100 纳秒;而pd.Timestamp.now()由于附带丰富的属性检查与对象体系,开销是原生对象的 5~10 倍。因此在每秒数十万请求的高吞吐 API 内部路由中,应保持原生datetime。 - 大规模批量处理开销:当数据量提升至 100,000 条日期解析时,使用原生循环调用
datetime.strptime需耗费约 0.3 秒,调用dateutil.parser.parse则需近 1.2 秒(由于其复杂的推断分支与正则分词);而pd.to_datetime(cache=True)依靠连续内存与 C 加速,仅需 0.04 秒左右。
六、选型决策指南与总结矩阵
针对不同项目架构与技术栈要求,各库的特性指标汇总如下:
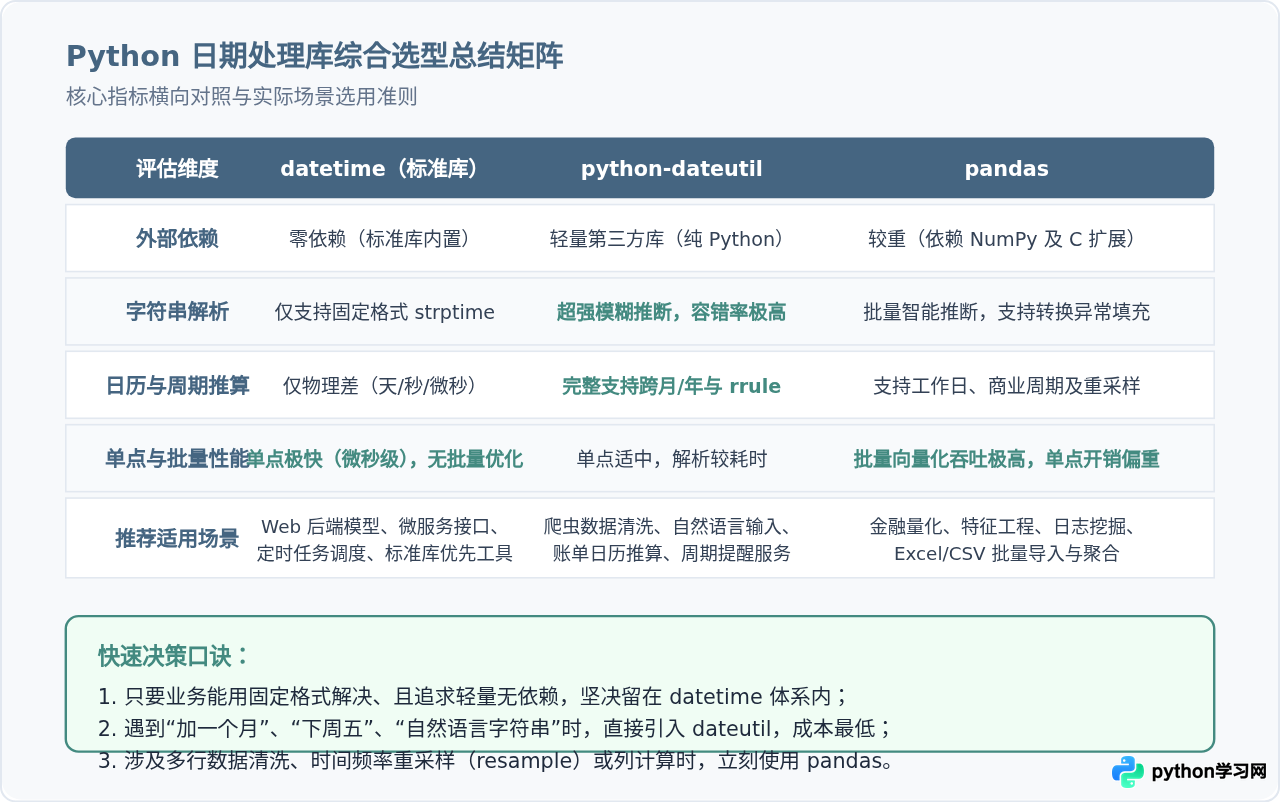
综上所述,三者并非相互排斥的竞争关系,而是分工鲜明的层次化工具。在实际项目开发中,通用的做法是以 datetime 为公共数据交互基准,局部引入 dateutil 处理复杂的非标输入与相对周期,而在数据分析管道与批处理作业中全量交给 pandas,从而在开发效率、运行性能与维护成本之间取得理想平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









