

Python基础语法速查清单:从变量命名到模块导入
一份系统、实用的Python 3核心基础语法速查清单,涵盖变量命名规则与内存模型、基本数据类型操作、流程控制结构、函数与作用域、以及模块导入机制,附带清晰图解与易错避坑指南。
本文为初学者与日常开发者提供一份系统、实用的 Python 3 基础语法速查参考。内容按照程序编写的自然层级展开,从最底层的变量命名规范、基本数据类型操作,递进到分支循环控制结构、函数封装及作用域解析,最终落实到工程模块与包的规范导入机制,帮助读者快速厘清关键语法规则与常见排错路径。
一、变量命名规范与内存引用机制
Python 采用动态类型系统,变量本身没有固定类型,其本质是绑定在内存对象上的标签或引用。掌握变量命名的标准约定与背后的对象引用模型,是写出健壮代码的第一步。
1. 标识符规则与 PEP 8 命名约定
在语法层面,Python 标识符必须以英文字母或下划线(_)开头,后续可包含字母、数字及下划线,区分大小写,且严禁使用 Python 保留关键字(如 def、class、for 等)。在工程实践中,推荐遵循官方 PEP 8 规范:
- 变量与函数名:统一采用蛇形小写加下划线命名法(snake_case),例如
total_amount、calculate_tax()。 - 常量:全局或模块级不可变常量采用全大写加下划线,例如
MAX_RETRIES = 3。 - 类名:采用大驼峰命名法(PascalCase),例如
DataProcessor。 - 特殊前缀:单下划线开头(如
_internal_flag)通常表示模块或类的弱内部使用标识;双下划线(如__secret)触发名称改写机制。
2. 赋值形式与对象引用原理
在 Python 中执行 x = [1, 2, 3] 时,解释器首先在堆内存中创建列表对象,随后将标识符 x 指向该对象内存地址。若执行 y = x,则是使 y 同样指向该列表,而非产生新的副本。
# 多重赋值与变量解包
a, b = 10, 20               # 序列解包赋值
x = y = 0                   # 链式赋值(两者指向同一整数对象)
first, *middle, last = [1, 2, 3, 4, 5]  # 星号解包:middle 收集为 [2, 3, 4]

# 不可变对象与可变对象区别
num = 100
num += 1                    # 整数不可变,创建新对象 101 并重定向引用

items = [1, 2]
items.append(3)             # 列表可变,直接在原地修改内存内容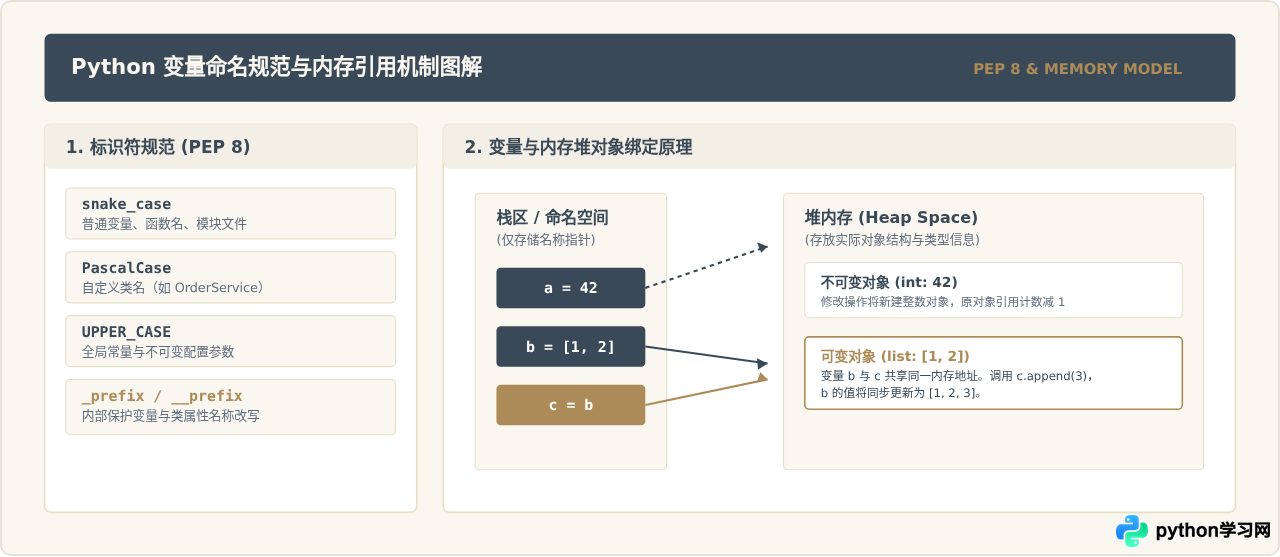
二、核心数据类型与常用操作速查
Python 常见内置类型主要分为标量类型(数值、布尔、字符串)与复合容器类型(列表、元组、字典、集合)。各类型的特性与典型操作对比如下:
| 数据类型 | 可变性 | 典型字面量 | 常用核心操作 | 适用场景与注意事项 |
|---|---|---|---|---|
| int / float | 不可变 | 42, 3.14 |
+, -, *, /, //(整除), %(取模), **(幂) |
浮点数存在二进制精度截断,精密计算需用 decimal 模块。 |
| str | 不可变 | "hello" |
s.strip(), s.split(","), "-".join(list), f"{var}" |
字符串拼接推荐使用 f-string 或 join(),频繁用 + 会产生额外拷贝。 |
| list | 可变 | [1, 2, 3] |
append(), extend(), pop(), sort(), 切片 lst[1:3] |
有序序列,适用于动态增删元素。末尾增删为 O(1),头部插入为 O(n)。 |
| tuple | 不可变 | (1, 2, 3) |
索引访问 t[0], 计数 t.count(), 拆包 x, y = t |
不可变记录,可用作字典的键或函数返回多值;比列表轻量高效。 |
| dict | 可变 | {"id": 1} |
d.get("key", default), d.keys(), d.items(), d.update() |
哈希键值对映射,查询与更新平均时间复杂度为 O(1);键必须是可哈希对象。 |
| set | 可变 | {1, 2, 3} |
add(), remove(), 交集 s1 & s2, 并集 s1 | s2 |
无序且元素唯一,常用于集合去重与高效成员隶属度检测。 |
对嵌套列表执行 new_list = old_list.copy() 或切片 old_list[:] 仅为外层容器创建新列表,内部子对象仍指向旧引用。若要彻底复制完整嵌套层级,必须使用 import copy; new_list = copy.deepcopy(old_list)。
三、流程控制结构与代码缩进
Python 废弃了大括号语法,强制使用统一的缩进(推荐 4 个空格,严禁混用 Tab 与空格)来划定代码块层次。核心控制结构涵盖条件分支与两种基本循环。
1. 条件判断(if / elif / else)
Python 会自动将表达式评估为布尔值。假值(Falsy)包括:None、False、数值 0 / 0.0、空序列与集合 "", [], (), {}, set()。其余对象均评估为真值。
if score >= 90:
    grade = "A"
elif score >= 75:
    grade = "B"
else:
    grade = "C"

# 三元条件表达式(适合简洁赋值)
status_desc = "合格" if score >= 60 else "待补测"
2. 循环遍历与控制跳转(for / while / break / continue / else)
for 循环专用于迭代可迭代对象(Iterable),结合 enumerate() 可同时获取索引与值;while 循环依据布尔条件重复执行。特别注意,Python 允许为循环添加 else 子句,该子句仅在循环完整执行且未遭遇 break 时触发。
# 1. enumerate 迭代
targets = ["Alpha", "Beta", "Gamma"]
for index, name in enumerate(targets, start=1):
    print(f"步骤 {index}: 执行 {name}")

# 2. 循环中的 break 与 else 配合检索
for item in [11, 23, 44, 55]:
    if item % 2 == 0:
        print(f"找到偶数: {item}")
        break
else:
    # 仅在列表没有命中 break 时触发
    print("未发现符合条件的偶数")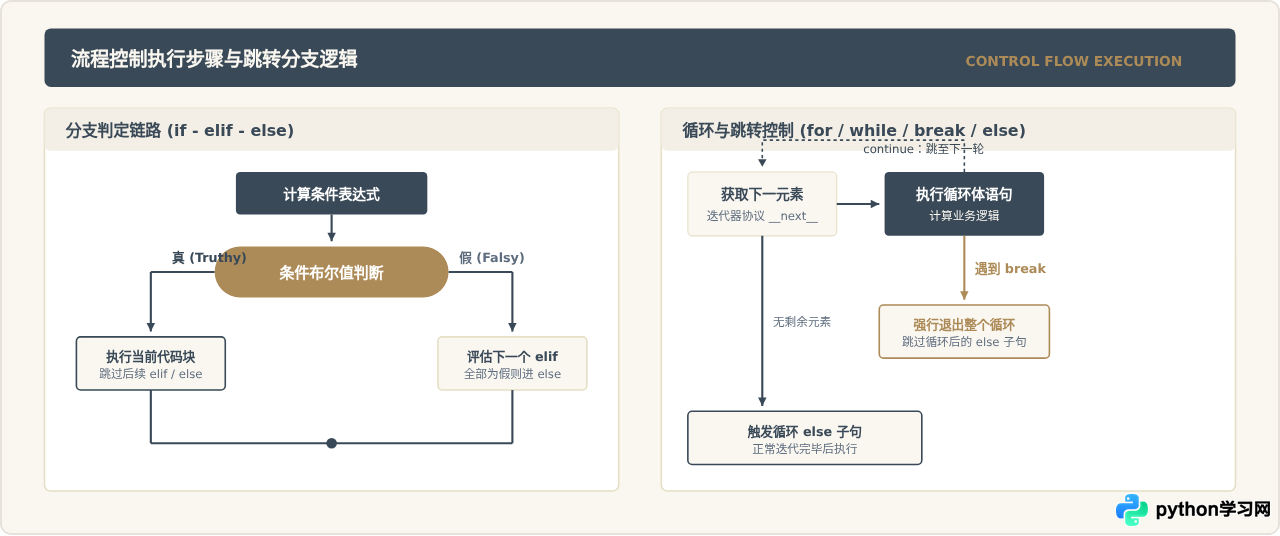
四、函数定义、参数传递与作用域
函数是 Python 的一等公民(First-Class Citizens),既可以作为参数传递,也可以嵌套定义与返回。清晰的参数层级组织与严格的作用域查找规则,是组织模块化代码的核心。
1. 参数顺序与解包规则
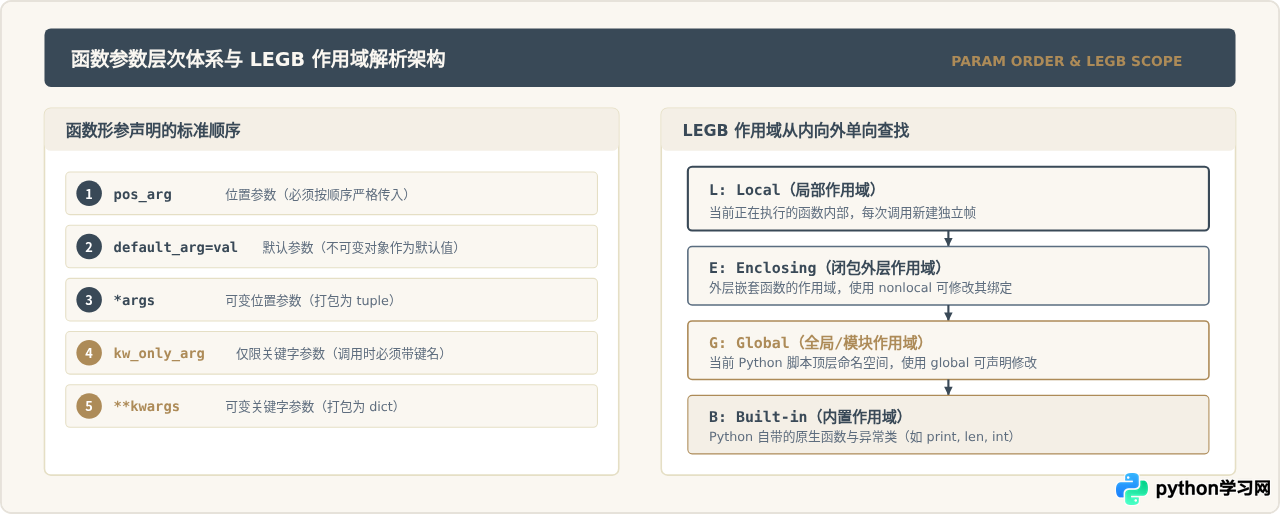
定义函数时,形参必须严格遵从以下从左至右的排序次序:
- 位置参数(Positional Arguments):必须按序传递。
- 默认参数(Default Arguments):为可选参数赋初始默认值。
- 可变位置参数(
*args):将多余的位置参数打包为元组(tuple)。 - 仅限关键字参数(Keyword-Only Arguments):位于
*或*args之后,调用时必须显式指定形参名。 - 可变关键字参数(
**kwargs):将多余的键值对参数打包为字典(dict)。
def generate_report(title, category="通用", *tags, notify=True, **extra_meta):
    print(f"标题: {title}, 分类: {category}, 标签: {tags}, 通知: {notify}")
    print(f"扩展元数据: {extra_meta}")

# 规范调用
generate_report("系统运行简报", "运维", "CPU", "内存", notify=False, env="Prod", cluster="K8s")Python 函数的默认参数在函数定义加载时求值一次并保存在函数对象的 __defaults__ 中。若使用列表或字典作为默认值(如 def add_item(val, container=[])),多次调用将共享修改同一个列表。标准做法应设为 container=None,并在函数内部判断 if container is None: container = []。
2. 变量作用域与 LEGB 解析原则
当在函数内部读取一个变量标识符时,Python 按照 LEGB 顺序由内向外层层检索,一旦在某一作用域内找到即刻停止:
- L (Local):函数或方法内部定义的局部作用域。
- E (Enclosing):外部闭包函数的作用域(非全局)。可使用
nonlocal声明修改。 - G (Global):当前模块文件顶层的全局作用域。在函数内部若要重新绑定全局变量,需用
global声明。 - B (Built-in):解释器内置名称空间(如
len、range、ValueError)。
五、模块与包的导入规范
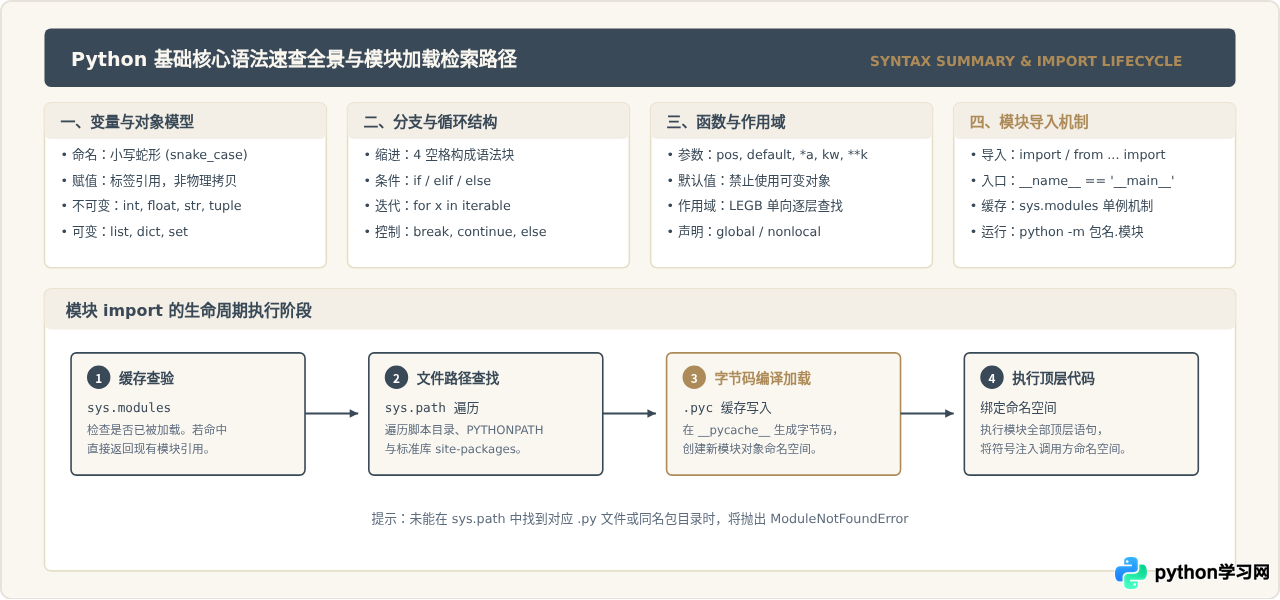
每一个以 .py 结尾的文件都是一个独立模块(Module),包含 __init__.py 文件的目录即构成一个包(Package,Python 3.3+ 引入命名空间包无需强求,但显式包含仍为良好实践)。掌握导入形式与查找原理是构建多文件项目的核心保障。
1. 导入语句的标准形式
PEP 8 推荐将导入语句置于文件最顶部,并按照以下三组依次排列,组间用空行隔开:
- 标准库模块(如
os,sys,json) - 第三方第三方库(如
requests,numpy) - 本地应用或当前项目的相对/绝对导入
# 标准库
import sys
from pathlib import Path

# 导入特定函数并赋予别名
from math import sqrt as square_root

# 严禁使用通配符导入(污染命名空间且易引发同名覆盖)
# from os import *  <-- 反模式
2. __name__ == '__main__' 的执行入口隔离
当直接在终端运行脚本(如 python main.py)时,解释器将该脚本的内置变量 __name__ 赋值为 "__main__";若该文件被其他模块通过 import main 导入,其 __name__ 则是其真实模块名 "main"。利用此特性可隔离业务执行与单元测试代码。
def compute_average(data_list):
    return sum(data_list) / len(data_list) if data_list else 0.0

if __name__ == "__main__":
    # 仅在直接执行本文件时运行,被导入时不触发
    test_data = [10, 20, 30]
    print(f"自测均值: {compute_average(test_data)}")
3. 模块搜索路径与 ModuleNotFoundError 排查路径
当执行 import my_module 时,Python 解释器按如下先后次序进行检索:
- 已加载缓存(sys.modules):检查该模块是否已被加载进内存字典,存在则直接复用。
- 内置模块表:检查是否为 Python 内置 C 扩展模块。
- 搜索路径列表(sys.path):依次遍历
sys.path中的目录。其第 1 个元素是启动脚本所在目录,随后是环境变量PYTHONPATH指定目录,最后是标准库和site-packages。
1. 确认执行根目录:若在子包内执行脚本导致找不到同级或上层包,应退到项目根目录,通过模块化参数运行:python -m mypackage.submodule。
2. 循环导入(Circular Import):模块 A 导入模块 B,模块 B 又在顶层导入模块 A。若发生此错误,应重构抽取公共接口,或将 import 延迟放置在函数体内部执行。
六、常用语法与避坑对照表
下表汇集了初学者在日常编码中最高频出现的语法误区及其标准写法:
| 易错场景 | 错误 / 反模式写法 | 标准推荐写法 |
|---|---|---|
| 判断对象是否为 None | if val == None:(受类 __eq__ 重载影响) |
if val is None:(身份比对,直接比对内存地址) |
| 循环中边遍历边删除 | for x in lst: lst.remove(x)(迭代器指针漂移漏删) |
lst = [x for x in lst if not cond](列表推导式重构) |
| 文件读取与资源关闭 | f = open("data.txt"); text = f.read(); f.close()(异常时泄漏) |
with open("data.txt", "r", encoding="utf-8") as f:(上下文管理器自动释放) |
| 字典安全取值 | val = my_dict["missing_key"](直接崩溃报 KeyError) |
val = my_dict.get("missing_key", default_val) |
| 多条件链式比较 | if a > 0 and a < 10: |
if 0 < a < 10:(原生支持链式连续比较) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









