

Python字符串拼接:str.join()与+操作符的区别及用法
深入对比Python字符串拼接中str.join()与+操作符的核心差异,剖析底层不可变性原理、内存分配机制与时间复杂度,并提供清晰的操作步骤与工程选型建议。
+ 操作符还是 str.join() 并不是个人书写习惯的问题,而是由底层内存机制决定的性能选择。简而言之:拼接两三个已知变量时,使用 +(或 f-string)最为直观;但在合并列表、元组等集合中的大量字符串或在循环累加时,必须使用 str.join(),它能避免频繁的内存重新分配,将执行效率从 O(N²) 优化至 O(N)。
一、+ 操作符的用法与底层运行机制
在 Python 中,+ 操作符是最直观的字符串拼接手段。当操作数是两个字符串对象时,解释器会调用其内置的加法方法生成一个新字符串:
# 基础 + 拼接示例
first_name = "Guido"
last_name = "van Rossum"
full_name = first_name + " " + last_name
print(full_name)  # 输出: Guido van Rossum
表面上看,这种写法清晰明了,但在涉及多个或动态循环拼接时,会隐藏严重的性能隐患。这是因为 Python 中的字符串属于不可变对象(Immutable)。一旦创建,其在内存中的内容和长度就不可再修改。
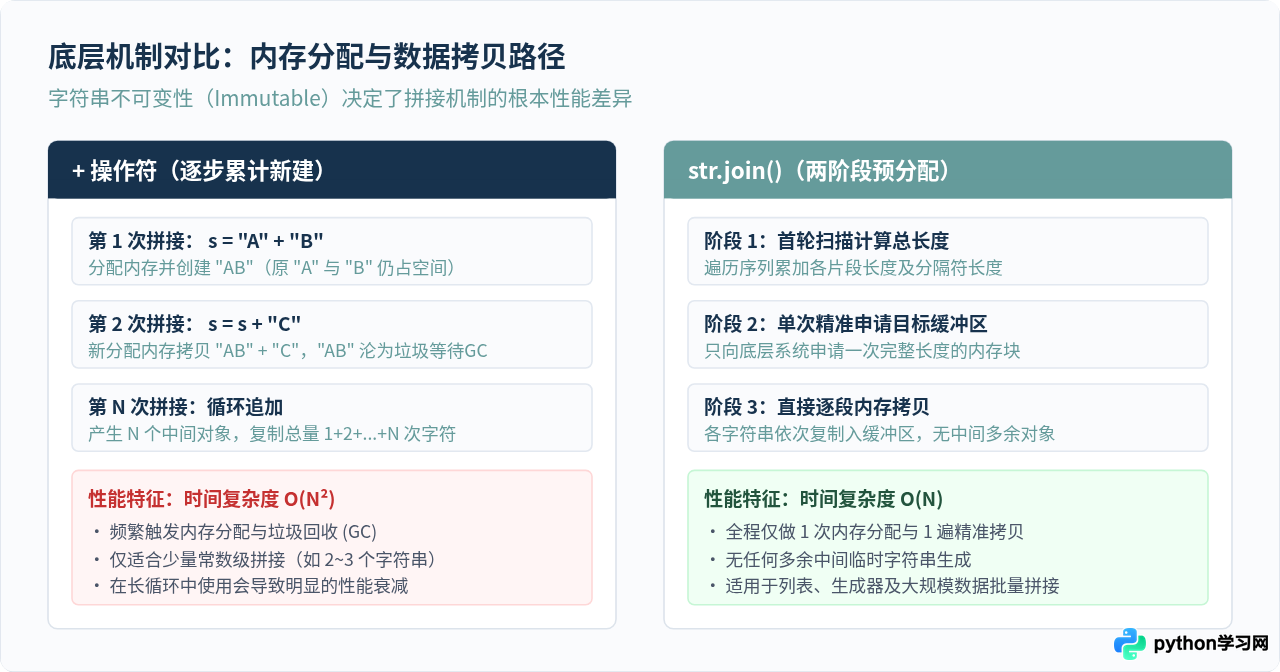
当你执行 s = s + new_char 时,Python 解释器无法直接在原字符串的末尾追加数据,而是必须经历以下步骤:
- 向操作系统申请一块全新的内存空间,大小等于两个旧字符串长度之和;
- 将原字符串的内容完整拷贝到新空间前半部分;
- 将新字符串的内容拷贝到新空间后半部分;
- 更新变量指针指向新内存地址,原旧字符串沦为无引用对象,等待垃圾回收(GC)。
如果在一个包含 N 个元素的循环中反复使用 + 累加,每次循环都需要重复申请内存和拷贝前缀,总共复制的数据量为 1 + 2 + ... + N,导致计算时间呈二次方增长(O(N²))。
二、str.join() 的用法与规范操作步骤
为了解决多段字符串拼接时的性能瓶颈,Python 提供了专用的字符串方法 str.join(iterable)。与许多初学者的直觉不同,join 方法是由连接分隔符字符串调用的,参数则是包含各个字符串片段的可迭代对象(如列表、元组、集合或生成器)。
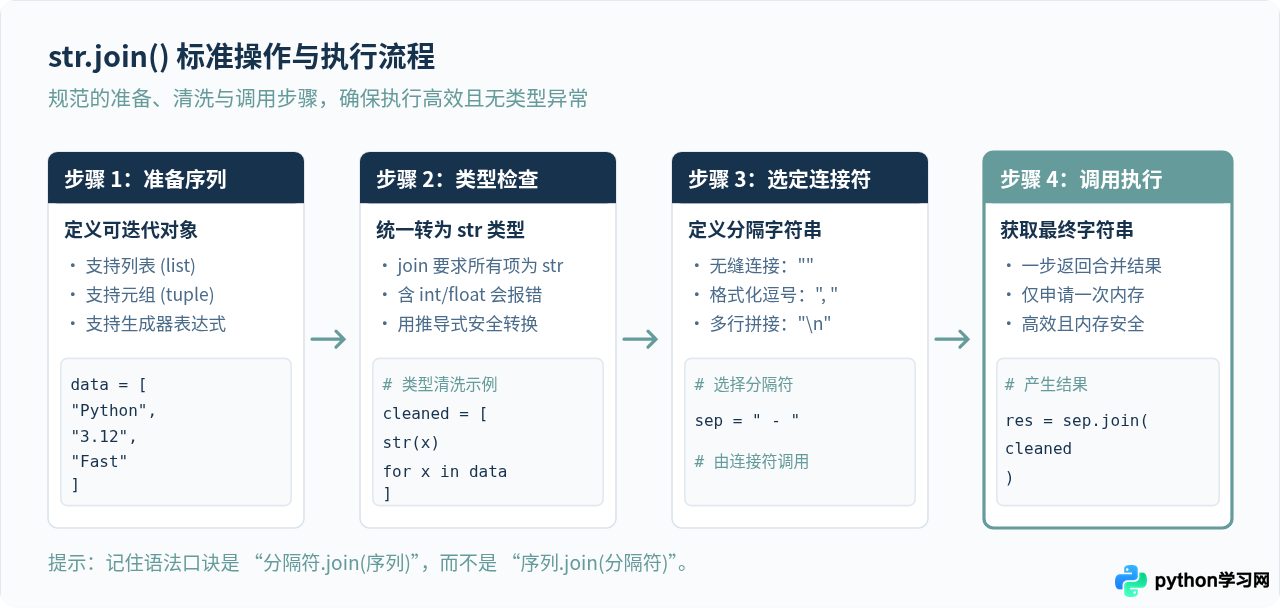
标准使用步骤
- 准备待拼接的数据序列:将需要连接的字符串存入列表、元组等序列结构中。
- 确保所有元素均为字符串类型:
join严格要求所有元素均为str。如果有数字或其他对象,需先使用推导式或map(str, ...)统一转换。 - 选定连接符:如果是无缝拼接,使用空字符串
"";如果需要逗号、空格或换行分隔,分别声明为","、" "或"\n"。 - 执行 join 调用:通过
separator.join(data)获得最终合成的字符串。
# 完整操作示例
tags = ["python", "string", "join", "performance"]

# 步骤 1 & 3 & 4: 使用逗号加空格分隔
csv_text = ", ".join(tags)
print(csv_text)  # 输出: python, string, join, performance

# 无缝合并列表中的字符串
compact_text = "".join(tags)
print(compact_text)  # 输出: pythonstringjoinperformance

# 步骤 2: 序列中含有非字符串类型时的安全处理
mixed_data = ["User", 1001, "Role", "Admin", 2026]
# safe_text = ",".join(mixed_data)  # 直接调用会引发 TypeError
safe_text = "-".join(str(item) for item in mixed_data)
print(safe_text) # 输出: User-1001-Role-Admin-2026None、整数或浮点数,直接调用 "".join([1, 2, 3]) 会抛出 TypeError: sequence item 0: expected str instance, int found。在调用前务必保证所有项均已被格式化为字符串。
三、核心差异对比:为什么 join 效率更高?
从 CPython 的底层 C 源码实现来看,str.join() 采用了高效的“两阶段算法”:
- 第一阶段(预计算长度):先遍历一次传入的序列,累加计算所有子字符串的总长度,并加上所需的分隔符总长度。
- 第二阶段(单次内存分配与填充):直接向操作系统申请一块正好能够容纳最终结果的内存缓冲区,然后遍历序列将各个字符串依次拷贝入对应偏移位置。
相比于 + 操作符反复创建丢弃临时对象,join 将整个过程压缩为一次内存分配,因此执行时间与待拼接字符的总数保持完美的线性关系 O(N)。
四、工程选型与实际场景最佳实践
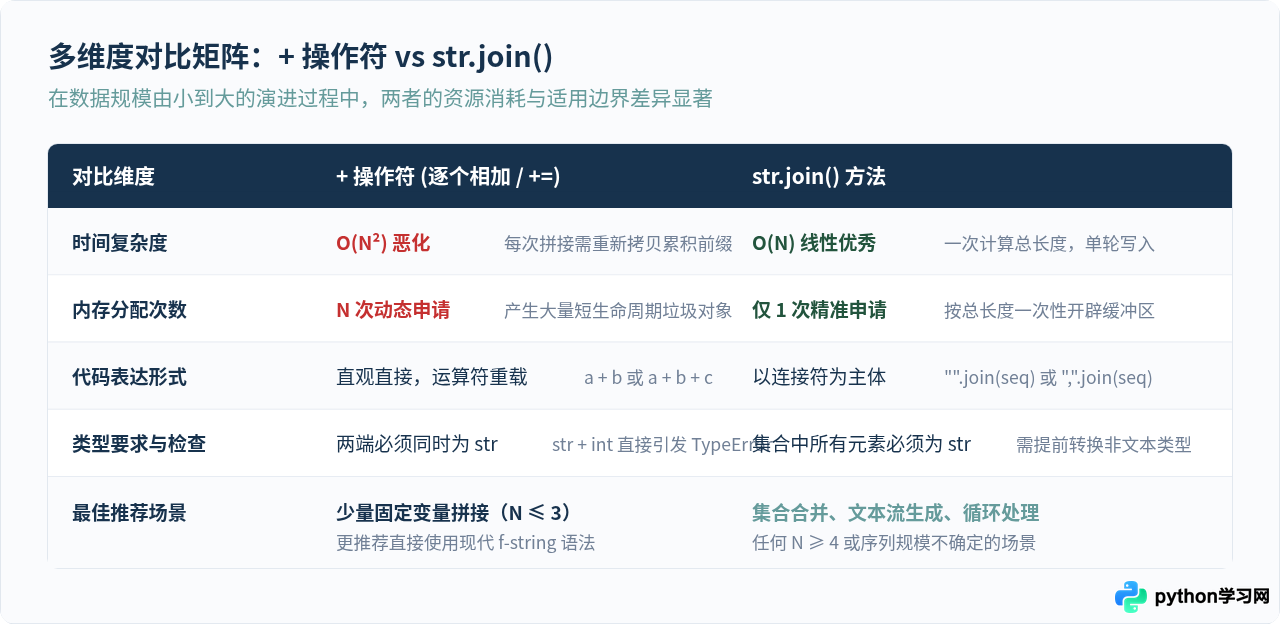
在日常实际开发中,开发者应当根据待拼接字符串的数量规模和数据组织形式做出合理的技术选型:
场景 1:2 至 3 个明确变量拼接
如果是拼接路径、姓名、简单前缀后缀等少量已知变量,使用 + 操作符或者现代 Python 推荐的 f-string 是最佳选择。此时数据规模极小,单次内存分配的差异几乎无法感知,代码的可读性和编写流畅度更重要:
# 少量变量推荐写法语义清晰
user_id = 42
endpoint = "/api/v1/users/" + str(user_id)  # 或使用 f-string: f"/api/v1/users/{user_id}"
场景 2:循环构造动态字符串
这是最容易产生性能事故的代码写法。很多开发者习惯在循环体中写 text += chunk:
# ❌ 错误示范:时间复杂度 O(N²),循环次数多时严重卡顿
result = ""
for line in large_log_stream:
    result += line.strip() + "\n"

# ✅ 正确做法:收集到列表中,最后单次 join,时间复杂度 O(N)
buffer = []
for line in large_log_stream:
    buffer.append(line.strip())
result = "\n".join(buffer)
场景 3:生成器与流式数据处理
str.join() 支持接收生成器表达式。这意味着在处理大文件或海量数据时,甚至不需要一次性在内存中构建庞大的列表,直接借助生成器即可实现边计算边连接:
# 借助生成器节省中间列表的内存占用
numbers_text = ",".join(str(i) for i in range(100000) if i % 2 == 0)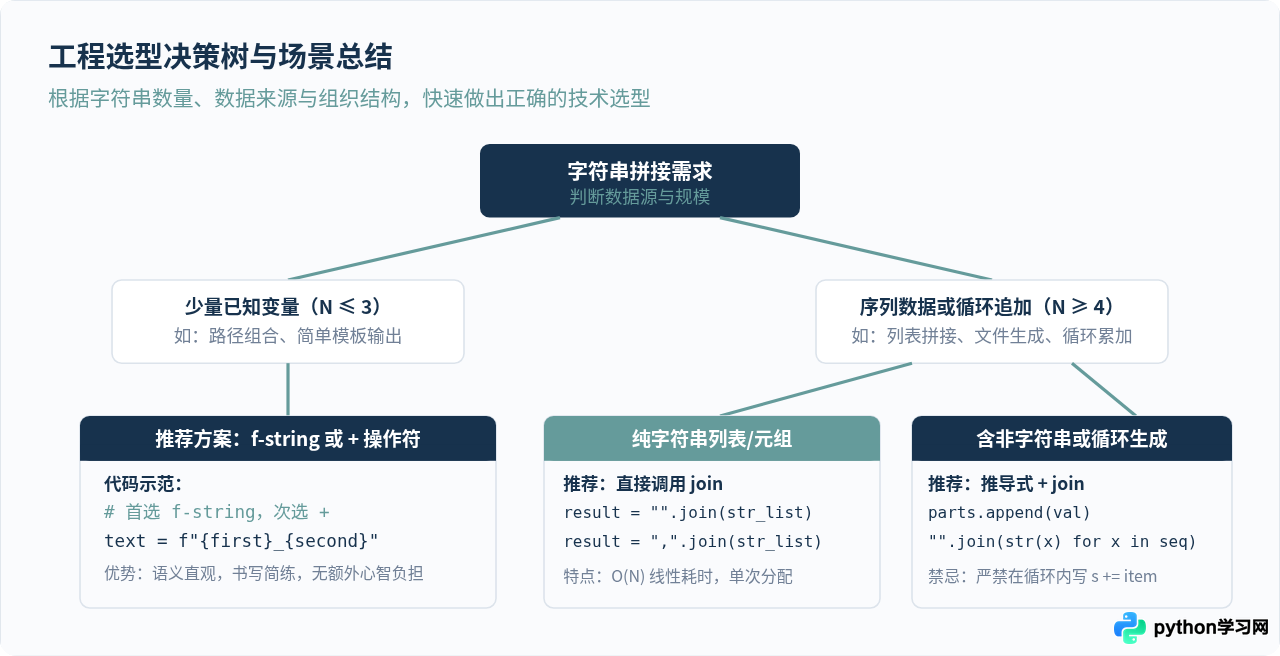
五、总结
理解 str.join() 与 + 操作符的区别,本质上是对 Python 字符串底层不可变性及内存管理机制的理解:
+操作符直观直接,适合 2~3 个明确变量的简单拼接,但在集合拼接或循环追加中会产生 O(N²) 的时间和内存开销;str.join()采用两阶段单次预分配机制,确保时间复杂度稳定在 O(N),是处理批量数据、数组合并和长文本流的黄金标准;- 在日常开发中,牢记“少量变量选 f-string 或加号,集合拼接与长循环必用 join”的原则,即可写出兼具可读性与高性能的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









