

从算法到部署:人工智能项目中Python的真实能力边界

一、算法研发期:Python 作为“控制面”的高效与幻象
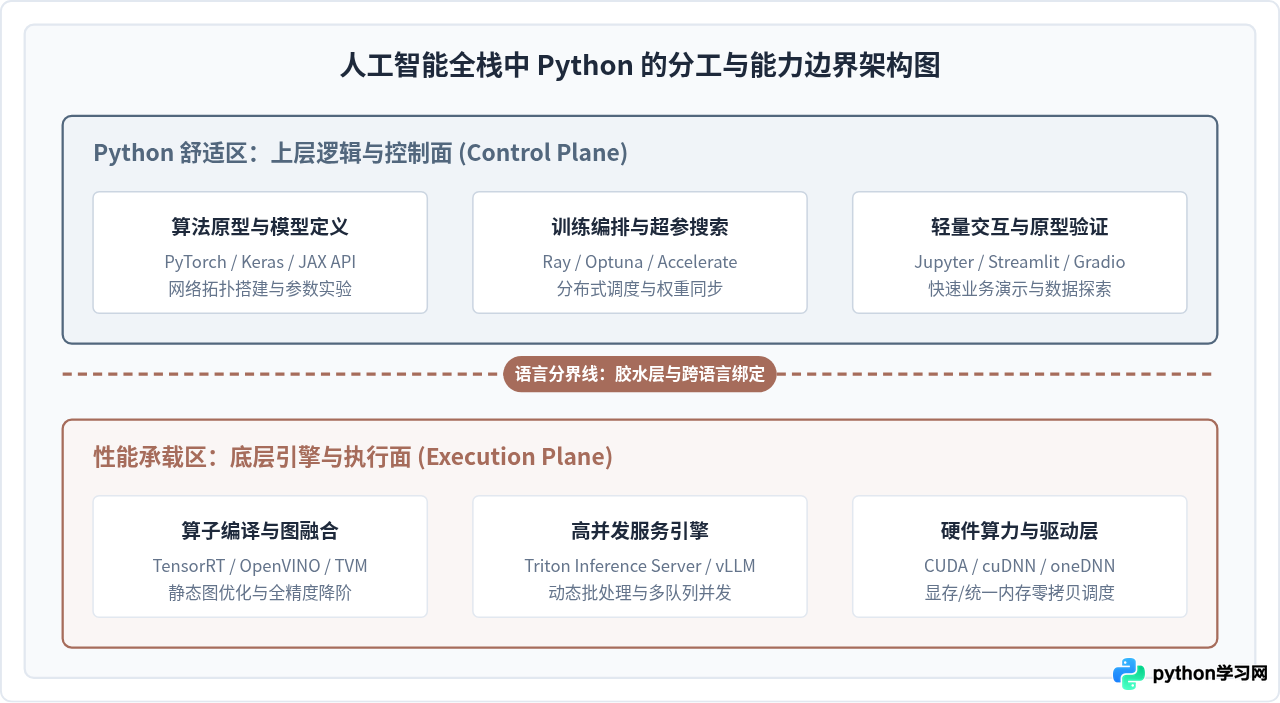
初入人工智能领域的开发者通常会产生一个认知错觉:既然使用 model = ResNet() 和 loss.backward() 几行代码就能训练复杂的深度学习网络,那么 Python 显然具备极为强悍的算力承载能力。但实际上,Python 解释器本身与高性能计算几乎毫无直接关联。
在 PyTorch、TensorFlow 或 JAX 的典型训练循环中,Python 仅仅扮演了“指令调度员”的角色。所有核心的张量运算(如矩阵乘法 GEMM、卷积、层归一化),全部在 C++ 编写的底层库(如 PyTorch 的 ATen 库)中执行,最终由硬件厂商高度优化的底层驱动(如 NVIDIA cuBLAS、cuDNN)分发给 GPU 流式多处理器。Python 的开销之所以在训练阶段被掩盖,是因为单个深度学习算子的计算时间往往远长于 Python 调用该算子的微秒级解释耗时。
然而,这种掩盖在数据预处理和输入流水线中会立即被打破。如果开发者使用原生 Python 循环处理复杂样本,全局解释器锁(GIL)与跨进程数据序列化(IPC)会迅速吃满 CPU 单核,导致价值昂贵的加速芯片处于饥饿等待状态。
二、从实验到工程:模型导出与推理优化的操作步骤
把训练好的模型交付到生产服务器,很多初学者直接将训练脚本封装为 FastAPI 接口:加载 model.pt,接收 HTTP 请求,执行前向推理并返回结果。在单用户小流量测试下这种做法运转顺畅,但一旦进入并发生产环境,往往会导致显存膨胀与响应延迟急剧拉长。
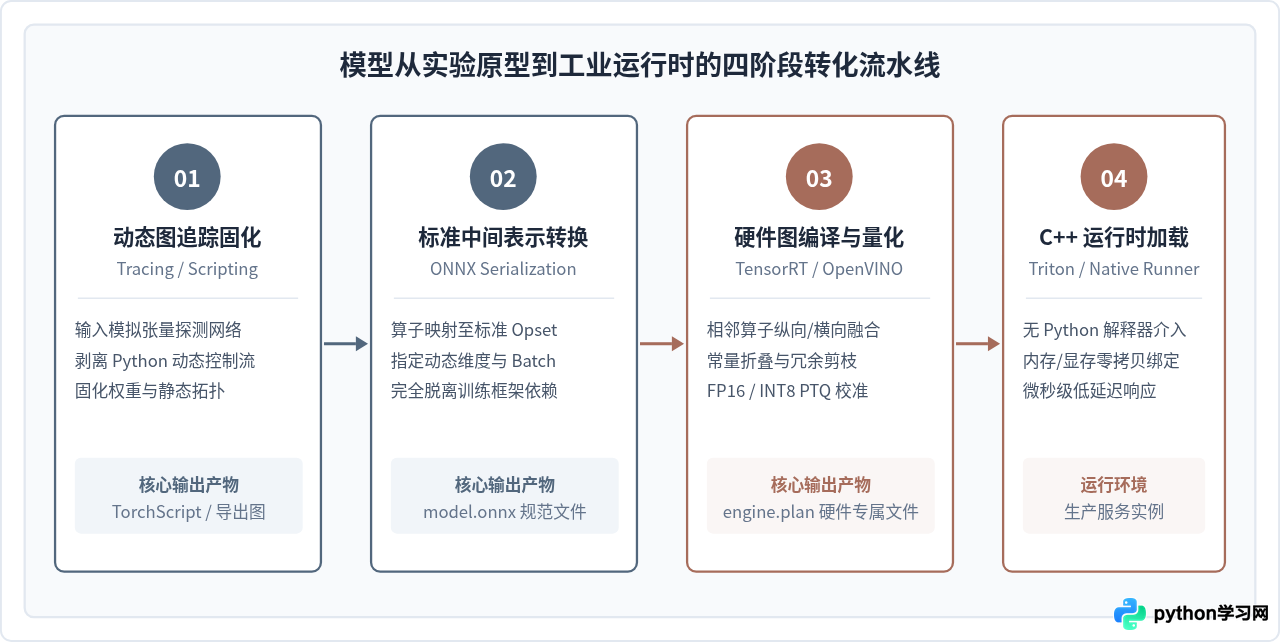
生产化部署的第一步,就是让模型彻底“脱离 Python 运行时”。工业级标准路径包含四个关键步骤:计算图追踪、中间表示导出、硬件编译优化、生产引擎加载。
模型固化与导出的具体代码实现
以下是在 Python 研发阶段将模型平滑移交给底层优化器的标准导出代码示例。通过显式设定动态维度(Dynamic Axes),既保留了批处理与可变长度灵活性,又彻底剥离了 Python 运行时的动态拓扑追踪。
import torch
import torchvision.models as models

# 1. 准备训练好的模型实例并置于评估模式
model = models.resnet50(weights=models.ResNet50_Weights.DEFAULT)
model.eval()

# 2. 构造符合输入规范的探测虚拟张量 (Dummy Input)
dummy_input = torch.randn(1, 3, 224, 224, requires_grad=False)

# 3. 将计算图固化并导出为通用 ONNX 文件
onnx_path = "resnet50_optimized.onnx"
torch.onnx.export(
    model,
    dummy_input,
    onnx_path,
    export_params=True,             # 固化所有权重参数
    opset_version=17,               # 指定标准的算子集版本
    do_constant_folding=True,       # 执行常量折叠优化
    input_names=["input_tensor"],
    output_names=["logits"],
    dynamic_axes={                  # 允许生产环境动态调整 Batch Size
        "input_tensor": {0: "batch_size"},
        "logits": {0: "batch_size"}
    }
)
print(f"模型已成功导出为独立中间表示: {onnx_path}")
完成导出后,该 .onnx 文件便已完全解耦 PyTorch 代码库。部署工程师可以直接使用 C++ API 调用 TensorRT 构建器进行编译,生成特定硬件专用的 .engine 文件,整个服务运行期不再需要 Python 解释器参与。
三、生产部署的真实挑战:Python 运行时的三大物理瓶颈
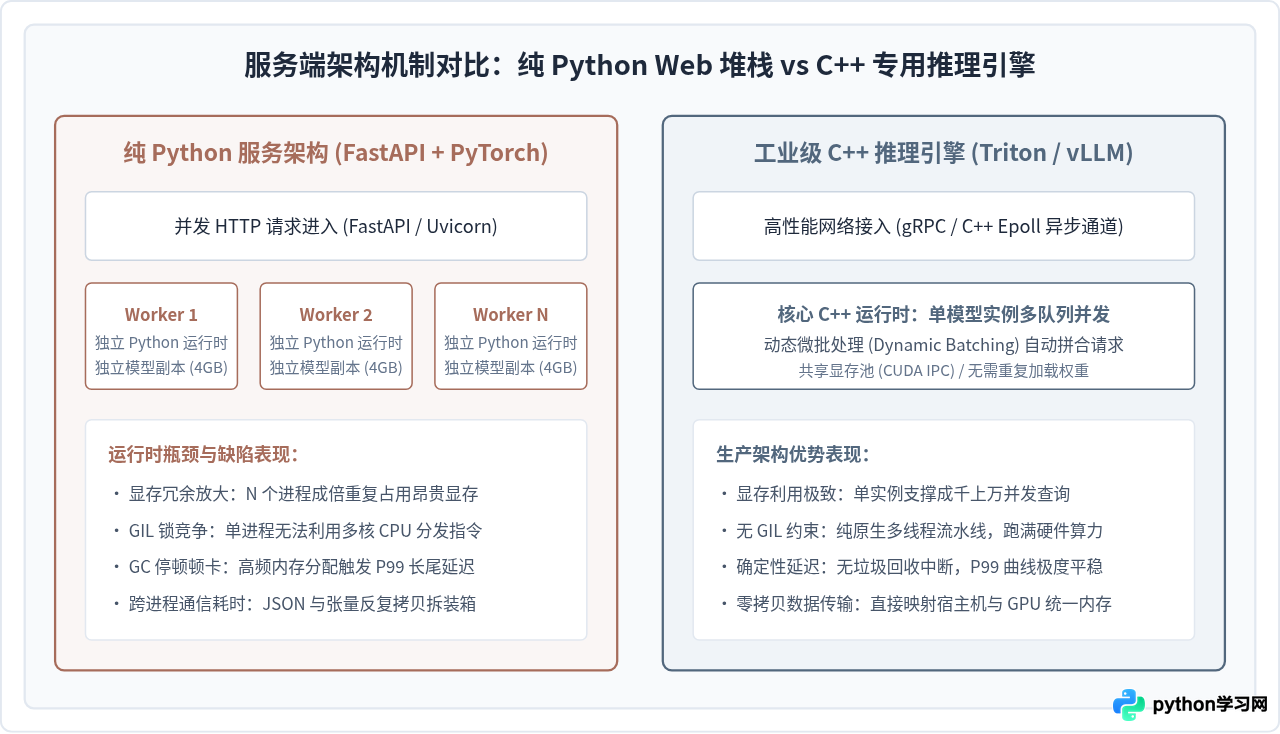
如果在高并发生产环境中仍然坚持使用纯 Python 服务(例如以 FastAPI + Uvicorn + PyTorch 直接驻留显存),系统在流量波峰期将迅速触碰以下三项难以调优的物理瓶颈。
1. GIL 锁与多进程的内存爆炸
由于 Python 全局解释器锁(GIL)的存在,单一进程内的多个线程无法同时利用多核 CPU 执行 Python 字节码。为了支撑多核并发,行业常规做法是开启多个工作进程(Worker)。但在 AI 场景中,每个 Worker 都需要加载独立的框架运行环境和模型上下文。如果模型自身占用 6GB 显存,启动 4 个 Worker 就需要 24GB 显存;即使用户通过操作系统 fork 机制共享只读内存,一旦底层运行时在内部修改缓冲区,写时复制(Copy-on-Write)机制便会导致内存急剧膨胀,频繁触发系统 OOM(Out of Memory)崩溃。
2. 垃圾回收(GC)与不可控的长尾延迟(P99 Jitter)
Python 依赖引用计数与分代标记清除机制进行内存管理。在处理连续的数据请求时,Python 解释器在内存中频繁创建和销毁大量临时字典、列表和对象包装器。当触发分代 GC 回收时,解释器会出现暂态“Stop-the-World”现象。对于要求 SLA 响应时间在 20ms 以内的实时在线推理系统(如自动驾驶感知、搜索排序或语音交互),这类偶发顿卡会直接导致 P99 甚至 P99.9 长尾延迟严重超标。
3. 序列化与进程间通信(IPC)的无谓消耗
在纯 Python Web 架构中,客户端发送的 JSON 载荷必须先由 Python 解析为字典,再转换为 NumPy 数组,最后通过 CFFI 包装转换为底层 C 数组传给张量库。响应返回时,浮点张量又要经过反向的内存拷贝、序列化和 JSON 编码。在高吞吐场景下,超过 40% 的 CPU 周期消耗在 Python 对象的装箱与拆箱中,而非用于模型推理本身。
四、工业级落地的技术栈分工与选型决策
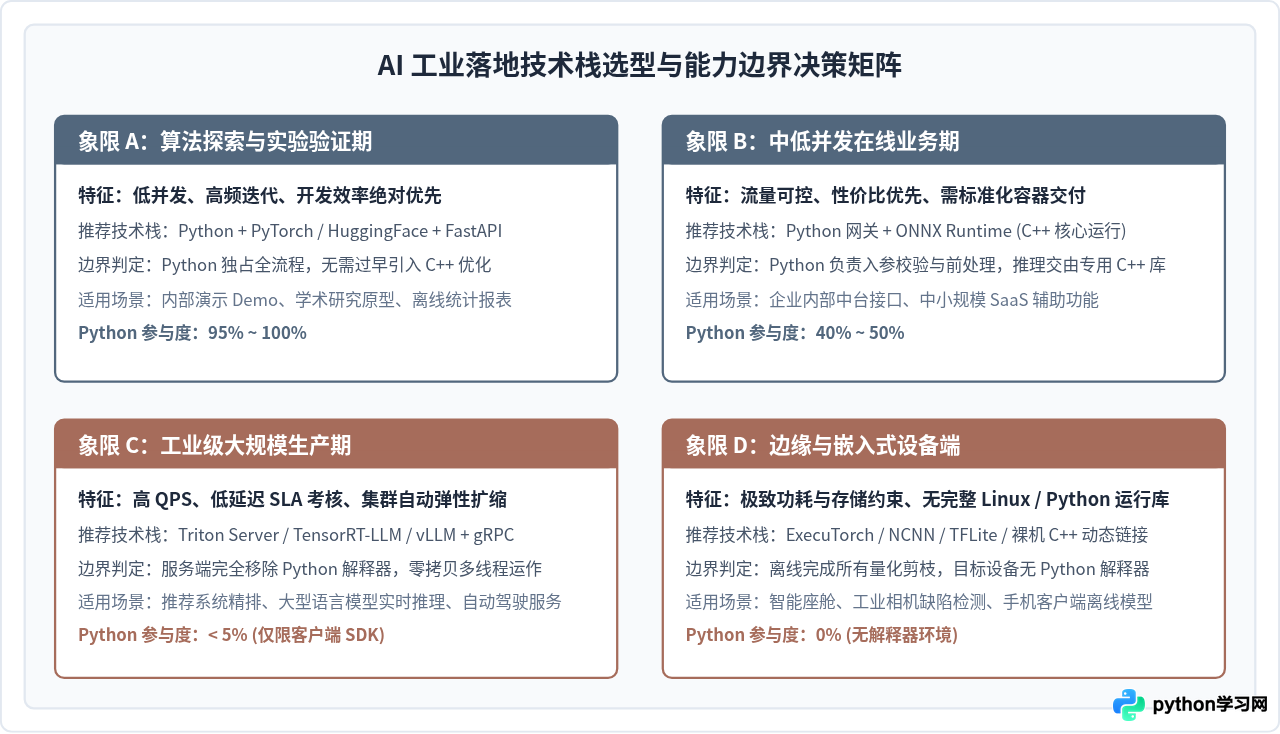
承认 Python 的能力边界,并不意味着要全面抛弃 Python。恰恰相反,当今成熟的工业界最佳实践是构建“Python 负责表达逻辑,C++/Rust 负责执行运算”的双层协同体系。团队不应在整个生命周期中执着于单一技术栈,而应根据项目的并发吞吐需求、延迟容忍度及部署载体选择最适配的工程方案。
| 项目阶段与场景 | 核心诉求 | 推荐架构分工 | Python 的角色与定位 |
|---|---|---|---|
| 阶段 1:原型探索与离线验证 | 极速验证、灵活性、低维护成本 | Python (PyTorch + FastAPI) | 全流程主导:负责数据流、模型运算与简易 API 接口 |
| 阶段 2:轻量在线服务(低中并发) | 标准化、平民化硬件成本 | Python Web 网关 + ONNX Runtime (C++ 核心) | 胶水层网关:负责校验入参及调用 C++ 推理库 |
| 阶段 3:工业高并发生产(严苛 SLA) | 万级 QPS、微秒/毫秒级低延迟 | Go/Java 业务微服务 + Triton/vLLM (纯 C++) | 彻底退出服务链路:仅用于离线运维与客户端 SDK |
| 阶段 4:移动端与嵌入式设备 | 极低内存、无外部解释器依赖 | ExecuTorch / NCNN / TensorRT 静态库 | 完全零参与:模型固化后直接编译为二进制动态库 |
五、工程避坑指南:识别 Python 落地中的典型反模式
许多工程师习惯在 Python FastAPI 路由函数中直接使用原生 Python 循环遍历数千条文本分词或高分辨率图像缩放。这类纯 CPU 密集运算会牢牢占据事件循环单线程,使整个 Web 服务的异步协程彻底挂起,其他连接请求全部发生超时。正确的做法是将前处理放入 C++ 编写的算子插件中,或者通过独立的任务队列由后台专用 Worker 处理。
为了规避 GIL,部分团队采用 Python multiprocessing.Pool 来分发推理请求。然而,子进程之间的张量传递需要经过基于套接字或管道的 pickle 序列化与反序列化,其耗时甚至可能超过模型推理本身。必须并发处理张量时,应采用操作系统的共享内存或专用跨进程 CUDA IPC 句柄,避免使用 Python 原生的进程间通信抽象。
PyTorch 动态图允许在前向传播中书写任意复杂的 Python 语法(如 if x.sum() > 0: 动态分支)。但在模型编译期,这些动态逻辑无法直接映射为静态张量图。如果在算法设计初期缺乏边界意识,随意使用 Python 原生动态特技,会导致后续导出 ONNX 或 TensorRT 时遭遇大量“Unsupported Operator”报错,被迫在部署阶段重构网络架构。
总结而言,Python 在人工智能生态中的核心价值在于“极低的原型试错成本与强大的算法表达力”,而非“高吞吐低延迟的线上并发引擎”。清晰界定 Python 的工作界面,在算法验证完成后及时启动计算图固化与算子下沉,将推理执行移交给专用的编译工具链与 C++ 运行时,才是确保人工智能项目从实验室算法平稳迈向工业级生产的根本保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









