

Python数据库框架性能优化:怎么解决N+1查询与连接池配置问题

在基于 Python 的 Web 服务与后端应用中,数据库往往是系统并发与响应时延的最高敏感区。大多数性能急剧劣化的线上事故,并不源于底层存储引擎的物理瓶颈,而是源自 ORM(对象关系映射)层面的惰性加载滥用,以及对数据库连接池生命周期的粗放配置。解决这两个问题有一条清晰的技术路径:通过明确的主动抓取策略(如 SQL JOIN 或批量 IN 预加载)消除循环外键查询,同时依据物理算力与工作进程并发模型精确量化连接池的容量、回收周期与健康探测参数。
一、N+1查询的成因与执行特征剖析
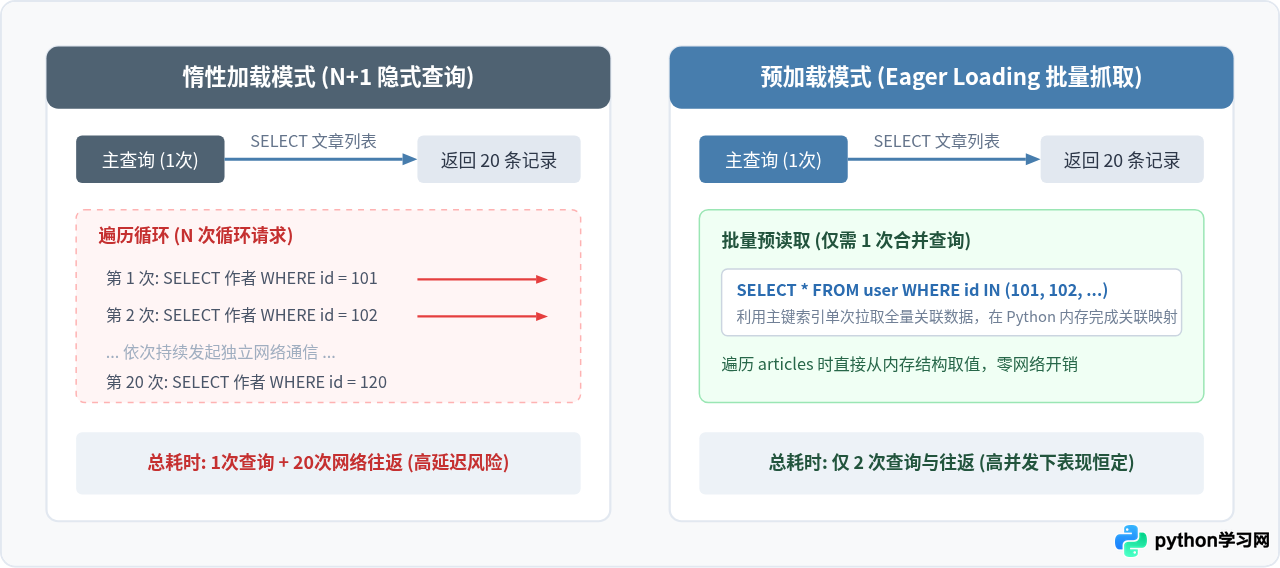
“N+1 查询”是使用 SQLAlchemy、Django ORM 或 Peewee 等数据映射工具时最为高发的隐性损耗。当系统需要查询主表数据及其关联的从表数据时,如果使用了默认的惰性加载(Lazy Loading),框架会先执行 1 条 SQL 获取主表集合(包含 N 条主记录),随后在业务代码遍历集合读取关联属性时,每一次访问都静默触发一条独立的外键查询,导致总共执行了 1 + N 次数据库 I/O 交互。
以一个经典的博客系统为例,获取最新的 20 篇随笔及其作者信息:
# 典型反模式代码(SQLAlchemy 2.0 风格)
from sqlalchemy import select
from models import Article

stmt = select(Article).limit(20)
articles = session.scalars(stmt).all()  # 执行 1 次查询:SELECT * FROM article LIMIT 20

for item in articles:
    # 每次访问 .author 属性,均产生独立查询:
    # SELECT * FROM user WHERE id = <item.author_id>
    print(item.title, item.author.username)  # 静默触发 20 次从表查询
虽然数据库处理单条点查索引 SQL 的时间通常不足 1 毫秒,但在生产分布式架构中,网络往返时延(RTT)通常在 0.5 到 3 毫秒之间。20 次网络握手和协议包传输会让总体处理时间线性放大数十倍。如果列表分页增大到 100,接口响应时间将直接从几毫秒恶化至半秒以上,极易引发请求堆积。
二、解决N+1查询的核心加载策略与实践
消除 N+1 查询的核心手段是预先加载(Eager Loading)。主流框架提供了两种主流方案:基于 SQL 连接的关联预载(Joined Load)以及基于集合查询的预载(Select IN / Prefetch)。两者的内存结构、网络负载与 SQL 表达存在本质不同。
1. 策略对比:连接查询与批量拆分查询
- Joined Eager Loading(联表加载):通过生成
LEFT OUTER JOIN或INNER JOIN将多张表合并至单条 SQL 中返回。优势是只需向数据库发送 1 次网络请求;劣势在于如果抓取“一对多”关系,笛卡尔积会导致从表数据乘数放大,产生大量重复的主表列宽载荷。 - Select IN / Prefetch Loading(拆分集合加载):先执行主表查询获得 ID 集合,随后自动聚合出
WHERE foreign_key IN (...)执行第 2 条查询,最后在 Python 运行时内部组装映射。优势是不存在笛卡尔积膨胀,对大文本或一对多关系极其友好;劣势是固定产生 2 次网络请求。
2. SQLAlchemy 2.0 中的标准解法
在 SQLAlchemy 2.0 中,推荐在构建 select() 语句时显式声明加载选项 options(),避免依赖实体模型定义的静态配置:
from sqlalchemy import select
from sqlalchemy.orm import joinedload, selectinload
from models import Article, User, Comment

# 场景 A: 多对一 / 一对一 推荐使用 joinedload(生成 JOIN,一次性查回)
stmt_article = (
    select(Article)
    .options(joinedload(Article.author))
    .limit(20)
)
articles = session.scalars(stmt_article).unique().all()

# 场景 B: 一对多 / 多对多 强烈推荐使用 selectinload(生成 IN 查询,规避数据冗余)
stmt_with_comments = (
    select(Article)
    .options(selectinload(Article.comments).joinedload(Comment.user))
    .limit(20)
)
articles_with_comments = session.scalars(stmt_with_comments).all()在使用 joinedload() 加载集合关系时,SQLAlchemy 接收到底层游标返回的扁平多行数据后,必须调用 scalars().unique().all()。unique() 负责在内存中按照主键对主实体进行去重聚合,避免同一个实体对象被实例化多次。
3. Django ORM 中的对应解法
在 Django 中,开发者需根据外键关系类型分别选择 select_related 与 prefetch_related:
# 1. ForeignKey / OneToOneField 使用 select_related (底层使用 SQL JOIN)
articles = Article.objects.select_related('author').filter(status='published')[:20]

# 2. ManyToManyField / 反向外键关系 使用 prefetch_related (底层使用 IN 查询)
articles = Article.objects.prefetch_related('comments', 'tags').filter(status='published')[:20]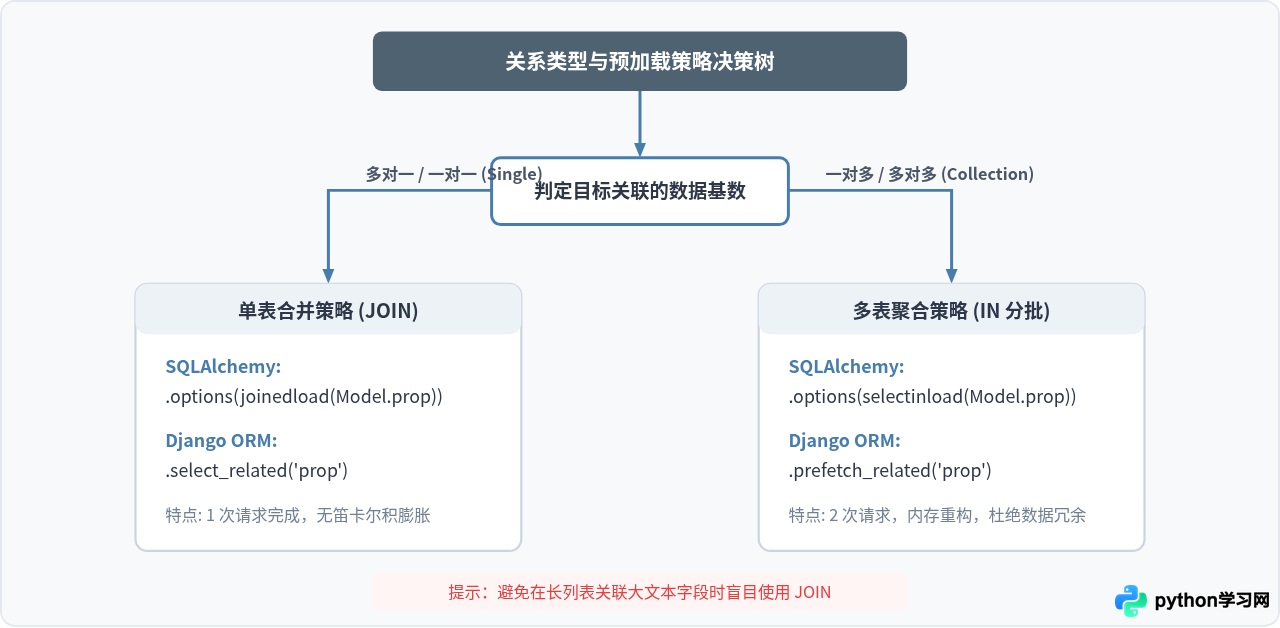
三、数据库连接池工作机制与核心参数推演
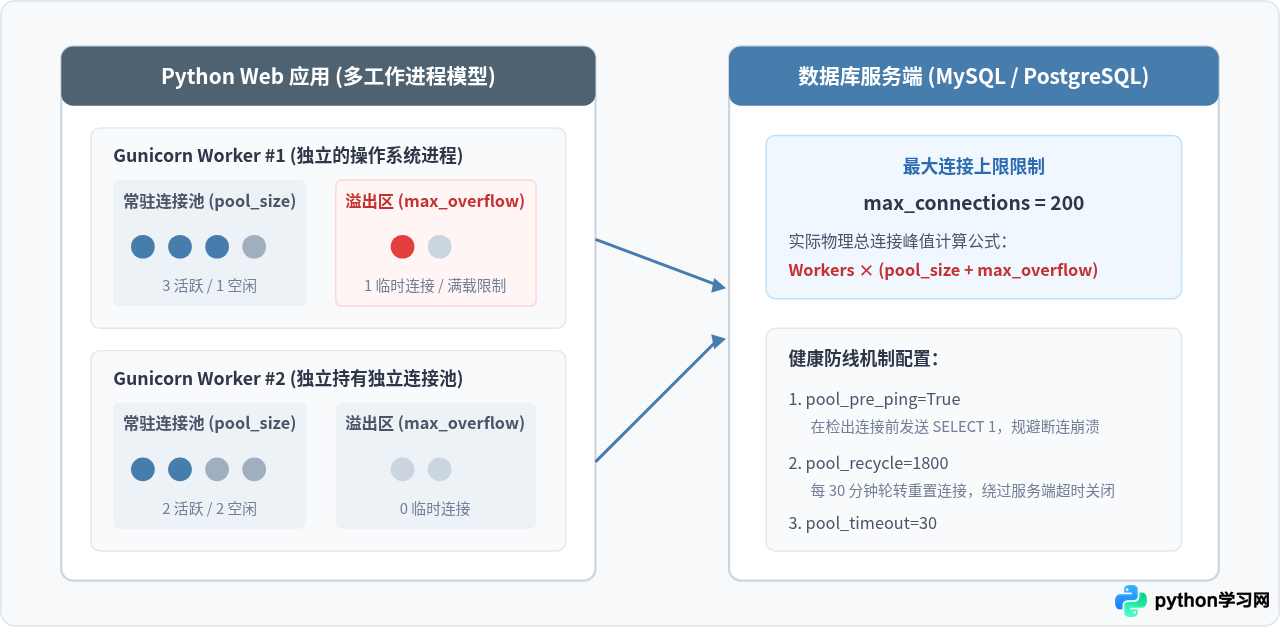
消除了上层的冗余查询之后,数据库性能的瓶颈往往迅速下沉至 TCP 握手与连接管理层面。在 Web 服务中,建立一条物理数据库连接需要经历 TCP 三次握手、SSL/TLS 密钥交换、账户鉴权认证、会话环境初始化等多个步骤,单次耗时通常在 10 至 50 毫秒之间。连接池通过常驻一组复用的物理连接,将请求生命周期内的连接开销降至亚毫秒级。
1. 连接池核心配置参数详解
| 参数名称 (SQLAlchemy) | 典型推荐值 | 机制解释与生产影响 |
|---|---|---|
pool_size |
5 ~ 20 | 稳态常驻连接数。连接池空闲时保持的持久连接上限。 |
max_overflow |
10 ~ 20 | 突发溢出连接数。瞬时并发激增时允许额外创建的连接上限,用毕立即销毁。 |
pool_timeout |
30 (秒) | 借出连接的最大等待时间。池满且无可用连接时阻塞超时,超时后抛出 TimeoutError。 |
pool_recycle |
1800 ~ 3600 (秒) | 连接强制回收周期。防止连接被 MySQL wait_timeout 或防火墙静默断开。 |
pool_pre_ping |
True | 乐观心跳探测。从池中借出连接前执行 SELECT 1,检测失效则自动重连。 |
2. 多进程 Web 架构下的连接暴增陷阱
Python Web 部署通常采用 Gunicorn 或 uWSGI 多进程模式(Prefork)。每个 Worker 都是独立的操作系统进程,绝不跨进程共享同一个 Python 对象。这意味着:如果配置了 workers = 8,且每个 Engine 的配置为 pool_size = 20, max_overflow = 10,应用集群在峰值期会建立的连接上限为:
峰值连接数 = 8 × (20 + 10) = 240 个并发连接
如果数据库主机的 max_connections 被设置为 150,系统将在突发流量瞬间遭遇大量 Too many connections 报错,引发连锁雪崩。因此,生产环境的 pool_size 通常应当控制在单 Worker 5~10 之间,配合较小的 max_overflow。
在使用多进程模型时,严禁在主进程(Master Process)完成 create_engine() 初始化后再 Fork 子进程。主进程打开的底层 TCP Socket 文件描述符会被子进程直接继承,多个 Worker 会同时向同一个 Socket 读写报文,引发极为隐蔽且难以复现的协议混乱报错(如 SSL SYSCALL error 或数据交叉包污染)。
四、生产级引擎配置模板与监控验证
构建高健壮性的数据库交互层,需要在初始化阶段规范连接参数,并在开发测试阶段对查询总数施加严格的校验断言。
1. SQLAlchemy 生产引擎标准配置模板
from sqlalchemy import create_engine
from sqlalchemy.pool import QueuePool

DATABASE_URL = "postgresql+psycopg2://user:password@10.0.0.5:5432/production_db"

engine = create_engine(
    DATABASE_URL,
    # 使用稳态队列连接池
    poolclass=QueuePool,
    # 稳态保持的连接数,多进程环境下建议保持适度紧凑
    pool_size=10,
    # 允许突发峰值借用的额外连接数
    max_overflow=5,
    # 连接池耗尽时的等待超时,避免工作协程/线程无限挂起
    pool_timeout=20,
    # 强制在 1800 秒(30分钟)后刷新连接,解决网络中间层与数据库 wait_timeout 掐断问题
    pool_recycle=1800,
    # 启用断线重连悲观/乐观检测,归还与借出前探活
    pool_pre_ping=True,
    # 生产环境关闭原始 SQL 打印,避免日志 I/O 阻塞
    echo=False
)
2. 如何在自动化测试中阻断 N+1 缺陷上线
依靠代码走查难以完全根绝 N+1 漏洞,最佳实践是在单元测试或集成测试中,使用查询计数器断言单次请求的 SQL 触发总数:
import pytest
from sqlalchemy import event
from contextlib import contextmanager

@contextmanager
def assert_max_queries(engine, max_allowed):
    queries = []
    def before_cursor_execute(conn, cursor, statement, parameters, context, executemany):
        queries.append(statement)

    event.listen(engine, "before_cursor_execute", before_cursor_execute)
    try:
        yield
    finally:
        event.remove(engine, "before_cursor_execute", before_cursor_execute)
        assert len(queries) <= max_allowed, (
            f"检测到潜在 N+1 漏洞!预期至多 {max_allowed} 次查询,实际触发 {len(queries)} 次"
        )

# 单元测试用例
def test_article_list_api_queries(client, test_engine):
    # 无论数据库中有 10 篇还是 100 篇文章,查询次数必须保持恒定(例如不超过 2 次)
    with assert_max_queries(test_engine, max_allowed=2):
        response = client.get("/api/articles?limit=50")
        assert response.status_code == 200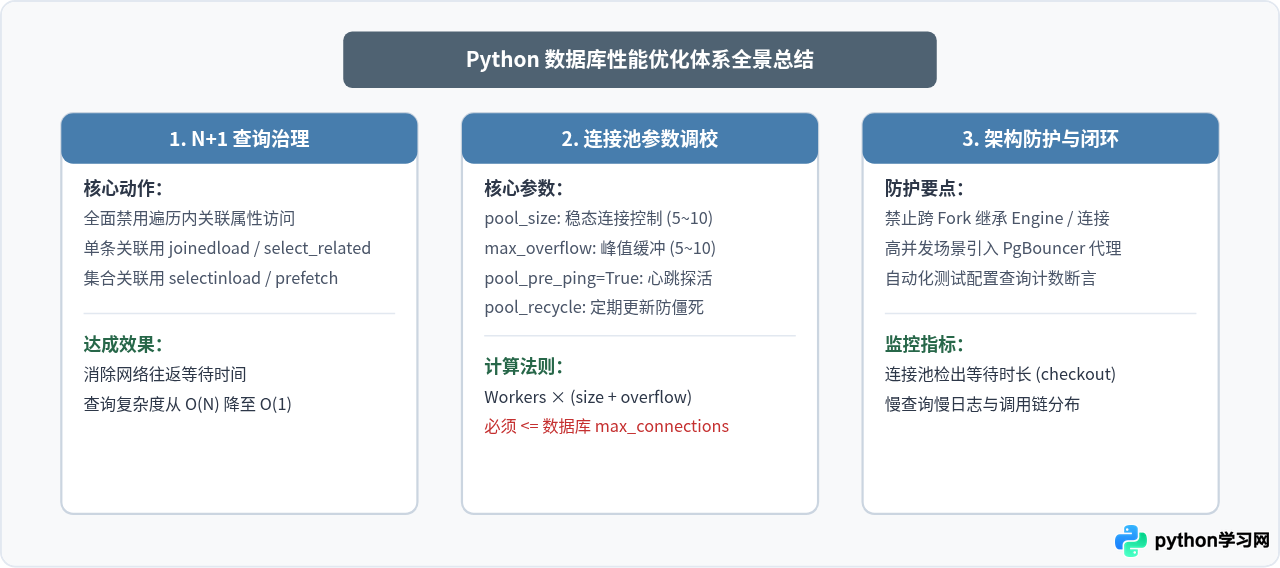
五、常见问题与诊断备忘
- 使用
joinedload后为什么分页limit/offset行为反常?
在一对多关系中使用joinedload时,LIMIT 作用于 JOIN 展开后的多行结果集,而非主表实体记录数。SQLAlchemy 会因此发出警告并在内存中进行后置截断过滤,带来沉重的全量数据拉取负荷。处理一对多或需要物理分页时,必须使用selectinload代替joinedload。 - 应用空闲一段时间后首次请求偶发
MySQL server has gone away?
这是由于中间代理、NAT 防火墙或 MySQL 自身的wait_timeout杀死了闲置 TCP 连接,而客户端连接池尚不知情。配置pool_pre_ping=True并将pool_recycle调低至 1800 秒以内即可稳妥根除此现象。 - 微服务高伸缩容器环境下数据库连接被耗尽如何解决?
当 Python 容器横向扩容至几十个 Pod、总 Worker 达数百个时,应用端直连连接池必然击穿数据库并发阈值。此时应将客户端pool_size压缩至极小(如 2~3),或在数据库前置部署专用连接池代理(如 PostgreSQL 的 PgBouncer 或 MySQL 的 ProxySQL),由代理层维护与数据库的长连接,实现真正的事务级/语句级连接多路复用。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









