

Python读取旧版.xls和新版.xlsx文件的代码适配
针对Python处理旧版.xls与新版.xlsx格式差异导致的引擎报错问题,提供基于文件后缀与魔数探测的自动适配方案,并给出Pandas和原生库的完整代码实现。
在 Python 数据处理工作中,旧版 .xls(Excel 97-2003 二进制格式)与新版 .xlsx(基于 OpenXML 的压缩包格式)经常同时存在。由于这两种格式的底层存储机制完全不同,现代 Python 生态已不再由单一库统一处理:xlrd 自 2.0.0 版本起移除了对 .xlsx 的支持并仅保留 .xls 读取功能,而 openpyxl 则专门解析 .xlsx 且完全无法读取 .xls。解决这一兼容性问题的核心路径是:建立统一的读取调度层,通过文件扩展名与二进制文件头标识(Magic Number)自动判定物理格式,并分发给对应的底层引擎(xlrd 或 openpyxl)。
一、底层格式差异与解析引擎映射
要编写稳定兼容的代码,首先需要明确 .xls 与 .xlsx 之间的技术代差与底层机制。
- 旧版
.xls文件:采用微软的 OLE2 复合文档二进制格式(BIFF8)。其内部由连续的二进制流记录构成,单表最大限制为 65,536 行与 256 列。Python 中主要使用xlrd库解析。需要注意,生产环境必须使用xlrd>=2.0.1,该版本已彻底废弃非.xls格式的解析逻辑。 - 新版
.xlsx文件:采用基于 XML 的开放打包约定(OpenXML)。本质是一个标准的 ZIP 压缩包,解压后包含工作簿结构、工作表数据、样式表等多份 XML 文件,单表上限提升至 1,048,576 行与 16,384 列。Python 中推荐使用openpyxl库进行解析。
运行适配代码前,需确保运行环境已安装基础依赖:
pip install pandas openpyxl "xlrd>=2.0.1"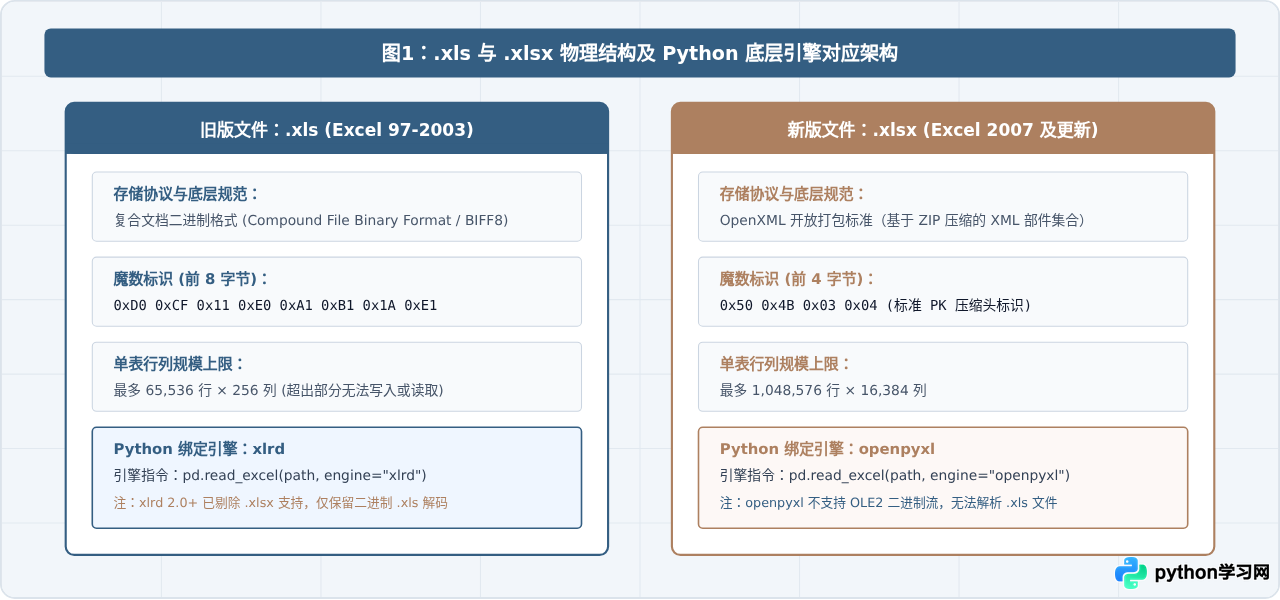
二、基于 Pandas 的双引擎自动调度适配
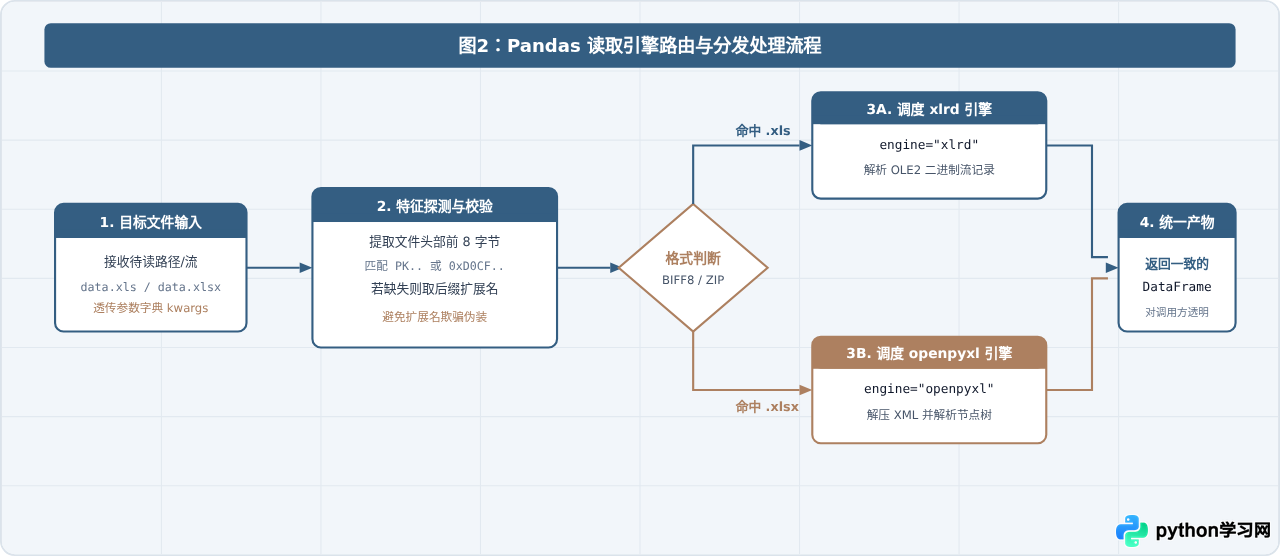
在数据分析场景中,通常优先使用 pandas.read_excel()。但若直接调用 pd.read_excel(file_path) 而不显式传参,Pandas 会尝试根据后缀推断引擎。当文件后缀大小写不规范、临时文件缺失后缀或环境配置变动时,容易引发 ValueError: Your version of xlrd only supports .xls files 或缺失依赖的报错。
健壮的适配做法是编写包装函数:先基于文件扩展名快速匹配,同时结合文件头部二进制签名完成防御性二次验证,动态指定 engine 参数。以下为完整可执行代码:
import os
import pandas as pd
from typing import Union, BinaryIO

def detect_excel_engine(file_source: Union[str, BinaryIO]) -> str:
    """
    根据文件后缀和二进制魔数检测适用的 Pandas 读取引擎
    返回: 'xlrd' 或 'openpyxl'
    """
    xls_sig = b"\xd0\xcf\x11\xe0\xa1\xb1\x1a\xe1"
    xlsx_sig = b"PK\x03\x04"

    # 1. 尝试从文件头魔数进行物理特征验证
    try:
        if isinstance(file_source, str) and os.path.exists(file_source):
            with open(file_source, "rb") as f:
                header = f.read(8)
        elif hasattr(file_source, "read") and hasattr(file_source, "seek"):
            current_pos = file_source.tell()
            header = file_source.read(8)
            file_source.seek(current_pos)
        else:
            header = b""

        if header.startswith(xlsx_sig):
            return "openpyxl"
        if header.startswith(xls_sig):
            return "xlrd"
    except Exception:
        pass

    # 2. 魔数检测未命中时,基于文件扩展名兜底判定
    if isinstance(file_source, str):
        ext = os.path.splitext(file_source)[1].lower()
        if ext == ".xls":
            return "xlrd"
        if ext in (".xlsx", ".xlsm", ".xltx"):
            return "openpyxl"

    # 3. 默认兜底使用 openpyxl
    return "openpyxl"

def read_excel_adaptive(file_path: str, **kwargs) -> pd.DataFrame:
    """
    自适应读取旧版 .xls 与新版 .xlsx 文件
    自动绑定对应引擎,透传 sheet_name、usecols 等常用 Pandas 参数
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"未找到目标文件: {file_path}")

    selected_engine = detect_excel_engine(file_path)

    # 允许外部调用者显式覆盖 engine,未提供时采用自适应结果
    kwargs.setdefault("engine", selected_engine)

    return pd.read_excel(file_path, **kwargs)

# 调用示例:
# df_old = read_excel_adaptive("orders_2002.xls", sheet_name=0)
# df_new = read_excel_adaptive("orders_2024.xlsx", sheet_name=0)
三、无 Pandas 依赖的原生适配器设计
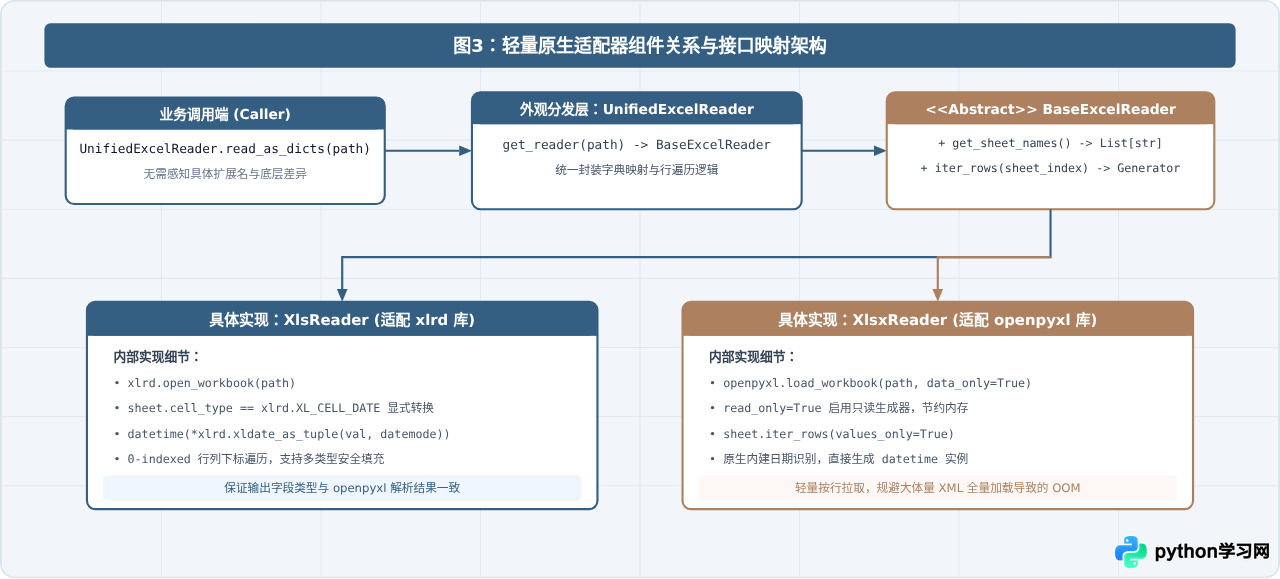
在部分生产服务、自动化脚本或轻量容器中,引入体积庞大的 Pandas 会增加部署负担与启动耗时。此时直接使用原生库 xlrd 和 openpyxl 配合适配器模式(Adapter Pattern),即可输出一致的数据结构(如行字典列表)。
该模式的关键在于抹平底层 API 的差异:
- 工作簿与表单获取:
xlrd使用workbook.sheet_by_name()或workbook.sheet_by_index(),而openpyxl使用字典语法workbook[sheet_name]或workbook.worksheets[index]。 - 行列索引与坐标:
xlrd坐标基于 0(从 0 开始),而openpyxl单元格坐标基于 1(第 1 行第 1 列为cell(1, 1))。 - 日期格式处理:旧版
.xls中日期本质存储为浮点数,必须结合xlrd.xldate_as_datetime配合workbook.datemode转换为标准datetime;新版openpyxl默认会自动将日期格式单元格解析为datetime.datetime或datetime.date。
import os
from abc import ABC, abstractmethod
from datetime import datetime
from typing import List, Any, Generator, Dict
import xlrd
import openpyxl

class BaseExcelReader(ABC):
    """统一抽象读取接口"""
    def __init__(self, file_path: str):
        self.file_path = file_path

    @abstractmethod
    def get_sheet_names(self) -> List[str]:
        """获取所有工作表名称"""
        pass

    @abstractmethod
    def iter_rows(self, sheet_index: int = 0) -> Generator[List[Any], None, None]:
        """按行迭代读取单元格原生值"""
        pass

class XlsReader(BaseExcelReader):
    """处理旧版 .xls 的专用适配器"""
    def __init__(self, file_path: str):
        super().__init__(file_path)
        self.workbook = xlrd.open_workbook(self.file_path)

    def get_sheet_names(self) -> List[str]:
        return self.workbook.sheet_names()

    def iter_rows(self, sheet_index: int = 0) -> Generator[List[Any], None, None]:
        sheet = self.workbook.sheet_by_index(sheet_index)
        for row_idx in range(sheet.nrows):
            row_values = []
            for col_idx in range(sheet.ncols):
                cell_type = sheet.cell_type(row_idx, col_idx)
                value = sheet.cell_value(row_idx, col_idx)
                # xlrd.XL_CELL_DATE 常量值为 3,需转换日期数字
                if cell_type == xlrd.XL_CELL_DATE:
                    value = datetime(*xlrd.xldate_as_tuple(value, self.workbook.datemode))
                row_values.append(value)
            yield row_values

class XlsxReader(BaseExcelReader):
    """处理新版 .xlsx 的专用适配器"""
    def __init__(self, file_path: str):
        super().__init__(file_path)
        # data_only=True 读取单元格计算后的缓存值而非公式文本
        self.workbook = openpyxl.load_workbook(self.file_path, data_only=True, read_only=True)

    def get_sheet_names(self) -> List[str]:
        return self.workbook.sheetnames

    def iter_rows(self, sheet_index: int = 0) -> Generator[List[Any], None, None]:
        sheet = self.workbook.worksheets[sheet_index]
        for row in sheet.iter_rows(values_only=True):
            yield list(row)

class UnifiedExcelReader:
    """统一外观入口,对外提供一致接口"""
    @staticmethod
    def get_reader(file_path: str) -> BaseExcelReader:
        ext = os.path.splitext(file_path)[1].lower()
        if ext == ".xls":
            return XlsReader(file_path)
        elif ext in (".xlsx", ".xlsm"):
            return XlsxReader(file_path)
        else:
            raise ValueError(f"不支持的文件格式: {ext}")

    @classmethod
    def read_as_dicts(cls, file_path: str, sheet_index: int = 0) -> List[Dict[str, Any]]:
        """将第一行视为表头,读取为字典列表"""
        reader = cls.get_reader(file_path)
        row_gen = reader.iter_rows(sheet_index=sheet_index)
        try:
            headers = [str(h).strip() if h is not None else f"col_{i}" for i, h in enumerate(next(row_gen))]
        except StopIteration:
            return []

        records = []
        for row in row_gen:
            # 补齐行数据长度与表头一致
            padded_row = list(row) + [None] * (len(headers) - len(row))
            records.append(dict(zip(headers, padded_row[:len(headers)])))
        return records

# 原生调用示例:
# data_list = UnifiedExcelReader.read_as_dicts("legacy_report.xls")
四、关键细节与避坑指南
在批量处理不同来源的 Excel 文件时,代码常会遇到以下典型异常:
1. 虚假扩展名与文件伪装
业务系统中大量存在“将 CSV 文本直接重命名为 .xls”或“将 .xls 改后缀为 .xlsx”的现象。如果仅靠 os.path.splitext 分发,会导致解析库抛出 zipfile.BadZipFile: File is not a zip file 或 XLRDError: Unsupported format, or corrupt file。前文所实现的基于前 8 字节魔数探测能够从物理层拦截此类伪装:若发现既不是 PK 压缩头也不是 OLE2 复合头,应退回尝试使用标准 CSV 解析器读取。
2. 日期序列值的单位偏差
在旧版 .xls 中,日期被记录为天数浮点数(基于 1900 或 1904 日期基准体系)。若使用 xlrd 未检查单元格类型而直接获取 cell_value,读出的将是类似 44927.0 的浮点数。必须通过 xlrd.xldate_as_tuple() 结合当前工作簿的 datemode 才能精准还原为年、月、日、时、分、秒。
3. 公式单元格的取值差异
对于含有计算公式的单元格,openpyxl 默认会读取公式文本(如 =SUM(A1:A10))而非计算结果。在数据读取场景下,必须在 load_workbook 时传入 data_only=True,以读取 Excel 上次保存时缓存的计算结果;而 xlrd 默认即返回公式的计算后数值。
4. 大文件内存控制
.xlsx 文件经 ZIP 解压后的 XML 文本体积通常会膨胀 5 至 10 倍。读取几十兆的 .xlsx 文件可能消耗数吉字节内存。使用 openpyxl 读取时,务必加上 read_only=True 参数以开启按行流式解析;而 .xls 的 BIFF8 结构不支持流式读取,单表大小受限于 65,536 行,若遇到超出该限制的场景,需推动上游导出为 .xlsx 或 .csv。
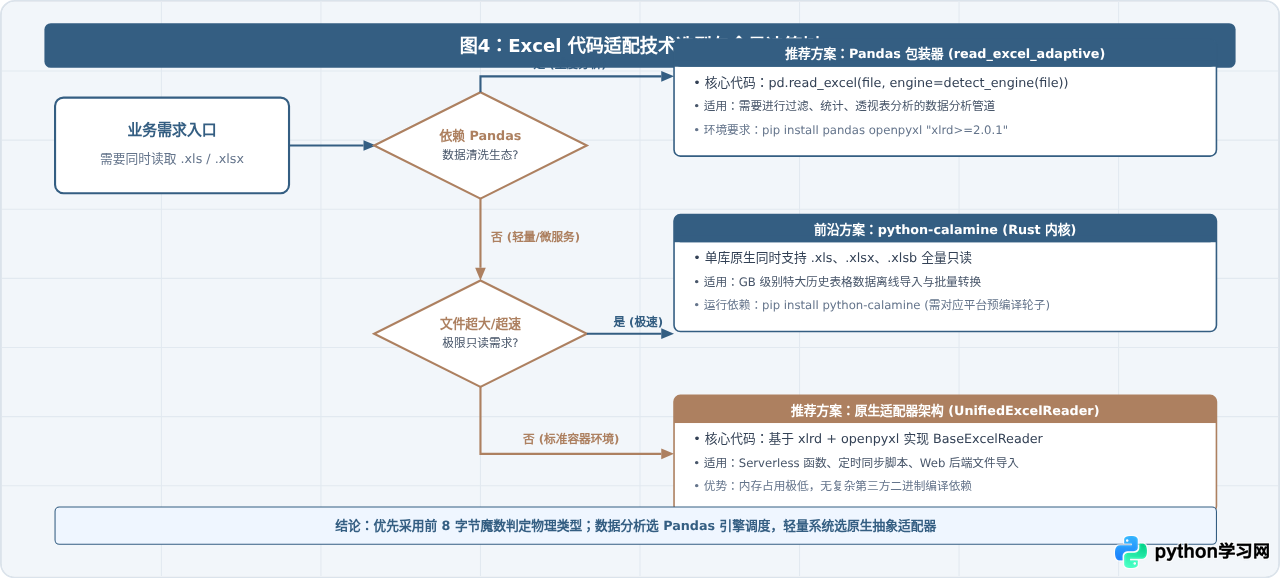
五、方案选型与适配策略总结
针对不同的生产诉求,可按下表快速决定适配实现路径:
| 方案类型 | 依赖组件 | 适用场景 | 内存表现 | 核心优势 |
|---|---|---|---|---|
| Pandas 动态引擎分发 | pandas, openpyxl, xlrd |
数据清洗、统计分析、批量处理 | 中等(全量载入 DataFrame) | 一行代码自适应,无缝衔接后续数据分析 |
| 原生抽象适配器模式 | openpyxl, xlrd |
轻量自动化、微服务、嵌入式管道 | 优秀(支持逐行生成器迭代) | 无大型数据框架依赖,启动迅速,内存可控 |
| 高性能跨语言引擎 | python-calamine |
超大报表高速只读场景 | 极佳(Rust 内核加速) | 统一支持 xls 与 xlsx,单库极速只读 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









