

Python大规模矩阵运算内存溢出优化策略
针对Python处理大规模矩阵时频发的内存溢出(OOM)问题,深入剖析物理内存峰值成因,系统讲解降低精度、稀疏化存储、原地计算、内存映射与分块流式处理等核心优化方案及工程落地实践。
在利用 Python 进行科学计算、高维特征工程或深度学习数据预处理时,处理成千上万维度的稠密矩阵极易触发内存溢出(Out Of Memory,简称 OOM)。这通常并非算法逻辑错误,而是由于物理内存容量限制、中间临时数组堆积、不当的数组复制以及广播机制膨胀共同导致的。解决该问题的核心路径在于两方面:一方面降低单次驻留内存的数据体积,另一方面避免无意识的瞬时内存峰值。本文系统梳理从底层内存量化、就地计算、精度降级,到分块求值与虚拟内存映射的成套工程化应对策略。
一、矩阵内存占用的量化评估与溢出成因剖析
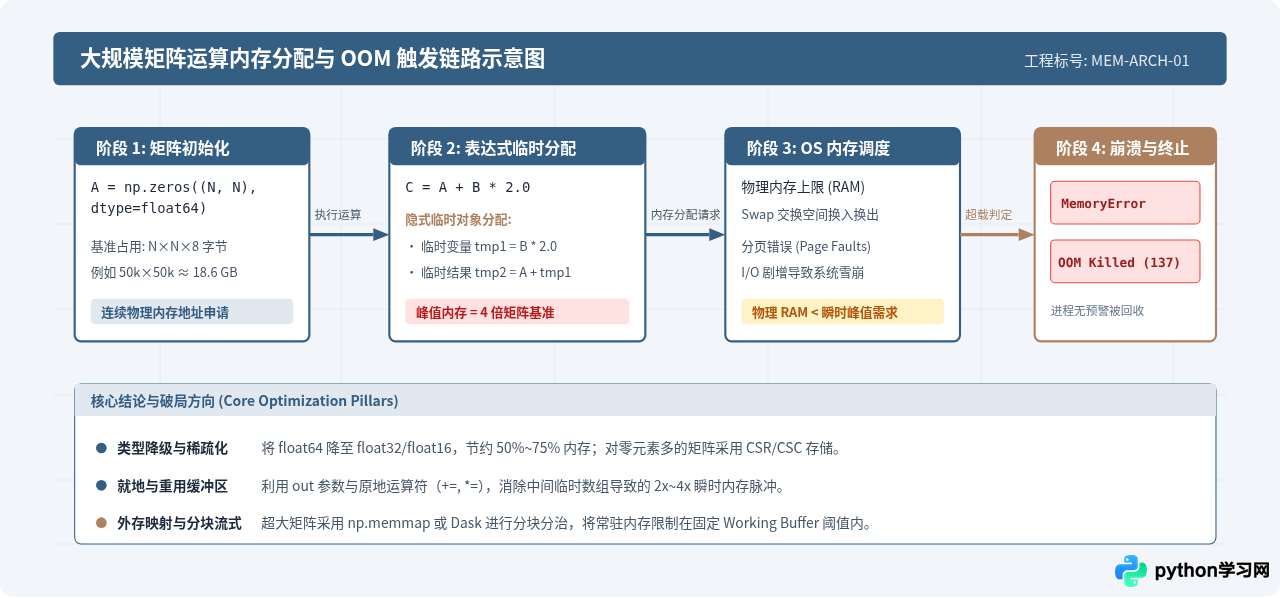
在着手优化之前,必须具备精确评估内存开销的能力。NumPy 数组的内存消耗遵循简单的数学规则:总字节数 = 矩阵行数 × 矩阵列数 × 单个数据类型的字节宽度。默认情况下,Python 和 NumPy 创建浮点数组时采用 64 位双精度浮点数(float64),每个元素独占 8 字节。
举例而言,一个具有 100,000 行、100,000 列的方阵,其纯数据所占用的物理内存为:100,000 × 100,000 × 8 字节 ≈ 80,000,000,000 字节,即整整 74.5 GB。若主机的物理内存仅有 16 GB 或 32 GB,单次分配便会直接被操作系统强行终止(在 Linux 下通常被 OOM Killer 杀死,退出码为 137)。
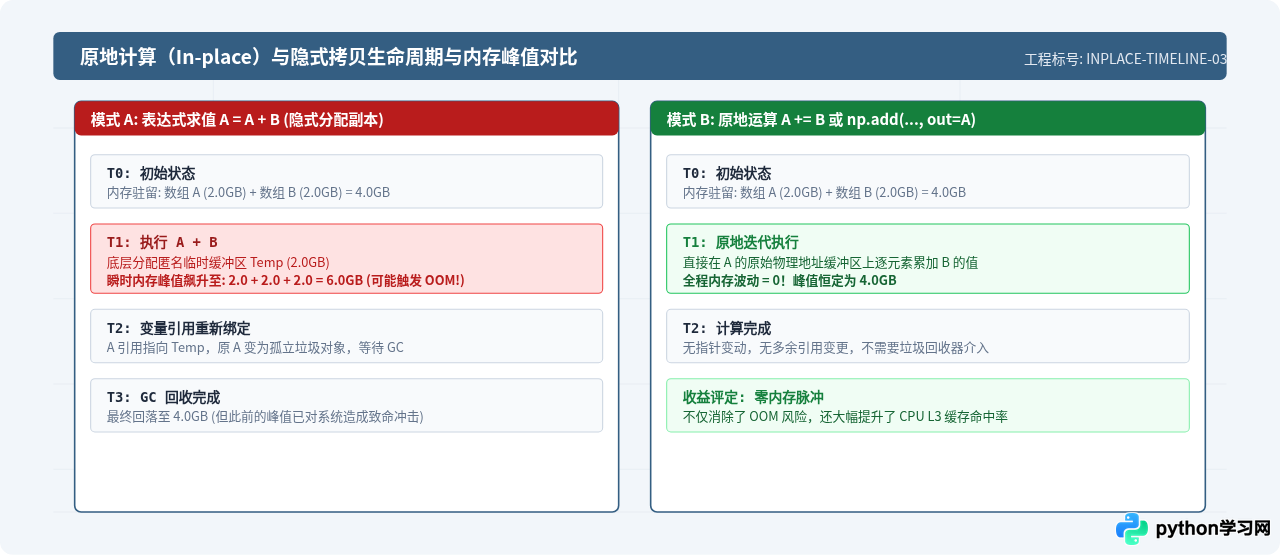
更为关键的是,即便矩阵本身的容量略小于物理内存,中间运算过程中的临时变量分配也会让内存占用成倍增加。例如执行最简单的加法运算 A = A + B 时,NumPy 会先在内存中分配一块等同于矩阵大小的临时缓冲区来存放 A + B 的计算结果,随后再将变量名 A 重新绑定到新缓冲区,原先的 A 则等待垃圾回收。在此瞬间,系统同时驻留了旧 A、B 以及临时结果,瞬时内存需求直接达到初始值的 3 倍。
二、策略一:数据类型降级与稀疏存储模式
在工程实践中,最迅速且收益立竿见影的优化,是对矩阵底层数据结构进行瘦身。
1. 针对精度敏感度进行数据类型降级(Dtype Downcasting)
许多机器学习与图形计算任务中,float32(单精度,4 字节)甚至 float16(半精度,2 字节)所提供的有效数字范围已完全能够满足收敛要求。在不需要达到 15~17 位有效数字精度的场景下,强行使用 float64 属于严重的资源浪费。
import numpy as np

# 产生 40000 x 40000 的高维矩阵
rows, cols = 40000, 40000

# 默认 float64: 占用 40000 * 40000 * 8 / 1024**3 ≈ 11.92 GB
matrix_f64 = np.ones((rows, cols), dtype=np.float64)

# 降级为 float32: 占用 40000 * 40000 * 4 / 1024**3 ≈ 5.96 GB (立减 50%)
matrix_f32 = np.ones((rows, cols), dtype=np.float32)

# 若为整型标签或掩码,可进一步收缩为 uint8 或 int16
mask = np.zeros((rows, cols), dtype=np.uint8) # 仅占 1.49 GB
判断降级可行性的方法非常明确:对比关键步骤在 float64 与 float32 下输出结果的最大相对误差(np.max(np.abs(res_f64 - res_f32) / np.abs(res_f64)))。若相对误差在业务容差范围内(例如小于 1e-5),即可全量切换为 float32。
2. 稀疏矩阵转换(Scipy Sparse)
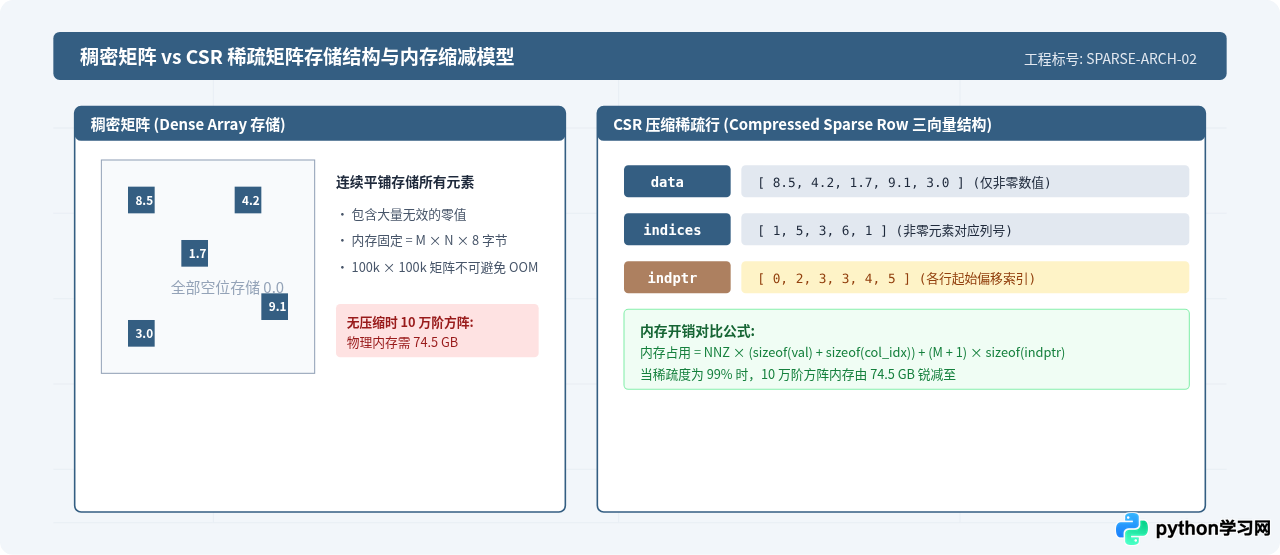
当矩阵中存在大量零值(通常非零元素占比低于 5%~10%)时,例如自然语言处理中的 TF-IDF 矩阵、图计算中的邻接矩阵、协同过滤交互矩阵,稠密数组形式保存零元素是造成 OOM 的头号元凶。此时应当全面转向 scipy.sparse 结构:
- CSR (Compressed Sparse Row):按行压缩存储,适合高效率的矩阵-向量乘法、行切片与线性方程求解。
- CSC (Compressed Sparse Column):按列压缩存储,适合快速列切片与按列提取操作。
- COO (Coordinate):三元组格式(row, col, value),构建矩阵效率最高,但不利于代数运算,通常用于装配阶段,装配完毕后通过
.tocsr()转换。
三、策略二:原地运算(In-Place)与消除隐式内存拷贝
在编写矩阵算子时,代码的书写形式直接决定了内存中是否会出现瞬时分配爆炸。必须深刻理解 NumPy 的视图(View)与副本(Copy)机制,并坚决启用原地计算。
1. 原地运算符与 out 参数
常规算术运算符(如 +、-、*)默认执行的是分配新缓冲区的非就地运算。优化时应优先使用原地运算符(+=、*=)或 NumPy 通用函数(ufunc)中提供的 out 参数:
import numpy as np

# 假设已有两个大矩阵 A 和 B
A = np.random.rand(20000, 20000).astype(np.float32) # ~1.49 GB
B = np.random.rand(20000, 20000).astype(np.float32) # ~1.49 GB

# [错误写法]: 产生临时对象,峰值内存达到 1.49 * 3 = 4.47 GB
# A = A + B

# [推荐写法 1]: 使用原地运算符,零额外内存分配
A += B

# [推荐写法 2]: 使用 ufunc 的 out 参数将结果直接写入已存在的数组
np.add(A, B, out=A)

# [高级写法]: 矩阵乘法同样支持 out 参数
C = np.empty((20000, 20000), dtype=np.float32)
np.matmul(A, B, out=C) # 直接产出到预分配的 C,不产生额外中间容器
2. 识别并避免隐式拷贝
以下典型操作会静默产生整个矩阵的拷贝,是引发内存泄漏表象的常见诱因:
- 花式索引(Fancy Indexing):使用整型数组或布尔掩码索引(如
A[idx_arr])必定返回完整副本;而基本切片(如A[100:500, :])仅返回视图,几乎不消耗额外内存。 - 非连续内存转置:转置
A.T本身是零成本视图,但如果在后续调用中强行执行np.ascontiguousarray(A.T),则会立即在内存中重新复制一份完整的 C 连续数组。 - 广播扩张复制:对一维向量与二维矩阵求和
vec + Matrix时,NumPy 会在虚拟视图层广播,但若手动调用np.tile(vec, (N, 1)),则会在物理内存中直接铺开实体数组。
四、策略三:分块计算(Chunking)与外存映射(np.memmap)
当经过数据类型优化与稀疏化改造后,单张矩阵规模依然超越了当前机器物理 RAM 的承受极限(例如 100 GB 级别甚至 TB 级别),必须采取分块分治或内存映射将数据置于磁盘中,按需换入内存处理。
1. 手动分块矩阵乘法(Block Matrix Multiplication)
对于大矩阵与大矩阵相乘 $C = A \times B$,如果全量计算直接 OOM,可以通过分块算法分解为子矩阵运算:
import numpy as np

def chunked_matmul(A, B, chunk_size=5000):
    """
    分块矩阵乘法:仅按需将行块与列块加载至内存
    """
    M, K = A.shape
    K2, N = B.shape
    assert K == K2, "矩阵维度不匹配"

    # 预先分配结果容器(如果内存不足,结果容器也可以使用 np.memmap)
    C = np.zeros((M, N), dtype=A.dtype)

    for i in range(0, M, chunk_size):
        i_end = min(i + chunk_size, M)
        A_block = A[i:i_end, :] # 仅切取 A 的水平行块

        for j in range(0, N, chunk_size):
            j_end = min(j + chunk_size, N)
            B_block = B[:, j:j_end] # 仅切取 B 的垂直列块

            # 局部块乘法并写入对应位置
            C[i:i_end, j:j_end] = np.dot(A_block, B_block)

    return C
2. 使用 NumPy 磁盘映射(np.memmap)突破 RAM 物理边界
np.memmap 允许将保存在磁盘上的二进制文件直接作为 NumPy 数组进行切片和代数运算。操作系统会在后台根据需要自动调入页面(Page In)并将脏页刷盘(Flush/Page Out),从而在仅有 16 GB 内存的主机上流畅处理 200 GB 的矩阵:
import numpy as np

# 1. 在磁盘创建可容纳 100,000 x 50,000 的大矩阵文件 (约 18.6 GB)
filename = "large_matrix.dat"
shape = (100000, 50000)

# 创建或挂载外存映射文件 (读写模式 'w+')
mmap_mat = np.memmap(filename, dtype='float32', mode='w+', shape=shape)

# 2. 像常规数组一样分批次向其中写入或运算
batch_size = 5000
for i in range(0, shape[0], batch_size):
    mmap_mat[i:i+batch_size, :] = np.random.randn(batch_size, shape[1]).astype('float32')

# 3. 必须显式将脏页数据刷写至物理磁盘存储
mmap_mat.flush()

# 4. 后续仅以只读模式 'r' 打开,只按需读取切片,绝无 OOM 风险
readonly_mat = np.memmap(filename, dtype='float32', mode='r', shape=shape)
row_slice = readonly_mat[100:200, :] # 仅调入 100 行对应页面进入 RAM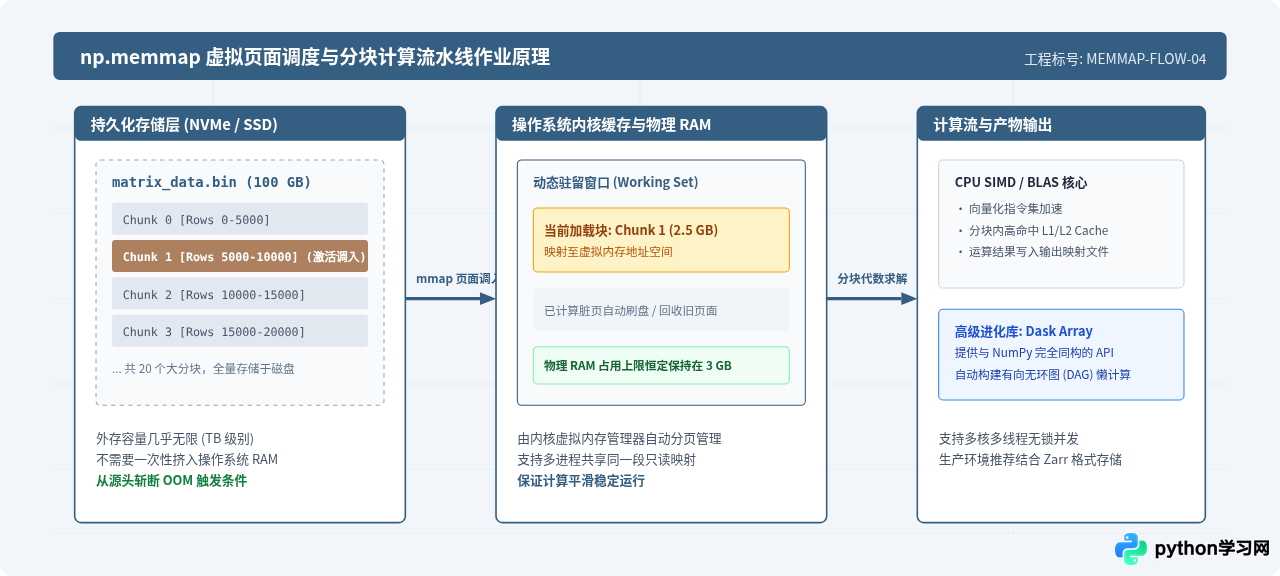
五、综合策略选型与排查落地决策树
在面对具体的超大矩阵运算报错或高内存消耗时,不应急于重构整个代码架构。按照规范的决策流程逐步排查,通常能够在最小的代码侵入下彻底解决问题。
实战排查与监控建议:
在调试阶段,可使用标准库中的 tracemalloc 快速定位到底是哪一行代码导致了内存剧增:
import tracemalloc

tracemalloc.start()
# 执行可疑矩阵运算代码片段
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:3]:
    print(stat) # 输出消耗内存最多的前三行代码及具体字节数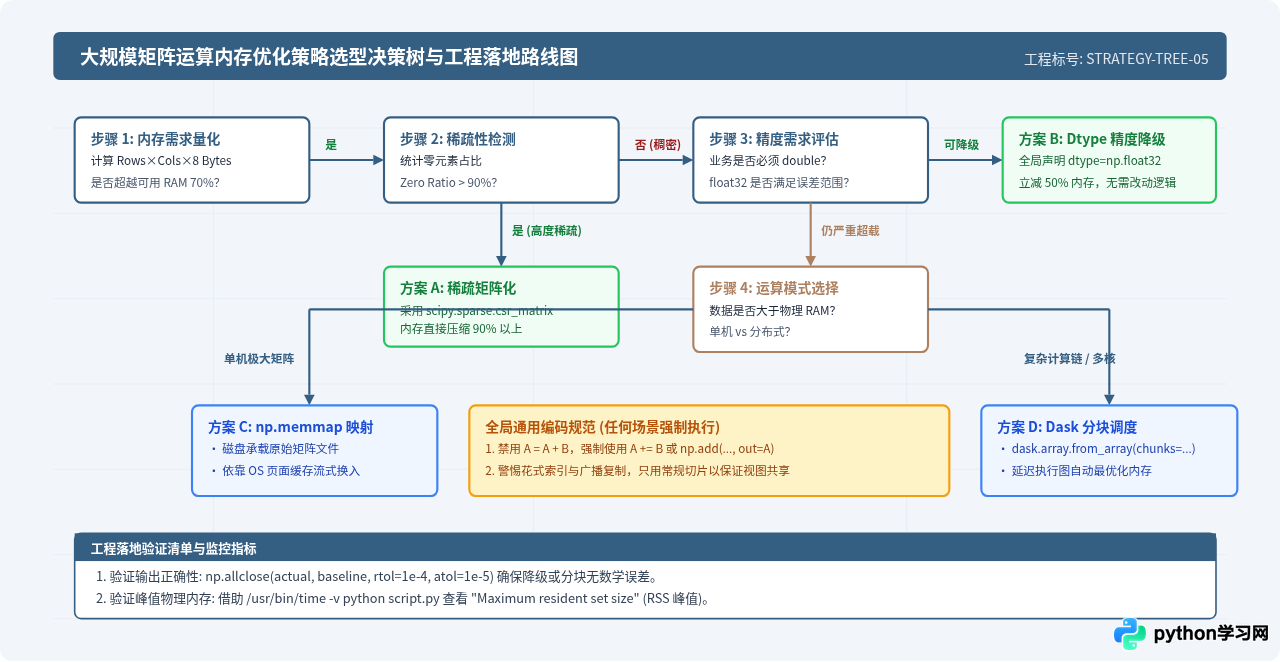
六、总结与落地建议
处理大规模矩阵运算时的内存溢出,本质上是在时间复杂度、空间占用与编程复杂度之间寻找工程平衡点。实际项目中应遵循以下实施步骤:
- 第一步(规范代码):审查表达式,将所有中间运算改为原地操作(In-place),消除 2~4 倍的瞬时峰值脉冲。
- 第二步(压缩精度):在数值误差允许的前提下,将
float64统一切换为float32,立减 50% 内存。 - 第三步(结构稀疏化):若矩阵为稀疏阵,立即迁移至
scipy.sparse.csr_matrix,享受量级压缩。 - 第四步(分块与外存):若单机稠密矩阵硬性超越 RAM 上限,使用
np.memmap构建磁盘虚拟页,配合分块流式迭代,以略微牺牲磁盘 I/O 吞吐为代价,保证计算能够平稳完成。
通过上述策略的组合应用,能够在不升级硬件配置的前提下,将单机处理矩阵运算的规模边界拓展数倍至数十倍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









