

Python应用基础必掌握的标准库与第三方库清单
一、标准库与第三方库的分工定位
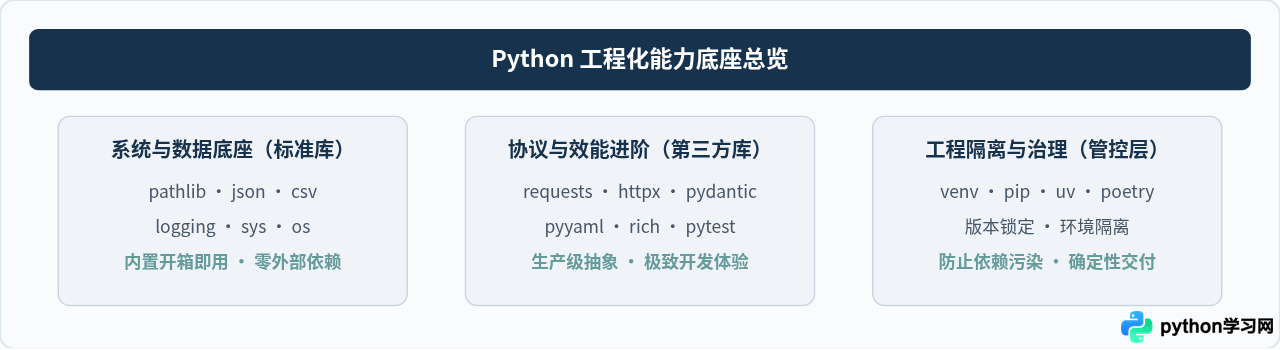
Python 语言自带“电池(Batteries Included)”设计理念,安装 Python 解释器后即附带了大量标准库模块。但在实际生产项目中,开发者往往容易陷入两种极端:要么盲目为每一个小功能安装第三方包,导致项目依赖臃肿不堪;要么坚守“纯原生”拒绝引入任何第三方库,在底层协议解析和复杂序列化上重复发明漏洞百出的轮子。
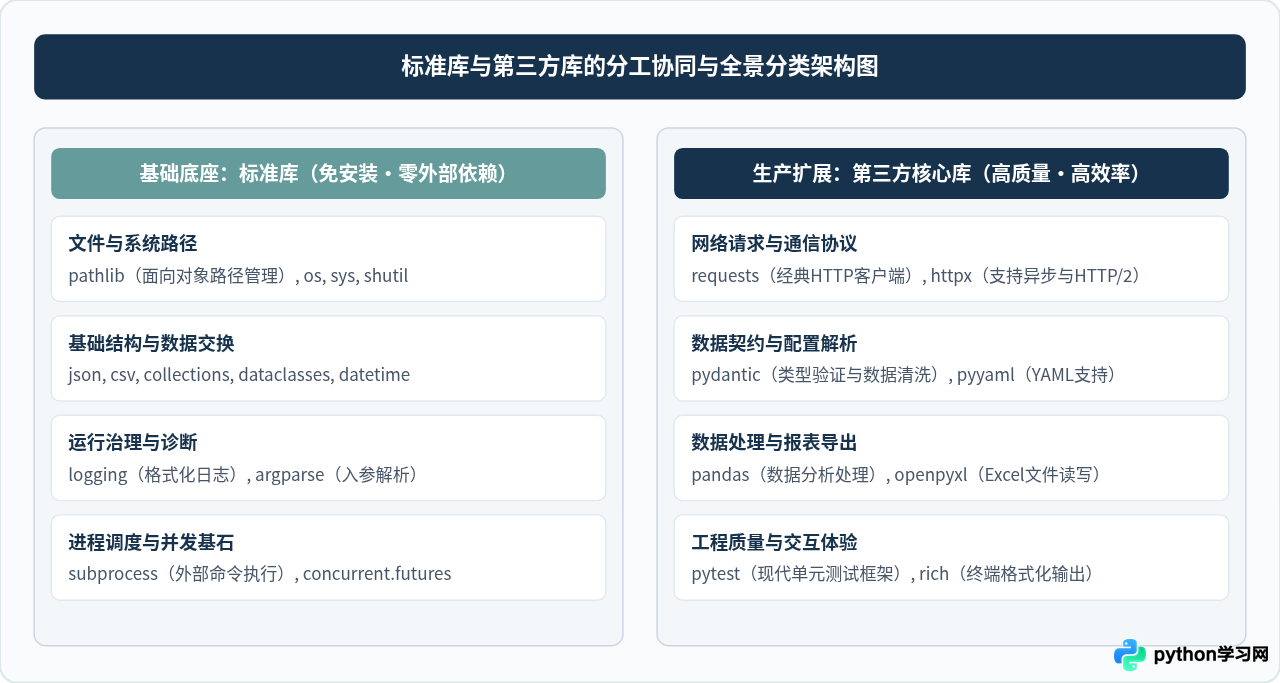
清晰的技术选型原则应当是:标准库负责保障底层可靠性、通用文件交互、进程管控与规范化日志;第三方库负责解决协议层便利性、强类型运行时校验、复杂格式转换以及工程测试。
二、必掌握的核心标准库精要
标准库随着 Python 解释器分发,在容器环境或受限网络中无需执行 pip install 即可直接运行。掌握以下五个维度的模块,足以应对 70% 以上的日常工程调度任务。
1. 文件系统与路径管理:pathlib
在现代 Python(3.6+)中,强烈建议使用 pathlib.Path 完全替代过往字符串拼接形式的 os.path。Path 对象能够屏蔽 Windows 反斜杠与 Linux 正斜杠的跨平台差异,且语法极具语义性。
from pathlib import Path

# 获取当前工作目录或指定相对路径
base_dir = Path(__file__).resolve().parent
target_file = base_dir / "data" / "reports" / "summary.json"

# 自动递归创建上层目录(若不存在),避免 FileNotFoundError
target_file.parent.mkdir(parents=True, exist_ok=True)

# 写入与读取文本内容(明确指明 UTF-8 编码)
target_file.write_text('{"status": "ok"}', encoding="utf-8")
content = target_file.read_text(encoding="utf-8")
2. 结构化数据交换:json 与 csv
绝大多数 API 通信与基础存储均基于 JSON 或 CSV。使用内置的 json 模块时,最关键的是明确区分内存字符串序列化(dumps/loads)与文件流读写(dump/load),并务必指定 ensure_ascii=False 避免中文字符被转码为 Unicode 转义序列。
import json
import csv
from pathlib import Path

data = {"user": "张三", "roles": ["admin", "developer"], "active": True}

# 写入 JSON 文件,保留中文字面量与缩进
output_json = Path("profile.json")
with output_json.open("w", encoding="utf-8") as f:
    json.dump(data, f, ensure_ascii=False, indent=2)

# 读取并写入 CSV 数据
csv_file = Path("users.csv")
with csv_file.open("w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["ID", "姓名", "状态"])
    writer.writerow([1001, "李四", "正常"])
3. 生产级日志追踪:logging
禁止在生产级脚本或服务中使用 print 替代日志。logging 模块提供了分级输出(DEBUG, INFO, WARNING, ERROR, CRITICAL)、日志输出格式控制、文件按大小滚动切分等核心能力。
import logging

# 推荐在应用入口配置基础日志格式
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(name)s: %(message)s",
    datefmt="%Y-%m-%d %H:%M:%S"
)
logger = logging.getLogger("AppModule")

logger.info("任务调度启动,当前状态正常")
try:
    result = 10 / 0
except ZeroDivisionError:
    logger.exception("计算发生不可预期的除零异常")
4. 外部程序安全调用:subprocess
不要使用古老的 os.system,因为它无法捕获执行输出,且存在命令注入风险。统一使用 subprocess.run,传入参数列表而非拼接字符串,并明确捕获返回码与标准输出。
import subprocess

# 安全执行系统命令,捕获输出与超时限制
try:
    completed = subprocess.run(
        ["git", "status", "--porcelain"],
        capture_output=True,
        text=True,
        check=True,
        timeout=10
    )
    print("Git状态输出:\n", completed.stdout)
except subprocess.CalledProcessError as err:
    print(f"命令执行失败,错误代码: {err.returncode}, 详情: {err.stderr}")
except subprocess.TimeoutExpired:
    print("命令执行超时,已终止")
5. 数据结构增强:collections 与 dataclasses
当字典和列表无法满足高效查找或结构体定义时,collections.defaultdict、collections.Counter 以及标准库内置的 dataclasses 能够极大地减少模板代码。
from collections import Counter
from dataclasses import dataclass

# 统计词频
counts = Counter(["apple", "banana", "apple", "orange", "banana", "apple"])
print(counts.most_common(1))  # [('apple', 3)]

# 声明式数据容器
@dataclass
class ServiceNode:
    name: str
    ip: str
    port: int = 8080

node = ServiceNode(name="auth-core", ip="10.0.1.25")
print(node)  # ServiceNode(name='auth-core', ip='10.0.1.25', port=8080)
三、必掌握的五大第三方生产库
当标准库的抽象层级无法支撑高效开发时,以下五个第三方库是 Python 社区公认的工业级首选方案。
1. 网络交互标准:requests / httpx
虽然标准库拥有 urllib.request,但其处理 Cookie、认证、JSON 解析以及连接池复用时代码极其晦涩。requests 提供了最直观的人性化 API;而在需要异步(AsyncIO)支持或 HTTP/2 通信时,httpx 是最契合的现代化演进选择。
import requests

session = requests.Session()
session.headers.update({"User-Agent": "DataCollector/1.0"})

try:
    # 自动重试与超时控制是生产环境必备配置
    response = session.get(
        "https://api.github.com/repos/python/cpython",
        timeout=(3.05, 10)  # (连接超时, 读取超时)
    )
    response.raise_for_status()  # 遇到 4xx/5xx 直接抛出 HTTPError
    payload = response.json()
    print("Stars 数量:", payload.get("stargazers_count"))
except requests.exceptions.RequestException as exc:
    print("网络请求失败:", exc)
2. 强类型运行时校验:pydantic
在接收外部不可控输入(如 RESTful 接口传参、JSON 配置文件读取)时,仅靠字典取值非常容易在深层逻辑中触发 KeyError 或类型错误。pydantic 能够在反序列化的瞬间完成字段类型检查与强制转换。
from pydantic import BaseModel, Field, EmailStr

class AppConfig(BaseModel):
    app_id: str = Field(min_length=3)
    worker_count: int = Field(default=4, ge=1, le=32)
    admin_email: str
    enable_debug: bool = False

# 输入原始字典,自动完成验证与类型推断
raw_input = {"app_id": "svc-01", "worker_count": "8", "admin_email": "ops@example.com"}
config = AppConfig.model_validate(raw_input)
print(f"验证通过,工作进程数类型: {type(config.worker_count)},值为: {config.worker_count}")
3. 复杂配置文件支持:pyyaml
相比于 JSON 不支持注释与格式冗长,现代 DevOps 与中后台应用广泛采用 YAML 格式管理配置。使用 pyyaml 库时,务必注意始终使用 yaml.safe_load,杜绝直接加载可能导致代码注入的任意对象。
import yaml
from pathlib import Path

config_text = """
server:
  host: 0.0.0.0
  port: 8000
database:
  pool_size: 20
  timeout: 5.5
"""
# 必须使用 safe_load 解析非信任来源的 YAML
parsed = yaml.safe_load(config_text)
print("解析后的端口配置:", parsed["server"]["port"])
4. 表格分析与持久化:pandas 与 openpyxl
如果应用涉及日常批量报表导出、复杂数据清洗或与业务部门交互,pandas 提供了内存中极为高效的数据帧运算,配合 openpyxl 引擎可以直接输出原生 .xlsx 电子表格文件。
import pandas as pd

# 快速构建数据集并导出为 Excel
data = [
    {"模块": "身份验证", "延迟_ms": 45, "成功率": 0.998},
    {"模块": "订单支付", "延迟_ms": 120, "成功率": 0.992},
]
df = pd.DataFrame(data)
# 导出为 Excel 文件(底层调用 openpyxl)
df.to_excel("service_report.xlsx", index=False, engine="openpyxl")
5. 自动化测试标杆:pytest
不要使用标准库自带的 unittest 编写繁琐的测试类与继承结构。pytest 支持纯粹的 Python assert 表达式,并拥有高度灵活的 Fixture 依赖注入机制与丰富的插件生态。
# test_calculation.py
def calculate_discount(price: float, rate: float) -> float:
    if not (0 < rate <= 1):
        raise ValueError("折扣率必须在 0 到 1 之间")
    return round(price * rate, 2)

def test_calculate_discount_normal():
    assert calculate_discount(100.0, 0.8) == 80.0

def test_calculate_discount_boundary():
    import pytest
    with pytest.raises(ValueError):
        calculate_discount(100.0, 1.5)
四、全流程实战:库协同执行链路
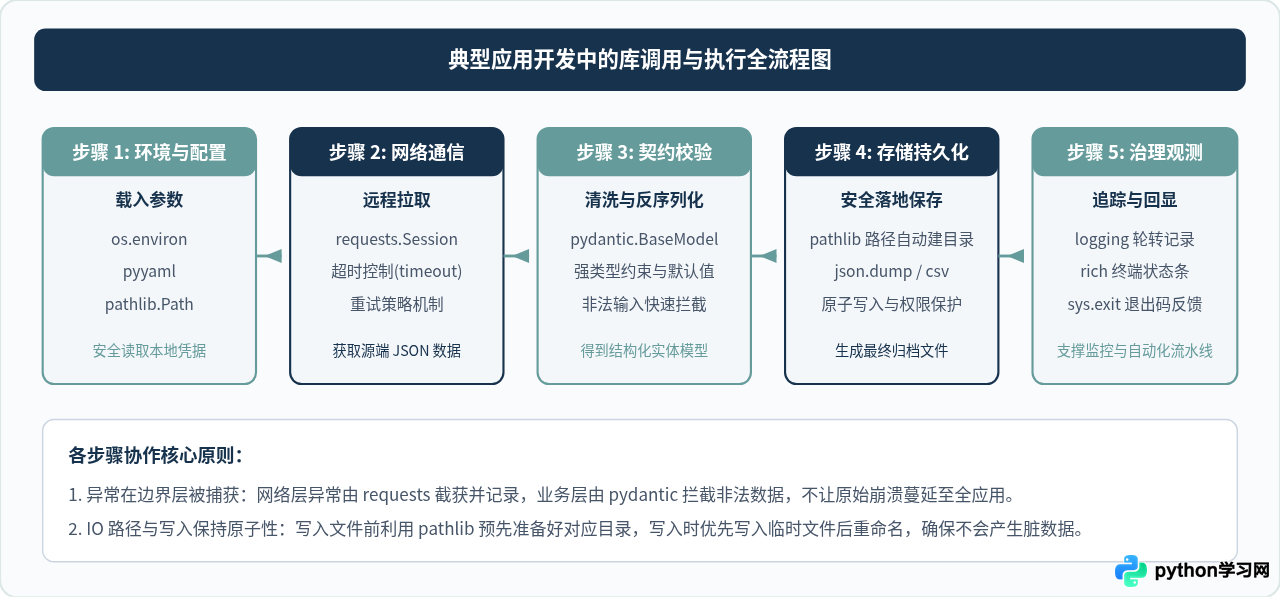
在实际应用中,标准库与第三方库并非割裂运行,而是形成一条自上而下的流转链条。以下展示一个典型业务任务的标准闭环:从配置文件读取与环境变量覆盖、远程接口拉取、数据模型校验,到本地安全目录写入与带格式的日志输出。
代码实现范例
import json
import logging
import sys
from pathlib import Path
from typing import List, Optional
import requests
from pydantic import BaseModel, Field

# 1. 基础日志初始化
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("WorkflowExecutor")

# 2. 定义业务模型
class ReleaseItem(BaseModel):
    tag_name: str
    published_at: str
    author_login: str = Field(alias="author", default="")

    @classmethod
    def from_api_dict(cls, data: dict):
        return cls(
            tag_name=data.get("tag_name", "unknown"),
            published_at=data.get("published_at", ""),
            author_login=data.get("author", {}).get("login", "robot")
        )

# 3. 业务协同执行函数
def sync_release_metadata(repo: str, output_dir: Path) -> Optional[Path]:
    api_url = f"https://api.github.com/repos/{repo}/releases"
    output_dir.mkdir(parents=True, exist_ok=True)
    target_file = output_dir / f"{repo.replace('/', '_')}_releases.json"

    logger.info(f"开始拉取仓库 {repo} 发版数据")
    try:
        resp = requests.get(api_url, timeout=(3.0, 10.0))
        resp.raise_for_status()
        raw_list = resp.json()
    except requests.RequestException as err:
        logger.error(f"拉取失败: {err}")
        return None

    # 模型校验与提纯
    validated_records = [
        ReleaseItem.from_api_dict(item).model_dump()
        for item in raw_list[:5]
    ]

    # 安全写入本地
    target_file.write_text(json.dumps(validated_records, ensure_ascii=False, indent=2), encoding="utf-8")
    logger.info(f"成功保存 {len(validated_records)} 条记录至 {target_file}")
    return target_file

if __name__ == "__main__":
    work_dir = Path("./workspace_output")
    result = sync_release_metadata("pallets/flask", work_dir)
    sys.exit(0 if result else 1)
五、关键选型与场景决策矩阵
面对同一个功能诉求,很多开发者常常犹豫何时用标准库、何时引入第三方库。下面的矩阵清晰列出了各场景下的决策依据与权衡考量。
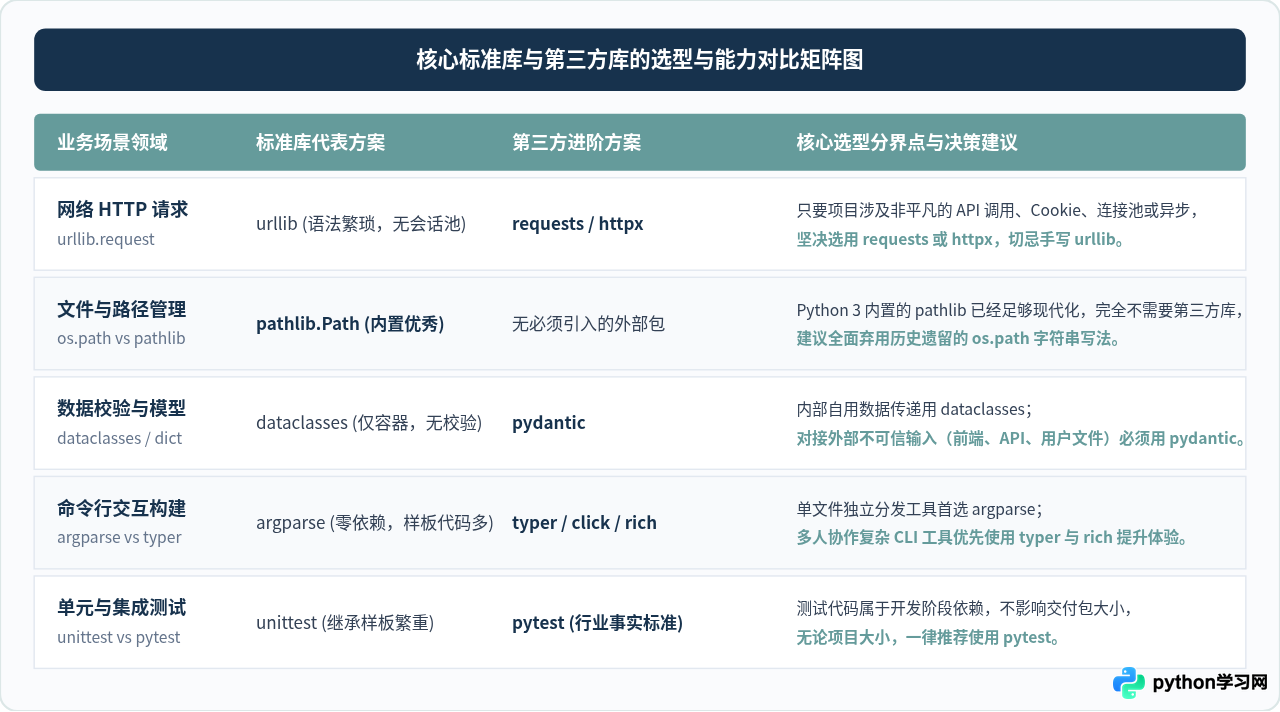
| 需求分类 | 首选标准库 | 建议第三方库 | 核心选型理由 |
|---|---|---|---|
| 文件与目录 | pathlib |
无需第三方 | 原生 Path 对象支持 / 拼接与自动建目录,已淘汰 os.path |
| 网络接口通信 | urllib.request(仅限紧急脚本) |
requests / httpx |
原生库无长连接维持与友好异常体系,生产环境必选第三方 |
| 数据契约与校验 | dataclasses(内部容器) |
pydantic |
外部不受控数据进入应用时,必须经由 Pydantic 进行类型强制转换与验证 |
| 配置持久化 | json, configparser |
pyyaml |
开发友好型配置文件(支持注释、层级清晰)首选 YAML |
| 表格与数据操作 | csv |
pandas, openpyxl |
简单流式数据用 csv 即可;复杂报表、列运算与 Excel 交付用 Pandas |
| 系统诊断与输出 | logging, sys |
rich |
生产后台运行依靠 logging 文件记录;交互式命令行通过 rich 提供高亮展示 |
六、依赖工程治理与避坑实践
选好库仅仅是第一步,如何让包含第三方库的项目在不同环境(本地开发机、CI 流水线、生产容器)稳定运行,需要遵循严谨的依赖治理规则。
全局安装容易导致不同项目之间的库版本相互冲突,甚至污染操作系统自带的 Python 组件(如 Linux 的包管理器)。任何 Python 项目都必须从创建虚拟环境开始。
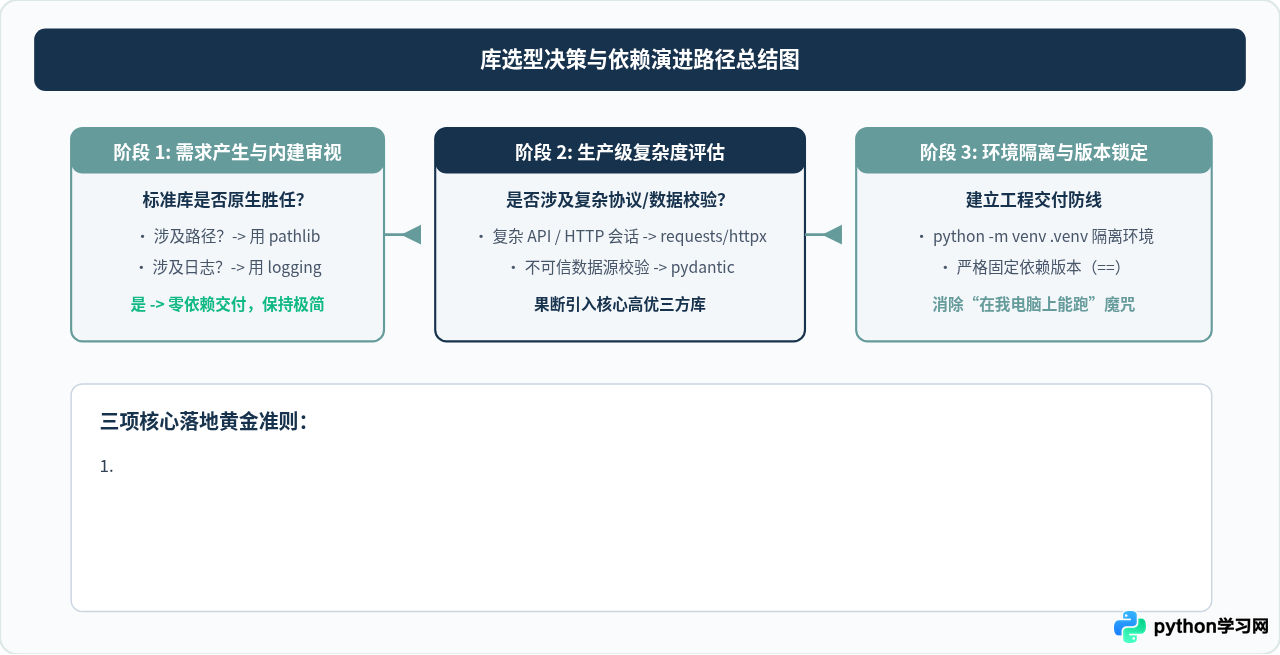
规范的环境初始化操作步骤
启动任何新项目时,请按照以下标准顺序完成环境准备与依赖安装:
-
创建隔离的虚拟环境:
python3 -m venv .venv -
激活虚拟环境:
# macOS / Linux source .venv/bin/activate # Windows PowerShell .venv\Scripts\Activate.ps1 -
编写
requirements.txt并明确指定版本号:requests==2.31.0 pydantic==2.6.4 pyyaml==6.0.1 pandas==2.2.1 openpyxl==3.1.2 -
在激活的环境中执行安装:
pip install -r requirements.txt
七、总结
Python 库的掌握不在于全盘罗列,而在于建立以工程质量为导向的分层习惯:
- 熟练使用
pathlib、json、logging、subprocess等标准库,让你的基础代码具备极强的可移植性与自包含能力; - 在网络通信选用
requests/httpx、数据清洗选用pydantic、数据处理选用pandas,借助成熟生态的大量测试用例和社区经验,快速攻克业务核心; - 始终通过
venv与版本锁定机制管控项目,确保代码在任何机器上都能按预期可靠运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









