

为什么在Python命令行粘贴多行代码会报错或只执行最后一行
在日常使用 Python 时,许多人都遇到过这样的困惑:在编辑器中写好的一段逻辑完整的代码,直接复制并粘贴进终端的 Python 命令行界面(即以 >>> 开头的交互式解释器 REPL),屏幕上要么立刻弹出一长串刺眼的 IndentationError 或 SyntaxError,要么一闪而过只输出了最后一行表达式的结果,中间的代码似乎完全没有运行。造成这种现象的根源并非代码本身有逻辑错误,而是原生 Python 交互式命令行与脚本文件执行机制之间的本质差异。
终端多行粘贴的两大典型翻车现场
在深入底层机制之前,我们可以先观察两种最常见的异常表现,以便建立直观认识。
现象一:缩进报错与代码结构被强行拆散
假设我们有一段包含循环或条件判断的代码,由于在代码中习惯性加入了空行来区分逻辑块,复制后直接粘贴:
def greet_users(names):
    print("开始处理用户名单...")

    for name in names:
        print(f"你好, {name}!")

greet_users(["张三", "李四"])
在原生 Python 3.12 及更早版本的交互式终端中粘贴上述代码,终端几乎必然会抛出如下错误:
>>> def greet_users(names):
...     print("开始处理用户名单...")
...
>>>     for name in names:
  File "<stdin>", line 1
    for name in names:
IndentationError: unexpected indent
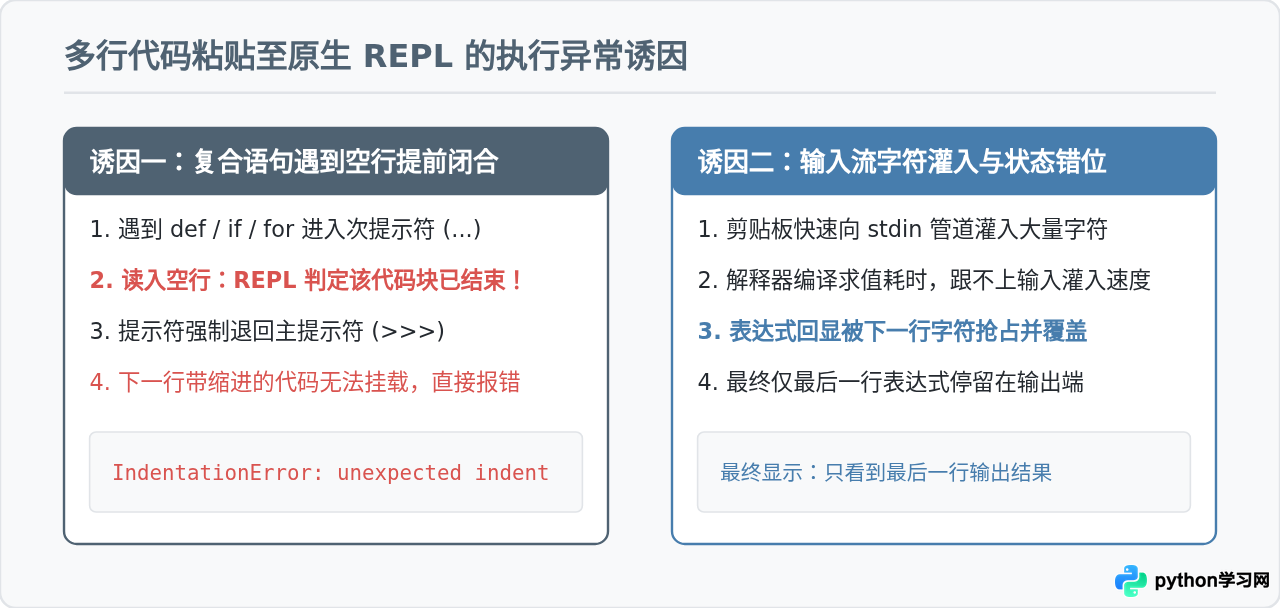
原本属于函数体内部的 for 循环,在提示符从 ... 突然变回 >>> 之后,被系统当成了一条全新的顶级语句,从而触发了“非预期的缩进”异常。
现象二:中间语句悄无声息,只输出了最后一行的计算值
另一种常见情况是连续粘贴多个独立的数据处理步骤或表达式:
width = 20
height = 10
area = width * height
perimeter = 2 * (width + height)
perimeter
粘贴进去后,终端只输出了一个数值 60。许多初学者会怀疑前面的变量是否根本没有赋值或没有执行。虽然在这个简单例子中变量其实已存入命名空间,但若其中穿插了多段函数调用或需要查看的中间过程,读者往往会发现控制台打印缺失、上下文断层,甚至部分被换行冲刷的命令直接丢失。
为什么会这样:原生 REPL 的核心运作机理
要彻底明白上述异常,我们需要拆解 Python 交互式解释器的三个底层设定:
1. REPL 并非脚本编译器,而是单语句读取循环
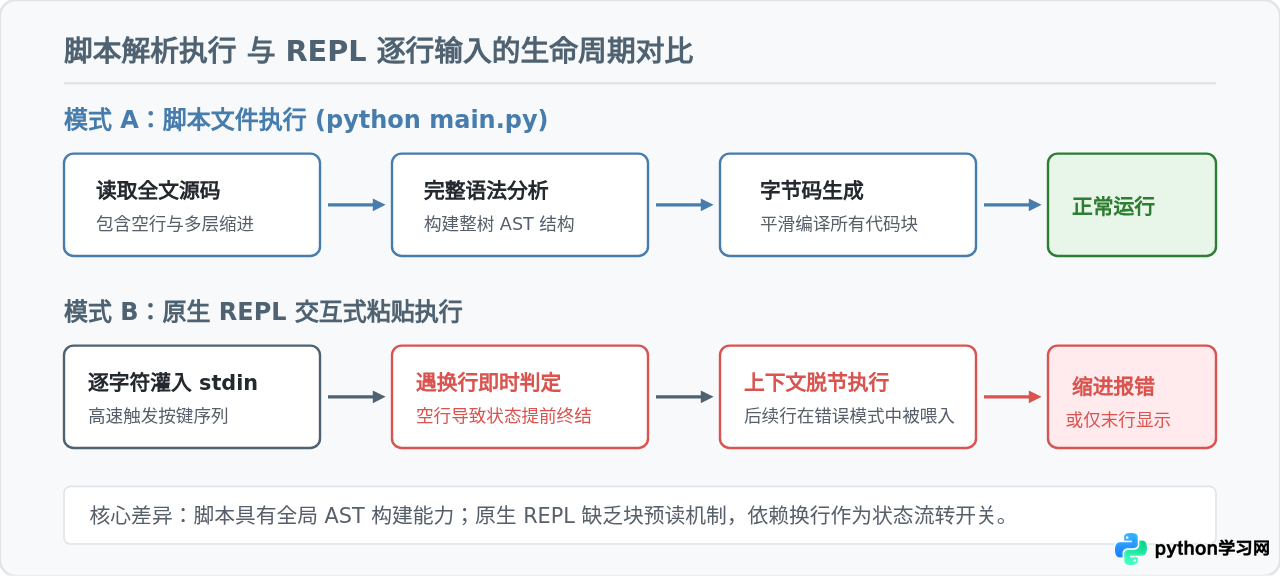
REPL 代表 Read-Eval-Print Loop(读取-求值-输出循环)。在脚本执行模式(例如运行 python script.py)下,解释器会先一次性读取整个文件的所有文本,建立完整的抽象语法树(AST),然后进行编译与运行。在脚本中,函数体内部出现空行完全合法,因为解析器能够纵观全文确定缩进层级。
但在交互式 REPL 中,解释器不知道你后面还有多少行代码。它必须遵循一套确定性的“结束标记”规则:
- 在主提示符
>>>下,每次按回车,如果是一条简单的单行语句(如a = 1),它会立即执行并回到>>>。 - 如果输入的是复合语句头(以冒号结尾,如
def func():),它会切换到次提示符...等待后续代码块。 - 在次提示符
...下,解释器唯一能够判定复合语句已结束的标志,就是一个无任何字符的完全空白回车。
当你复制代码并粘贴时,代码中间的空行被终端当成了一个空回车送入 stdin,REPL 便立即判定该函数已经结束。紧接在后面的缩进行重新由主提示符 >>> 接收,顶级作用域下不允许出现未配对的缩进,于是立即引发 IndentationError。
2. 终端模拟器的“按键轰炸”效应
在操作系统层面,向终端窗口执行“粘贴”操作,本质上是由终端模拟器把剪贴板中的字符序列极快地一个一个写入标准输入(stdin),并把每个换行转换成回车键信号发送给前台进程。这就如同一个打字极快的人在一毫秒内按下了几十次按键。
当 Python 正在执行某一行的计算或更新状态时,后续的代码字符已经在管道中排队。如果前面的代码触发了语法错误导致退出代码块,排在后面的语句就会在完全错乱的上下文中被强行喂给解释器,形成滚雪球式的连续报错。
3. 交互式求值 vs 脚本静默执行
在脚本文件中,单独写一行变量名 area 不会产生任何屏幕输出,必须显式调用 print(area)。但在交互式 REPL 中,为了便于调试,解释器会对未被赋值语句捕获的单行表达式自动求值并打印(相当于隐式调用了 sys.displayhook)。
当多行代码连续粘贴时,赋值语句本身是不返回值的;只有单独的表达式才会在当前行输出。如果在粘贴的多行中只有最后一行是表达式,或者前面的表达式输出被终端快速滚屏刷新掩盖,读者看起来就会觉得“只执行了最后一行”。
行之有效的四种解决办法
明确了根本原因之后,我们在需要运行多行代码时,可以根据手头的工作环境采取以下四种行之有效的方法。
方法一:括号包裹法(利用 Python 的隐式行延续)
Python 语法规范中明确规定:在小括号 ()、中括号 [] 或大括号 {} 内部,换行符会被自动忽略,直到遇到闭合括号为止。这意味着,在括号包裹的范围内,即便包含空行,REPL 也绝不会将其判定为语句结束!
对于长表达式、多行字典、列表推导式或拼接语句,最简便的防御性技巧就是用括号括起来:
# 用小括号包裹多行逻辑
(
    total := sum([
        10, 20, 30,

        40, 50
    ])
)
print(total)
只要最外层的小括号尚未闭合,无论你中间按多少个回车或留出多少个空行,REPL 的提示符都将稳定停留在 ... 状态,不会发生提前截断。
方法二:清理代码块中的全部空行后再粘贴
如果需要在原生命令行中临时定义一个多行函数或类,粘贴前务必检查函数体内部是否含有空行。将所有空行删除,确保从 def 到最后一行为止每一行都有代码或缩进:
def greet_users(names):
    print("开始处理用户名单...")
    for name in names:
print(f"你好, {name}!")粘贴完成后,手动敲下两次回车(第一次确认最后一行代码,第二次触发空行以结束复合语句)。此时函数将成功编译,随后即可在 >>> 下正常调用。
方法三:改用专为交互设计的 IPython 或 Jupyter
对于数据科学或日常频繁调试代码的开发者,原生 Python 终端的功能本身较为简陋。推荐安装并使用 IPython:
pip install ipython
ipython
IPython 具备成熟的 AST 块感知能力与专用的多行粘贴模式:
- 直接按快捷键粘贴:IPython 会智能拦截并统一处理整段文本,代码中的空行不会导致提前断句。
- 使用
%paste魔术命令:直接从系统剪贴板读取内容并原样执行,自动修剪首尾空白和多余缩进。 - 使用
%cpaste进入交互式粘贴模式:可以连续粘贴多段代码,输入--标记结束并统一运行。
方法四:将多行代码保存为脚本文件,或使用 python -c
当代码行数超过 10 行且包含复杂的分支逻辑时,继续在交互式命令行中粘贴不仅容易出错,而且无法进行代码版本留存。此时最规范的做法是将代码写入一个临时 .py 文件:
# 在终端中快速创建并执行
cat << 'EOF' > test_run.py
def process_data():
    items = [1, 2, 3]

    return [x * 2 for x in items]

print(process_data())
EOF

python test_run.py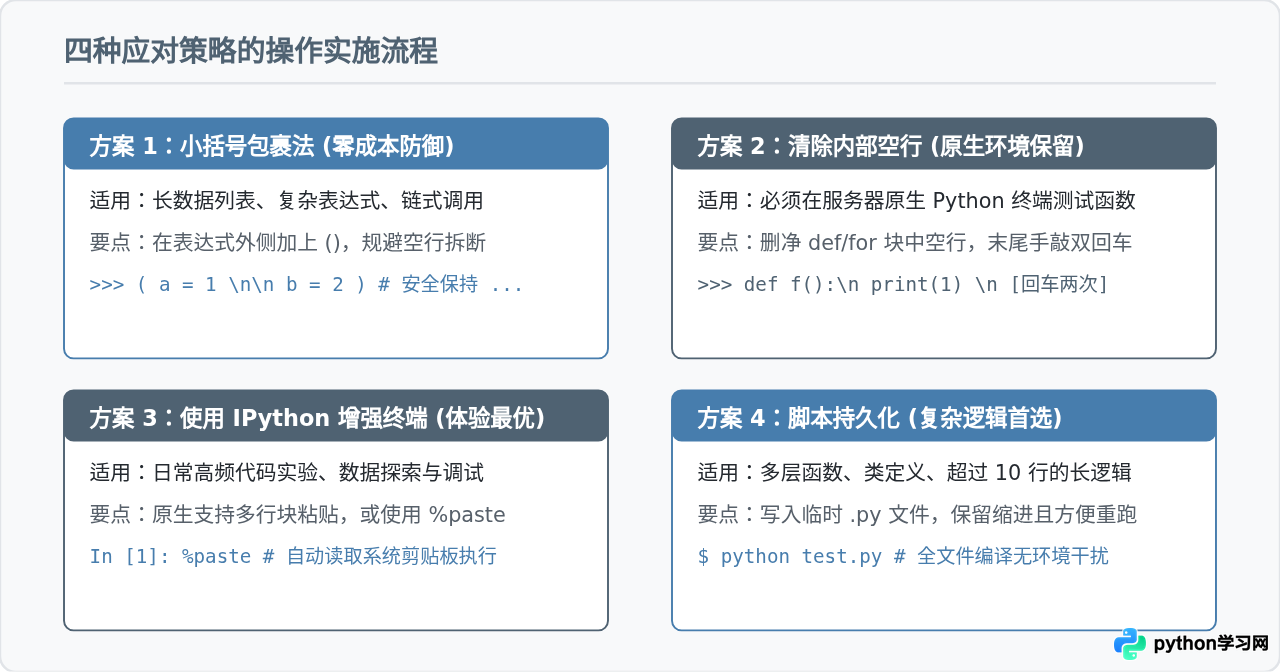
Python 3.13 的重大进化:全新交互式解释器
值得特别关注的是,Python 官方团队早已意识到了原生 REPL 在多行代码粘贴和编辑体验上的痛点。从 Python 3.13 开始,Python 官方正式引入了基于 PyRepl 的全新交互式解释器:
- 智能多行粘贴:当检测到通过剪贴板大段灌入代码时,新版 REPL 不再将其当成单次按键机械触发,而是能够整块感知多行代码块,函数内部的空行不再导致提前截断。
- 全彩语法高亮:在命令行输入与编辑时即可实时看到关键字与变量的颜色区分。
- 多行交互式导航:支持使用上下方向键跨行移动光标并直接修改多行代码块内部的内容,无需像过去一样整段重敲。
版本提示:如果你的开发环境已经升级到了 Python 3.13 或更高版本,直接在终端中粘贴多行带空行的代码通常已经不会报错;但在 Python 3.12 及更旧版本(或在不支持高阶终端特性的精简容器、Windows 经典 cmd 中),前文所述的逐行读取规则依然生效。
总结与场景决策指南
在 Python 命令行粘贴多行代码会报错或只执行最后一行,本质上是“交互式单行求值状态机”与“剪贴板整段快速灌入”之间的失配。理解了 REPL 依靠空行判定块结束、以及终端快速输入管道的运作逻辑,就能在遇到异常时快速定位问题。
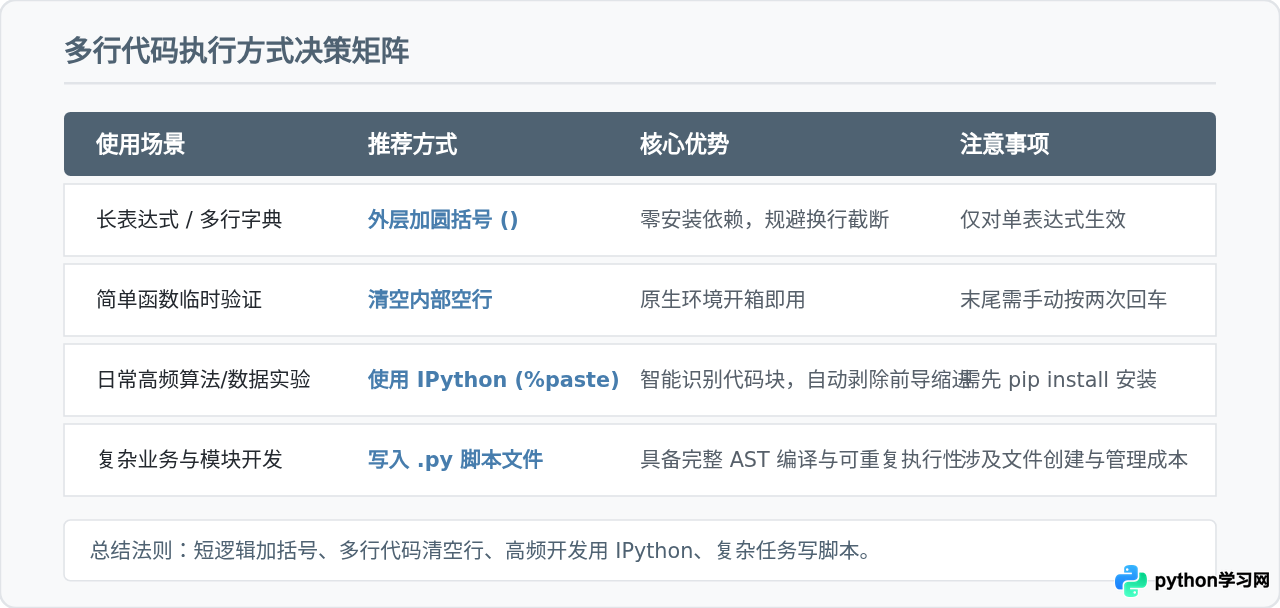
实际开发中,记住一个简要原则:对于简单的表达式利用小括号保护;在原生终端中测试函数时顺手清空空行;对于日常的重度交互式调试,首选 IPython 或升级至 Python 3.13;面对多行长代码时,果断保存为脚本执行。如此便能在保证开发效率的同时,彻底远离命令行粘贴报错的烦恼。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









