

Python Matplotlib雷达图中文标签乱码怎么解决

plt.rcParams['font.sans-serif'] 指定系统中真实安装的中文字体名(如 Windows 下的 SimHei、macOS 下的 PingFang SC 或 Linux 下的 Noto Sans CJK SC),并同步设置 plt.rcParams['axes.unicode_minus'] = False 以恢复负号正常渲染;在多环境部署场景中,亦可直接使用 FontProperties(fname=...) 指向具体字体文件进行精准注入。
一、现象与根因:为什么雷达图的维度标签会变成方块?
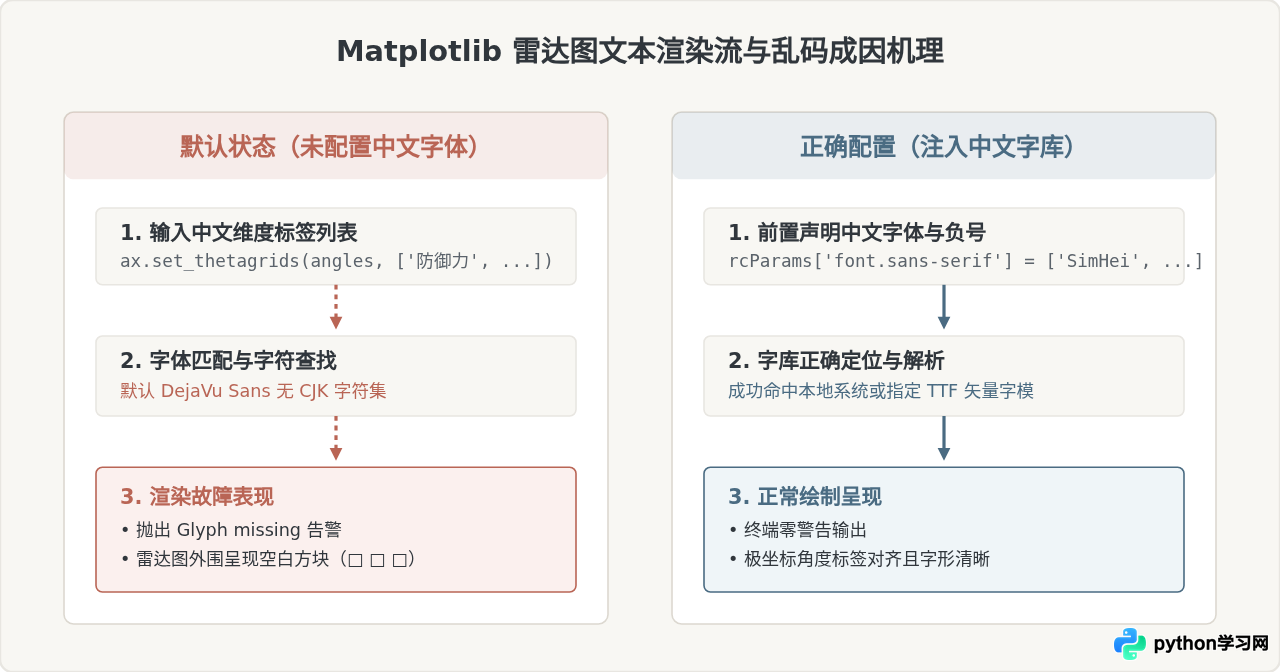
在数据分析与可视化项目中,雷达图(极坐标折线填充图)常用于评估个人多维能力、产品各指标评分或模型性能指标。使用 Matplotlib 绘制雷达图时,极坐标系的轴标签通常通过 ax.set_thetagrids() 或 plt.thetagrids() 进行配置。当传入中文标签列表(如 ['攻击力', '生存力', '机动性'])时,运行终端往往会抛出一长串警告:
UserWarning: Glyph 25915 (\N{CJK UNIFIED IDEOGRAPH-653B}) missing from font(s) DejaVu Sans.
  plt.savefig('radar.png')
同时,最终生成的雷达图外周维度处,原本应当清晰展现的汉字被替换成了一个个空心矩形方块(俗称“豆腐块”/ Tofu)。
这一现象的根本原因在于 Matplotlib 的默认字体回退机制。Matplotlib 默认使用的无衬线英文字体是 DejaVu Sans,该字体库为了保持体积小巧,并未收录 CJK(中日韩统一表意文字)Unicode 编码区间的字形轮廓(Glyphs)。当图形引擎试图将汉字字符光栅化为像素时,由于在当前活动字体中查找不到对应码位,只能退化为缺失字符指示符(即方块)。
二、最简解决法:全局配置 rcParams 与负号修正
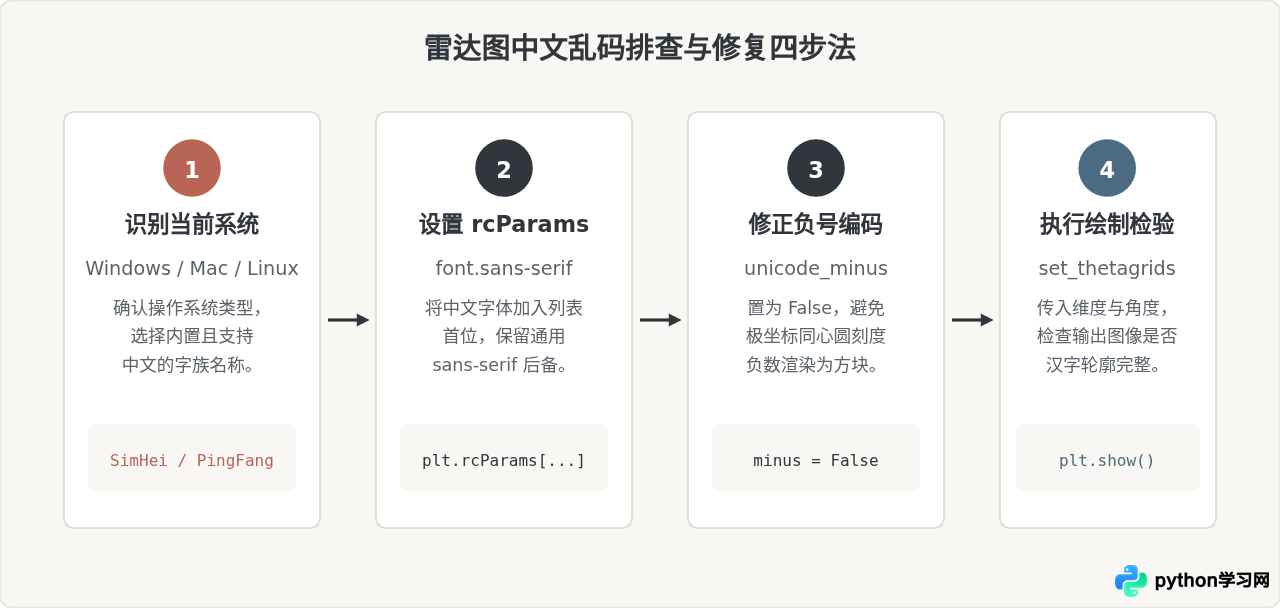
在大多数单机脚本、Jupyter Notebook 或个人数据分析场景中,最为直接且不破坏原有业务逻辑的解决方案是通过修改全局运行时参数字典 matplotlib.rcParams。
1. 关键设置项
解决乱码必须成对配置以下两行代码:
plt.rcParams['font.sans-serif']:指定无衬线字体的候选优先列表。Matplotlib 会按照从左到右的顺序在系统中检索可用字体,直到找到收录有所需汉字的字体。plt.rcParams['axes.unicode_minus'] = False:Matplotlib 默认使用 Unicode 编码的负号(Minus Sign,U+2212)。然而不少常见中文字体只收录了 ASCII 编码的连字符减号(Hyphen-Minus,U+002D),若不关闭此项,雷达图上的负数刻度值仍可能出现方块乱码。
2. 典型跨平台通用配置代码
为了保证脚本能在不同团队成员的机器上平滑运行,建议在代码头部以回退列表的形式声明字体:
import numpy as np
import matplotlib.pyplot as plt

# 跨平台中文无衬线字体回退序列
plt.rcParams['font.sans-serif'] = [
    'SimHei',             # Windows 首选(黑体)
    'Microsoft YaHei',    # Windows 备选(微软雅黑)
    'PingFang SC',        # macOS 首选(苹方-简)
    'Heiti SC',           # macOS 备选(黑体-简)
    'Noto Sans CJK SC',   # Linux / Docker 常见(思源黑体)
    'WenQuanYi Micro Hei',# Linux 备选(文泉驿微米黑)
    'sans-serif'
]

# 正常显示负号(避免出现减号乱码方块)
plt.rcParams['axes.unicode_minus'] = False
3. 完整雷达图可执行范例
以下是包含数据闭合与中文极坐标刻度绑定的完整示例代码:
import numpy as np
import matplotlib.pyplot as plt

# 1. 配置中文字体
plt.rcParams['font.sans-serif'] = ['SimHei', 'PingFang SC', 'Microsoft YaHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 2. 准备指标与数据
categories = ['输出能力', '生存能力', '机动灵活性', '续航持久', '团队协同']
values = [85, 70, 90, 65, 80]
num_vars = len(categories)

# 3. 计算极坐标角度并闭合多边形
angles = np.linspace(0, 2 * np.pi, num_vars, endpoint=False).tolist()
values_closed = values + [values[0]]
angles_closed = angles + [angles[0]]

# 4. 创建极坐标子图
fig, ax = plt.subplots(figsize=(6, 6), subplot_kw=dict(polar=True))

# 绘制折线并填充背景多边形
ax.plot(angles_closed, values_closed, color='#B96555', linewidth=2)
ax.fill(angles_closed, values_closed, color='#B96555', alpha=0.25)

# 5. 关键步骤:设置雷达图中文维度标签
# angles * 180 / np.pi 将弧度转换为极坐标系所需的角度值
ax.set_thetagrids(np.array(angles) * 180 / np.pi, categories, fontsize=11)

# 设置极径范围与网格样式
ax.set_ylim(0, 100)
ax.grid(color='#DCD8D0', linestyle='--', linewidth=0.8)

plt.title('技术团队成员综合能力画像', size=14, y=1.08)
plt.tight_layout()
plt.savefig('radar_chart_zh.png', dpi=300)
plt.close()
三、跨操作系统字族兼容与精确定位
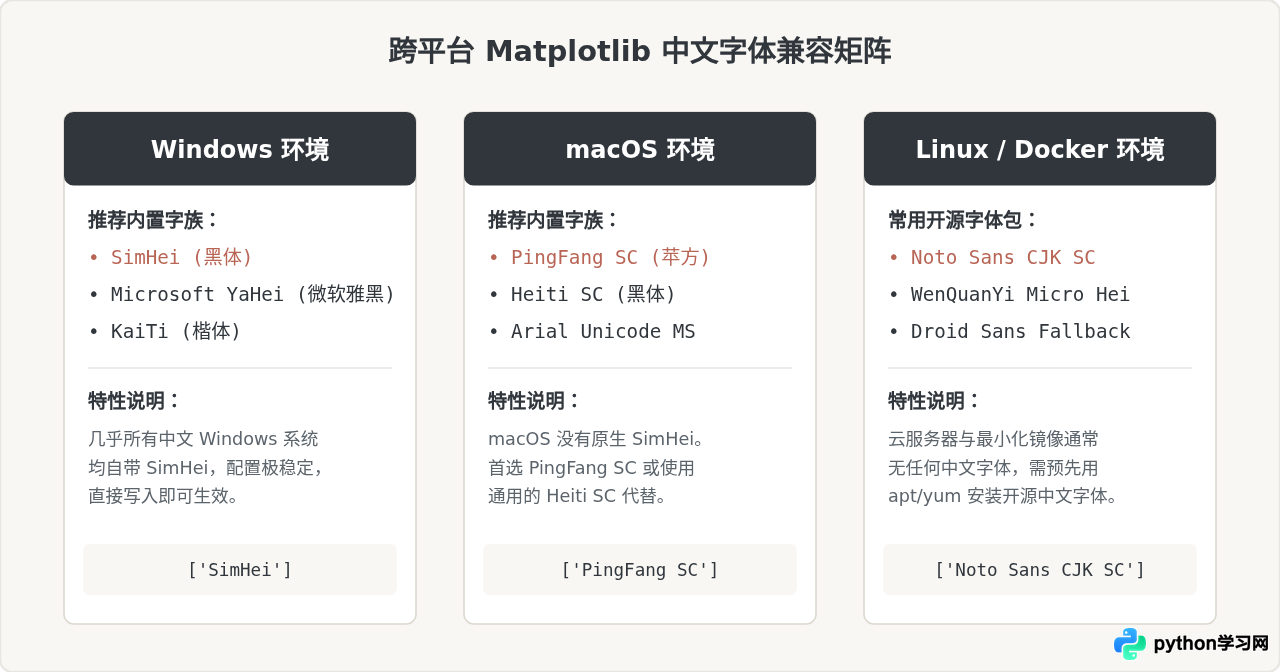
许多初学者在配置 rcParams['font.sans-serif'] = ['SimHei'] 后发现依然乱码,原因往往是在 macOS 或 Linux 上直接复制了 Windows 教程中的代码。不同操作系统预装的中文字体名称差异显著。
排查当前环境已加载的可用字体
若不确定当前执行环境中究竟有哪些中文字体已被 Matplotlib 捕获,可运行以下检测代码打印清单:
from matplotlib import font_manager

# 检索 Matplotlib 当前已识别的所有中文字族
available_fonts = set()
for font in font_manager.fontManager.ttflist:
    # 筛选包含常用中文关键词的字体名
    if any(keyword in font.name.lower() for keyword in ['hei', 'song', 'kai', 'yuan', 'pingfang', 'cjk', 'yahei']):
        available_fonts.add(font.name)

print("当前系统可用中文字体:", sorted(list(available_fonts)))
四、高可靠方案:使用 FontProperties 直接加载外部字体文件
在持续集成(CI/CD)、无头服务器、Docker 镜像或对外分发的 Python 项目中,无法假设宿主机一定预装了特定的系统字体。修改全局 rcParams 还可能意外影响项目内其他图表的英文字体排版风格。
此时更为稳妥的做法是将开源免费商用的 .ttf 或 .otf 字体文件(如 Source Han Sans / 思源黑体 或 Smiley Sans / 得意黑)打包在项目仓库内(例如 assets/fonts/custom_font.ttf),然后通过 FontProperties 显式指定:
import os
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.font_manager import FontProperties

# 1. 指向项目内部的字体文件物理路径
font_path = os.path.join(os.path.dirname(__file__), 'fonts', 'NotoSansSC-Regular.ttf')
my_font = FontProperties(fname=font_path, size=11)

# 2. 准备数据
categories = ['需求分析', '架构设计', '代码质量', '测试覆盖', '交付时效']
data = [92, 85, 88, 76, 95]
angles = np.linspace(0, 2 * np.pi, len(categories), endpoint=False).tolist()

fig, ax = plt.subplots(figsize=(6, 6), subplot_kw=dict(polar=True))
ax.plot(angles + [angles[0]], data + [data[0]], color='#B96555')
ax.fill(angles + [angles[0]], data + [data[0]], color='#B96555', alpha=0.2)

# 3. 关键点:在 set_thetagrids 中直接传入 fontproperties
# 注意:在较旧版本 Matplotlib 中可使用 fontproperties 参数;
# 若版本兼容受限,也可直接遍历 ax.get_xticklabels() 进行设置
lines, labels = ax.set_thetagrids(np.array(angles) * 180 / np.pi, categories)
for label in labels:
    label.set_fontproperties(my_font)

plt.title('软件交付效能雷达图', fontproperties=FontProperties(fname=font_path, size=14), y=1.08)
plt.show()
极坐标系中,set_thetagrids 的文字会默认贴紧最外层网格线。若文字较长,可通过调整子图边距或使用 ax.tick_params(pad=12) 适当拉开文字与雷达图外轮廓的间距,防止汉字边缘与坐标刻度线发生挤压或裁切。
五、配置后依然乱码?字体缓存清理与终验清单
有时即便正确安装了字体并配置了代码,运行依然报错。这通常是因为 Matplotlib 在首次初始化时会在用户根目录下生成一个字体索引缓存文件(fontlist-vXXX.json)。如果新字体是在缓存文件生成之后才安装到系统的,Matplotlib 不会自动感知到新增的字体文件。
1. 缓存文件清理步骤
- Linux / macOS 默认路径:
~/.cache/matplotlib/ - Windows 默认路径:
C:\Users\<用户名>\.matplotlib\
只需在上述路径中找到类似 fontlist-v330.json 的文件并将其删除,或者在 Python 交互环境中执行:
import matplotlib
import os

cache_dir = matplotlib.get_cachedir()
print("Matplotlib 缓存目录:", cache_dir)

# 删除缓存文件后重新运行代码,Matplotlib 会自动重建字体库索引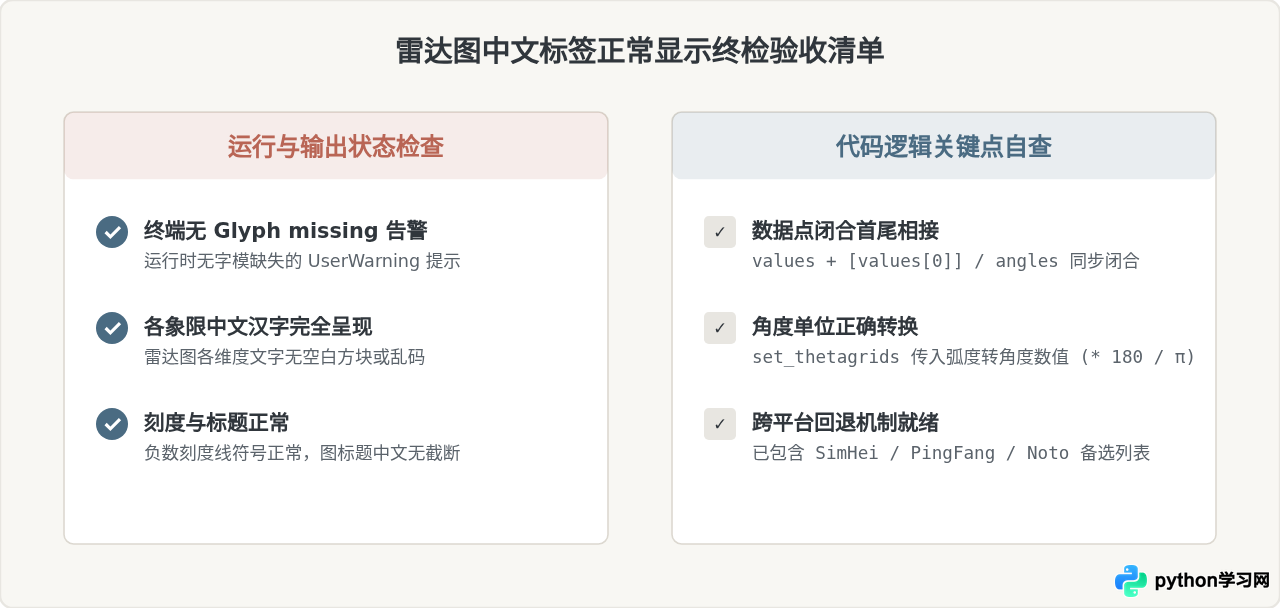
2. 总结
Matplotlib 雷达图的中文乱码问题是极坐标渲染引擎与系统默认英文字体不匹配导致的典型表现。通过在绘图前置阶段声明支持中文的 rcParams['font.sans-serif'] 列表、修正 unicode_minus,并在容器或独立部署中使用 FontProperties 指向字体文件,即可稳定根治标签方块乱码,产出专业、美观的数据可视化图表。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









