

Python代码化接口自动化与Postman/JMeter的选型对比

接口自动化测试选型的本质,是在团队工程能力、用例资产维护成本、测试执行效率与业务复杂度之间寻求平衡。Python代码化方案(通常指基于 pytest 与 requests/httpx 库搭建的测试工程)、Postman 与 Apache JMeter 分别代表了“工程代码驱动”、“交互式文档与轻量脚本协同”以及“高并发性能压测引擎”三种截然不同的设计哲学。选型的关键不在于寻找所谓全能工具,而在于厘清被测系统的调用链路深度以及团队回归测试资产的流转方式。
一、三类方案的设计定位与核心差异
评估工具前,需要先看其底层模型。Postman 以 HTTP 客户端界面为核心,通过图形化表单与基于 JavaScript 的前置/后置脚本处理鉴权与提取;JMeter 基于 Java 多线程模型设计,核心目标是用最小的线程调度开销模拟数以万计的并发请求;Python 代码化方案则直接将测试用例当做纯软件工程对待,利用标准测试框架的 Fixture 依赖注入、面向对象封装以及丰富的开源生态承载测试逻辑。
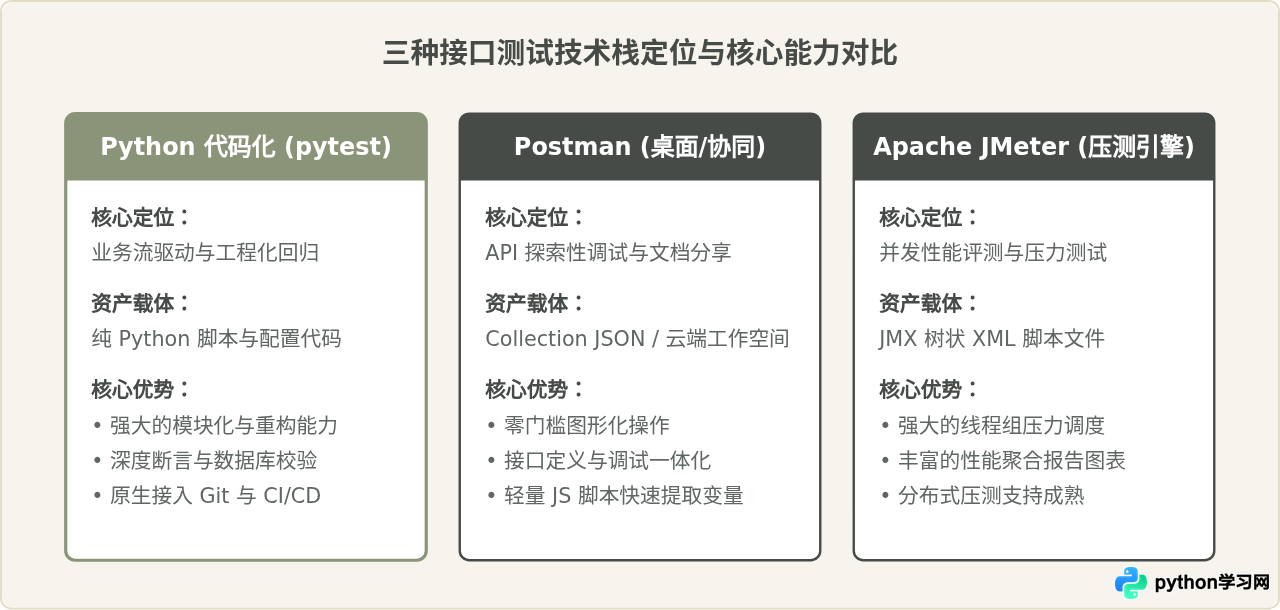
为了直观展现差异,下表汇总了各方案在实际交付中的关键特性:
| 评估维度 | Python 代码化 (pytest) | Postman (Newman) | JMeter |
|---|---|---|---|
| 上手门槛 | 中等(需掌握 Python 基础与测试库) | 低(可视化点选、即开即用) | 中低(GUI 配置元件与树状节点) |
| 复杂鉴权与加解密 | 极高(直接调用任意 Python 密码学库) | 受限(依赖 Pre-request Script 与有限 JS 库) | 一般(依赖 BeanShell/JSR223 Groovy 脚本) |
| 版本控制与多人协作 | 极佳(纯代码,Git 分支合并无压力) | 一般(JSON 导出易冲突,强依赖官方云工作空间) | 较差(JMX 为大型 XML,GUI 保存常产生脏提交) |
| 数据驱动与参数化 | 灵活(支持 YAML/JSON/数据库查询动态驱动) | 支持(Runner 支持 CSV/JSON,但无法动态查询) | 支持(CSV Data Set Config,扩展需额外元件) |
| 执行性能与吞吐量 | 适合单线程/多进程功能回归,不适合高并发压测 | 仅适合功能验证,批量运行资源开销偏大 | 极高(原生优化的高并发多线程网络调度) |
二、核心维度的深度横向考量
1. 复杂业务流与动态上下文传递
单接口的请求验证相对简单,但在真实业务场景中,自动化测试面对的往往是跨多个接口的状态流转。例如:调用登录接口生成动态签名 Token,接着调用下单一接口创建订单,从响应中提取订单号,再异步轮询支付网关状态,并在最后查询数据库确认库存扣减与流水日志。
在 Postman 中,这类上下文需要通过全局变量或环境变量(pm.environment.set)串联,遇到循环轮询或异步回调时,必须借助 postman.setNextRequest 在扁平的集合中跳跃执行,用例逻辑变得隐晦且极难单步调试。而在 JMeter 中,需要嵌套“While 控制器”、“JSON 提取器”和“JSR223 断言”,整个测试树深度迅速膨胀。
Python 代码化方案则能直接利用面向对象封装与标准控制流(如 while 循环、异常捕获、重试装饰器)完成上述逻辑,清晰直观:
# 典型的业务流上下文与数据库校验逻辑示例
import time
import pytest

def test_order_creation_and_inventory(client, db_conn):
    # 1. 创建订单
    order_res = client.post("/api/v1/orders", json={"item_id": 1024, "count": 2})
    assert order_res.status_code == 201
    order_id = order_res.json()["order_id"]

    # 2. 轮询订单处理状态
    timeout = 10
    start = time.time()
    while time.time() - start < timeout:
        status_res = client.get(f"/api/v1/orders/{order_id}")
        if status_res.json().get("status") == "COMPLETED":
            break
        time.sleep(1)
    else:
        pytest.fail("订单处理在规定时间内未完成")

    # 3. 校验数据库实际落库数据,完成闭环
    db_record = db_conn.query_one("SELECT stock FROM inventory WHERE item_id = 1024")
    assert db_record["stock"] >= 0
2. 脚本资产版本控制与多人协同
当自动化测试用例数量从数十条增长到数千条时,测试工程的维护成本远大于初次编写成本。版本控制的体验直接决定了团队能否规模化推进自动化:
- Python 代码化:用例是独立的
.py文件。多人协同完全遵照标准的 Git Flow 规范进行分支开发、创建 Pull Request、运行静态代码审查(Flake8/Black),代码冲突可以按行精确比对与合并。 - Postman:导出的 Collection 是一个体积庞大的单一 JSON 文件。当两名测试人员同时修改了集合中不同接口的入参时,Git 很难准确识别层级嵌套的 JSON 变更,常常引发合并冲突破坏文件结构。因此 Postman 更推荐使用其付费的云端工作空间协同,但这涉及企业数据合规与网络连通性问题。
- JMeter:其
.jmx格式是高度冗长的 XML 文件,包含了大量 GUI 渲染坐标、默认属性及元件层级。只要在 JMeter 界面中稍微拖拽或展开一个节点,就会导致成百上千行的 XML 结构发生微调,在 Git 中极易产生伪变更和冲突。
3. CI/CD 流水线集成与无头执行
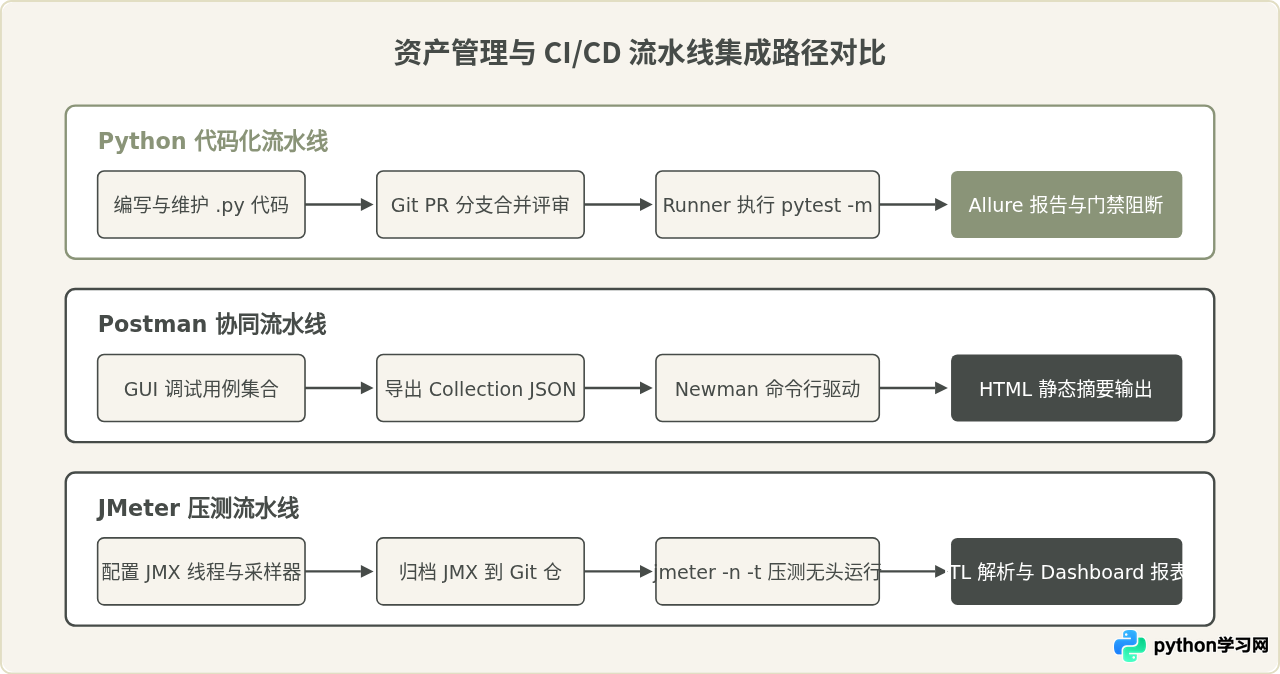
接口自动化的核心价值在于持续回归与质量门禁。三种方案接入流水线的模式存在显著差异:
三、常见混淆观点的理性辨析
在技术选型讨论中,经常出现一些流传甚广但不够严谨的说法。这些说法往往在特定前提下成立,但如果直接作为选型准则,容易导致项目后期陷入被动。
辨析 1:“JMeter 既能做接口功能测试,又能做压力测试,选它一套搞定全部最划算?”
分析:这种说法在项目规模极小、以性能压测团队为主导时看似合理。JMeter 的确具备 HTTP 请求采样器与响应断言,功能用例可以顺带复用为压测脚本。但当功能用例上升到几百个时,JMeter 缺乏灵活的代码复用机制,修改一个公共接口的出参可能需要批量修改几十个元件;同时,JMeter 在多线程设计上对复杂逻辑断言的调试体验远逊于代码断言。结论是:JMeter 应该专注于性能指标与容量评估,强行让其承载庞大的功能回归资产会导致维护成本过高。
辨析 2:“Postman 点点点就能发请求,写代码会严重拉低测试团队的产出效率?”
分析:这种说法在项目初期单接口探索与联调阶段是完全成立的。打开工具、填入 URL 和 Header、点击 Send,几秒钟就能拿到响应。然而,自动化测试的产出不等于“录入接口的速度”,而是“长期维护用例与精准定位缺陷的能力”。随着接口频繁变更,在 GUI 界面中逐个点击修改字段的工作量呈线性甚至指数级上升;而代码化方案通过 BaseAPI 封装,修改一处即可全局生效。代码化在初期有封装成本,但跨过平衡点后,其维护效率与执行稳定性显著超越纯界面操作。
辨析 3:“做代码化自动化就必须造一套复杂的‘自研测试框架’?”
分析:这是许多团队望而却步的主因。很多人将代码化误解为“从零写一套带 Web 界面、任务调度、报告解析的庞大系统”。现代 Python 生态已经高度成熟,基于标准的 pytest 插件体系(如 pytest-xdist 并发、allure-pytest 报告)加上 httpx 或 requests 即可构成完备轻量的工程,根本不需要重复造轮子。越是轻量规范的代码工程,其生命周期越长久。
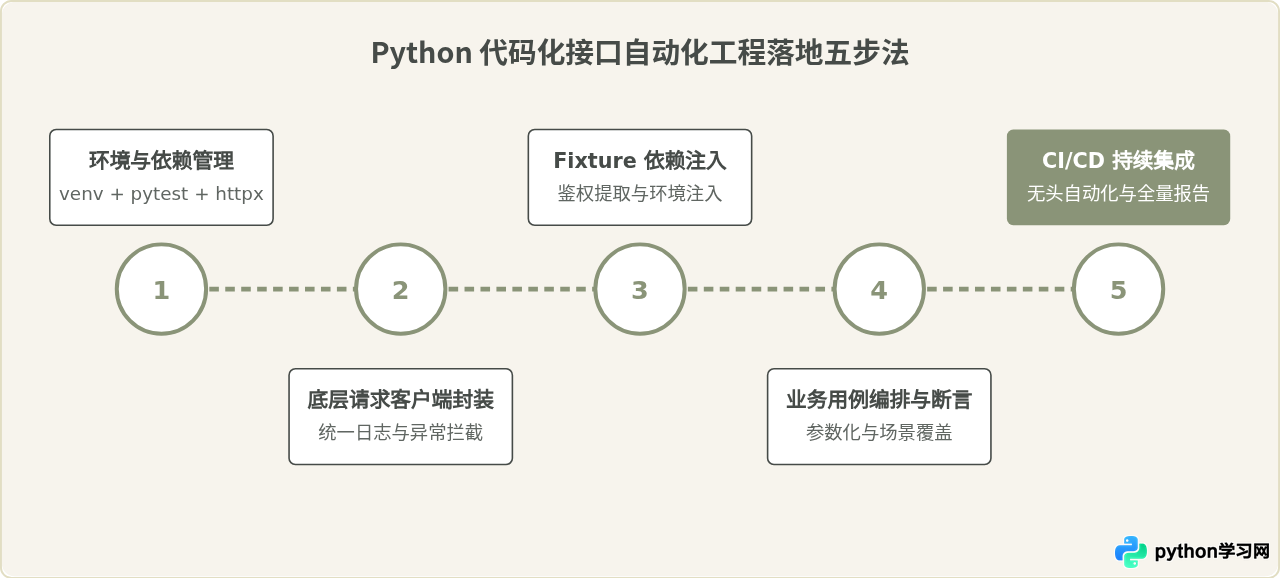
四、Python 代码化接口自动化的标准落地实践
若团队决定引入代码化接口自动化,应当遵循清晰的分层设计,避免将 URL、请求头和测试逻辑混杂在一起。
1. 环境与依赖准备
建议使用虚拟环境隔离依赖。核心依赖仅需安装 pytest、requests 及测试报告插件:
# 示例命令:创建虚拟环境并安装核心库
python3 -m venv .venv
source .venv/bin/activate
pip install pytest requests allure-pytest
2. 请求客户端封装(api_client.py)
统一封装 Session、基础 BaseURL、通用超时时间以及请求前后的结构化日志,避免在每个测试用例中写死配置:
# api_client.py
import requests

class APIClient:
    def __init__(self, base_url: str):
        self.base_url = base_url.rstrip("/")
        self.session = requests.Session()
        self.session.headers.update({"Content-Type": "application/json"})

    def set_auth_token(self, token: str):
        self.session.headers.update({"Authorization": f"Bearer {token}"})

    def request(self, method: str, endpoint: str, **kwargs):
        url = f"{self.base_url}/{endpoint.lstrip('/')}"
        # 统一设置 10 秒超时
        kwargs.setdefault("timeout", 10)
        return self.session.request(method, url, **kwargs)

    def get(self, endpoint: str, **kwargs):
        return self.request("GET", endpoint, **kwargs)

    def post(self, endpoint: str, **kwargs):
        return self.request("POST", endpoint, **kwargs)
3. 用例依赖注入与测试执行(conftest.py 与 test_api.py)
通过 pytest 的 fixture 实现 Token 预获取与会话管理,用例直接通过形参声明依赖:
# conftest.py
import pytest
from api_client import APIClient

@pytest.fixture(scope="session")
def client():
    # 初始化指向测试环境的客户端
    api = APIClient(base_url="https://api.example.com")

    # 获取全局测试认证 Token
    res = api.post("/auth/login", json={"username": "test_user", "password": "SafePassword123"})
    assert res.status_code == 200, "初始化登录鉴权失败"
    token = res.json().get("access_token")
    api.set_auth_token(token)

    return api
# test_user_flow.py
import pytest
@pytest.mark.parametrize("role,expected_code", [
("admin", 200),
("guest", 403),
])
def test_access_permission(client, role, expected_code):
"""验证不同角色在权限受限接口上的状态码响应"""
response = client.get(f"/api/v1/permissions?role={role}")
assert response.status_code == expected_code在命令行中运行测试并生成结果:
# 运行测试并输出简明信息
pytest -v -s test_user_flow.py
五、选型决策树与场景落地指南
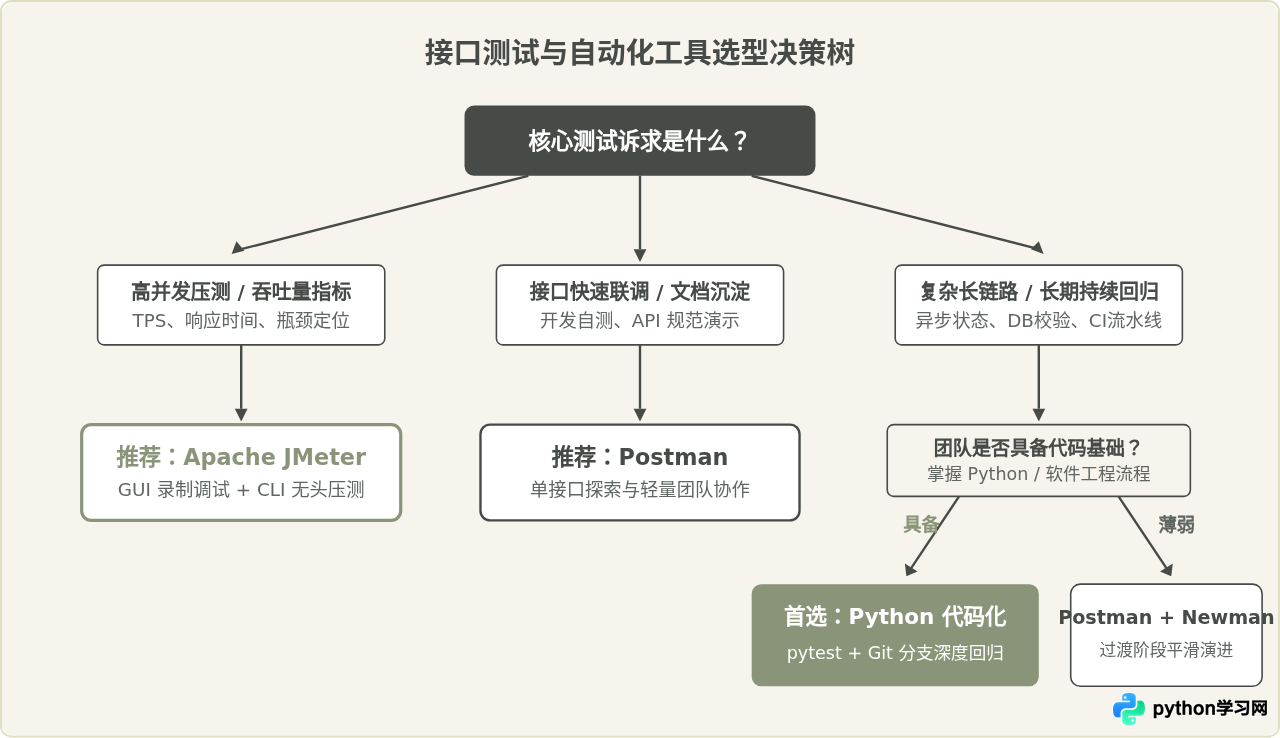
工具选型不应是非此即彼的排他竞争,而应建立在明确的业务现状之上。下图展示了从业务诉求、团队技能到交付场景的完整决策推导:
实践中的组合落地策略
成熟的技术团队往往不局限于单一工具,而是根据生命周期划分职责边界:
- 研发阶段联调与规范共享:后端开发人员使用 Postman 验证单个接口功能,导出示例集合作为文档交付给测试和前端。
- 主干自动化与质量门禁(核心回归):测试团队基于 Python (pytest) 构建工程化测试用例库,编写跨接口业务场景,接入 GitLab-CI / GitHub Actions,合并代码时自动运行,失败阻断部署。
- 性能基线与高负荷压测:专项性能测试人员提取核心高频接口,使用 JMeter 构建负载场景与分布式压测集群,持续监控系统在极限高压下的性能瓶颈与资源开销。
通过让 Postman 负责“快速探索”、Python 负责“稳固回归”、JMeter 负责“性能评估”,各工具在各自擅长的领域发挥最大价值,既避免了重复维护的冗余,也规避了强行用单一工具应对所有场景所带来的架构债务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









