

为什么很多高性能库用C编写而接口用Python提供

在现代科学计算、人工智能以及数据处理体系中,NumPy、SciPy、PyTorch、TensorFlow 和 OpenCV 等主流库几乎都采用了一种整齐划一的工程模式:底层重型计算模块用 C、C++ 或 Fortran 编写,而面向终端开发者的接口则采用 Python 提供。这种“外层 Python、内层 C”的组合并非历史偶然,而是软件工程在面临“极速硬件性能”与“极高开发效率”双重约束下达成的一种最优工程平衡。本文将从执行机制、内存桥接、并发控制以及生态演化等角度,具体拆解这套双层架构的运作逻辑与深层原因。
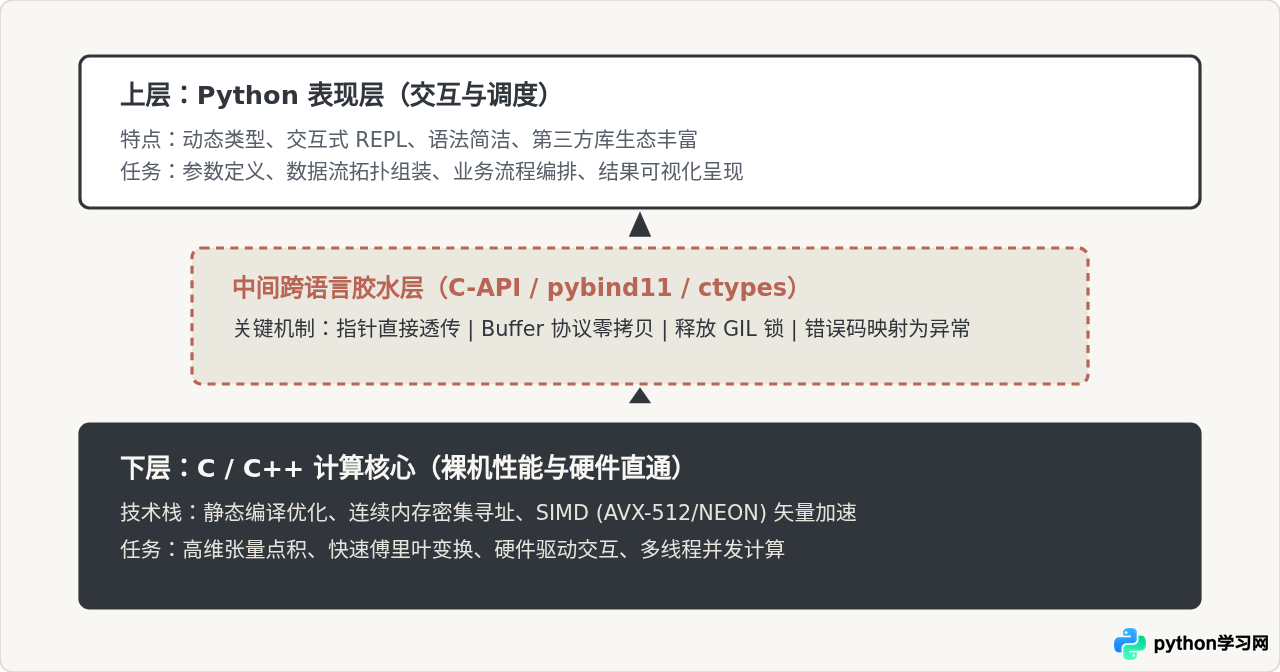
一、计算密集与交互表达:两类截然不同的语言职责
理解这种架构的前提,是认识到程序在不同层面上所承担的计算任务具有巨大的差异。根据阿姆达尔定律(Amdahl's law)以及经典的“90/10 准则”,一个计算系统往往将 90% 以上的运行时间消耗在不到 10% 的核心循环代码上;而其余 90% 的代码主要负责处理业务逻辑、参数解析、数据校验、流程分支与结果可视化。
若将全部代码都使用同一种编程语言完成,往往会顾此失彼:
- 纯 C/C++ 方案的工程代价: C 语言具备无开销抽象、直接控制物理内存、静态编译优化(如寄存器分配、循环展开、SIMD 向量化指令)等极致性能优势。但直接用 C 编写上层交互逻辑,开发者必须时刻应对手动内存分配、类型声明繁复、编译链接周期漫长等问题。算法工程师在探索网络结构或验证数学模型时,无法进行交互式探索,试错成本极高。
- 纯 Python 方案的性能瓶颈: Python 是一门解释型动态语言,所有变量在底层均为庞大的
PyObject结构体。一个简单的浮点数运算,Python 需要经历字节码分发、动态类型检查、拆箱取值、执行计算、装箱生成新对象并更新引用计数等多重步骤。在深度神经网络张量相乘或千兆图像卷积这种包含数十亿次循环的场景中,纯 Python 解释器的额外开销会导致程序运行速度相差数十倍乃至数百倍。
因此,高性能库的设计者选择将系统的两项职责明确解耦:将密集计算下沉到 C/C++,榨干 CPU/GPU 每一拍时钟周期;将控制流与胶水编排上升到 Python,提供极高的开发表达力。
二、内存零拷贝与 Buffer 协议:跨语言交互的高效基石
许多初学者往往有疑问:在 Python 与 C 之间频繁调用函数,是否会因为跨语言的数据序列化和对象复制导致性能骤降?如果每次传参都需要把百万个浮点数从 Python 复制一份到 C,那么双层架构的优势将不复存在。
高性能库得以成立的底层支撑,是 Python 官方在 CPython 层面提供的 缓冲区协议(Buffer Protocol) 以及连续内存管理方案。以经典的 numpy.ndarray 为例:
- 数据与视图分离: NumPy 的数组对象在 Python 视角下是一个普通的 Python 对象,但它内部仅仅包含形状(shape)、步长(strides)、数据类型(dtype)等小巧的元数据;其真正的数值矩阵,是底层一块纯净、连续的 C 语言堆内存块(
void* data)。 - 首地址直接传递(零拷贝): 当用户在 Python 中调用
np.dot(matrix_a, matrix_b)时,Python 解释器只负责检查参数维度是否合法,随后便将两个矩阵底层指向连续 C 内存的裸指针(Raw Pointers)直接提取出来,作为实参传递给底层经过汇编级调优的 BLAS 库(如 OpenBLAS、Intel MKL)。 - 就地修改与视图共享: 切片操作(如
b = a[::2])在 Python 中只是创建了一个改变了步长与偏移量的新元数据头部,底层的 C 数组内存完全共享,毫秒级的跨语言调用即可操纵上百兆字节的物理数据。
// 概念示意:底层 C 语言接收来自 Python Buffer 协议的数据结构
typedef struct {
    void*  data_ptr;    // 直接指向连续原生内存首地址,无需数据反序列化
    int    ndim;        // 维度数量
    long*  shape;       // 各维度尺寸
    long*  strides;     // 内存步长(字节级寻址)
} C_TensorView;

void compute_matrix_gemm(C_TensorView* a, C_TensorView* b, C_TensorView* out) {
    // 纯粹的 C/C++ 密集并行计算,无需调用任何 Python 解释器 API
    #pragma omp parallel for
    for (int i = 0; i < a->shape[0]; ++i) {
        // 利用 SIMD 指令执行连续内存运算...
    }
}
三、绕过 GIL:在 C 代码中释放真正的多核并行能力
CPython 解释器内建的全局解释器锁(Global Interpreter Lock,简称 GIL)是制约纯 Python 代码利用多核 CPU 的根本原因。在解释器层级,哪怕启动多个 Python 线程,同一时刻也仅能有一个线程在 CPU 核心上执行字节码,导致计算密集型任务在多线程下甚至比单线程还要慢。
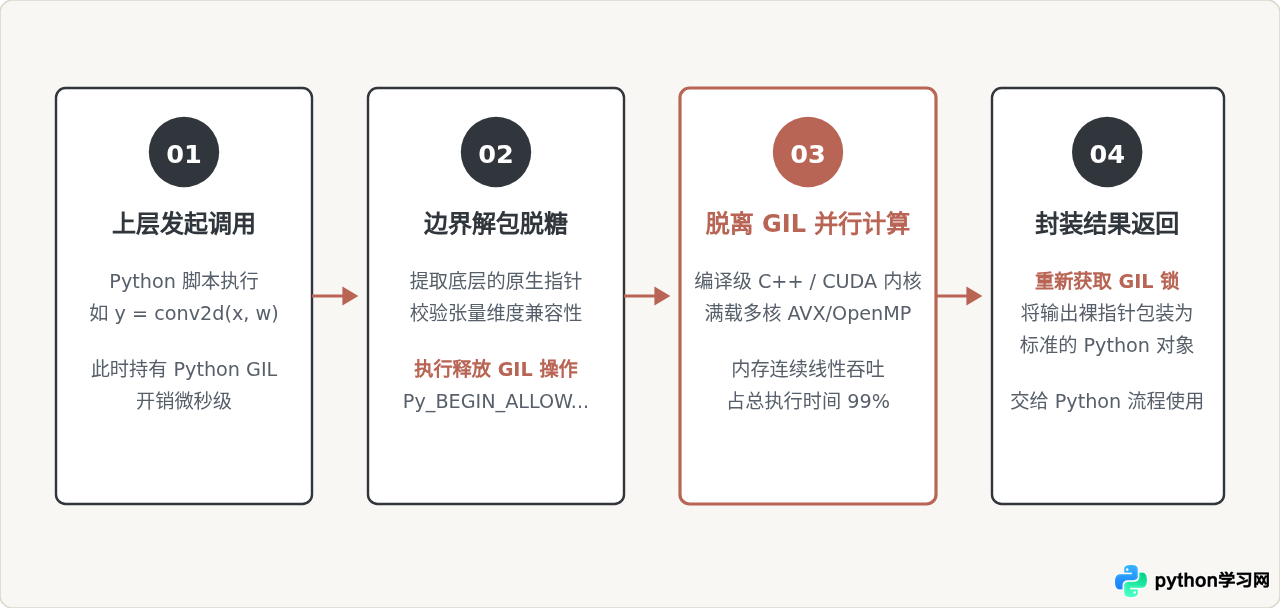
用 C 编写核心模块带来了另一个核心红利:主动释放 GIL。Python C-API 提供了宏定义 Py_BEGIN_ALLOW_THREADS 与 Py_END_ALLOW_THREADS。当 Python 接口把参数指针转交给底层 C 函数后,C 函数可以立刻声明释放 GIL。此时:
- 底层的 C 代码可以使用 OpenMP、POSIX 线程或 C++11
std::thread,直接将计算任务调度到系统的全部 CPU 物理核心上,实现真正的硬件满载运算。 - 在 C 底层计算的这几秒甚至几分钟内,主 Python 进程的解释器处于空闲状态,能够继续调度其他 I/O 线程(如网络请求、日志写入或界面刷新),完全不发生阻塞。
- 计算完成、准备生成 Python 返回对象前,底层函数再重新申请获取 GIL,安全地构建 Python 结果对象。
四、现代胶水绑定工具链的演变
在早期,编写 Python 的 C 扩展需要手动调用庞大繁琐的 Python.h 原生接口,手动管理引用计数 Py_INCREF / Py_DECREF,一旦发生遗漏就会导致内存泄漏或致命段错误(Segmentation Fault)。随着工具链的演进,跨语言交互的门槛大幅降低:
- ctypes 与 CFFI: 允许在纯 Python 代码中通过动态链接库(.so / .dll)直接调用导出的 C 符号,无需写编译扩展,适用于中小型轻量交互。
- Cython: 将带有静态类型标记的 Python 代码超集直接转译为高效的 C/C++ 代码,并由宿主编译器生成动态扩展模块,如 Scikit-learn 的大量算法模块便是基于 Cython 构建。
- pybind11 与 Nanobind: 现代 C++ 社区最主流的封装工具。它借助 C++14/17 的模板元编程技术,能够在纯 C++ 端以极具表达力的方式直接声明 Python 模块与函数绑定,自动处理复杂的数据类型映射与异常抛出。
// 现代主流封装方案:使用 pybind11 在 C++ 中暴露接口给 Python
#include <pybind11/pybind11.h>
#include <pybind11/numpy.h>

namespace py = pybind11;

// 高性能计算函数
py::array_t<double> fast_vector_add(py::array_t<double> input_a, py::array_t<double> input_b) {
    py::buffer_info buf_a = input_a.request();
    py::buffer_info buf_b = input_b.request();

    auto result = py::array_t<double>(buf_a.size);
    py::buffer_info buf_res = result.request();

    double* ptr_a = static_cast<double*>(buf_a.ptr);
    double* ptr_b = static_cast<double*>(buf_b.ptr);
    double* ptr_r = static_cast<double*>(buf_res.ptr);

    // 释放 GIL 并进入底层硬件循环
    py::gil_scoped_release release;
    for (size_t i = 0; i < buf_a.size; ++i) {
        ptr_r[i] = ptr_a[i] + ptr_b[i];
    }
    // 离开作用域时自动恢复 GIL
    return result;
}

PYBIND11_MODULE(fast_math, m) {
    m.doc() = "C++11 实现的高性能向量计算扩展";
    m.def("fast_vector_add", &fast_vector_add, "矢量快速相加");
}
五、架构权衡与技术方案的边界
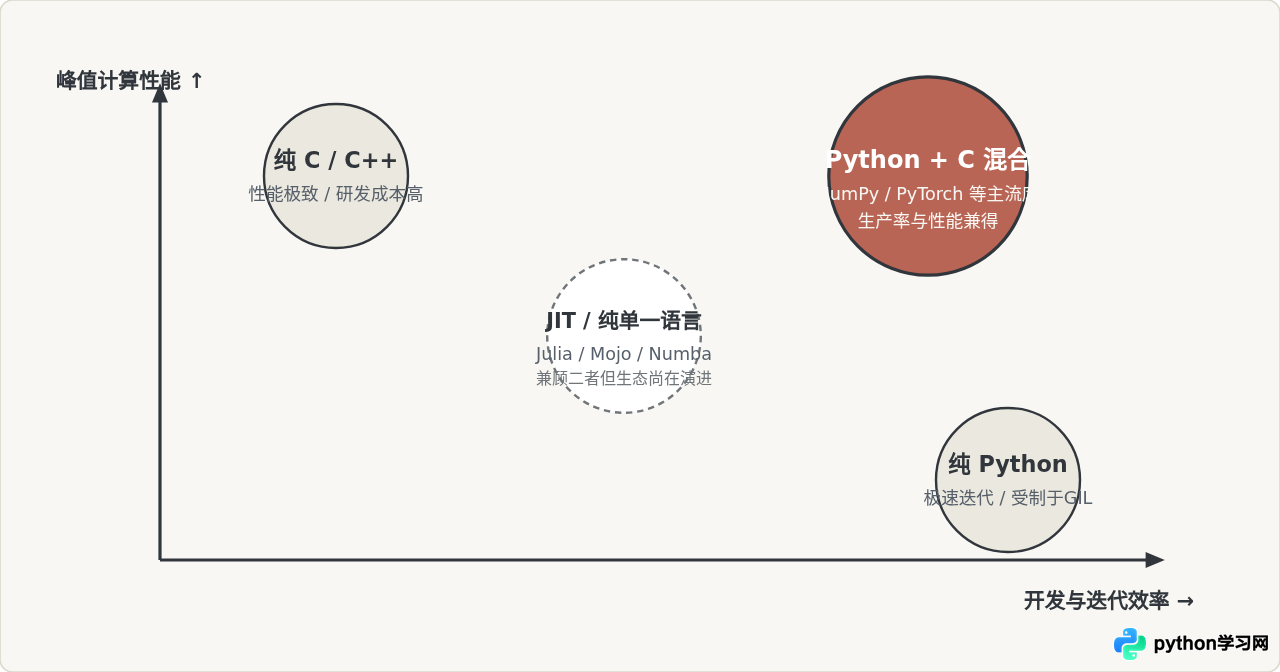
软件架构设计本质上是取舍的艺术。将不同语言组合使用并非毫无代价,理解其优势与局限,才能在实际研发中做出正确的技术选型。
1. 什么时候“Python + C”架构并不适用?
- 微操作极度频繁的场景: 跨语言调用本身具有微秒级别的进入与退出开销。如果你的业务逻辑需要在 Python 中循环调用一千万次底层 C 函数,且每次传入的仅是单个标量数字,那么跨语言调用的上下文切换成本将完全吃掉 C 语言的提速收益。此时必须将循环整体搬入 C,或者使用纯编译方案。
- 全链路微秒级低延迟系统: 在高频量化交易(HFT)等场景中,纳秒级的抖动与执行确定性至关重要。Python 的垃圾回收(GC)和动态寻址会带来无法接受的长尾延迟,系统往往采用全栈现代 C++ 实现。
- 调试与发布复杂度上升: 纯 Python 代码具有极强的跨平台通用性,单靠
pip install即可无缝运行;而引入 C 扩展后,库的维护者必须针对不同操作系统架构(Windows x86_64、Linux ARM64、macOS Apple Silicon)预编译并分发繁重的二进制 Wheel 文件,且多语言混编使得段错误的定位和调试工具链链条拉长。
2. 新兴技术对该模式的补充与替代
近年来,编程语言生态也在不断演化以探索更优的平衡点:
- Rust 替代 C/C++(PyO3): 许多新一代高性能 Python 工具(如 Polars、Ruff、Pydantic v2)选择使用 Rust 编写底层核心,再通过 PyO3 导出 Python 接口。这在保留 C 级性能的同时,借助编译期生命周期检查解决了 C/C++ 常见的心智负担与内存越界隐患。
- Julia 与 Mojo: 试图打破“两种语言问题(The Two-Language Problem)”,期望以一门统合语言既能拥有 Python 般的表达力,又能直接编译生成机器码以获取底层硬件吞吐能力。不过由于现有基于 Python 的工业界生态(模型权重、数据处理协议、社区资源)极其庞大,Python + C/C++ 架构在相当长一段时期内仍是工业界事实上的行业标准。
六、总结与技术决策树
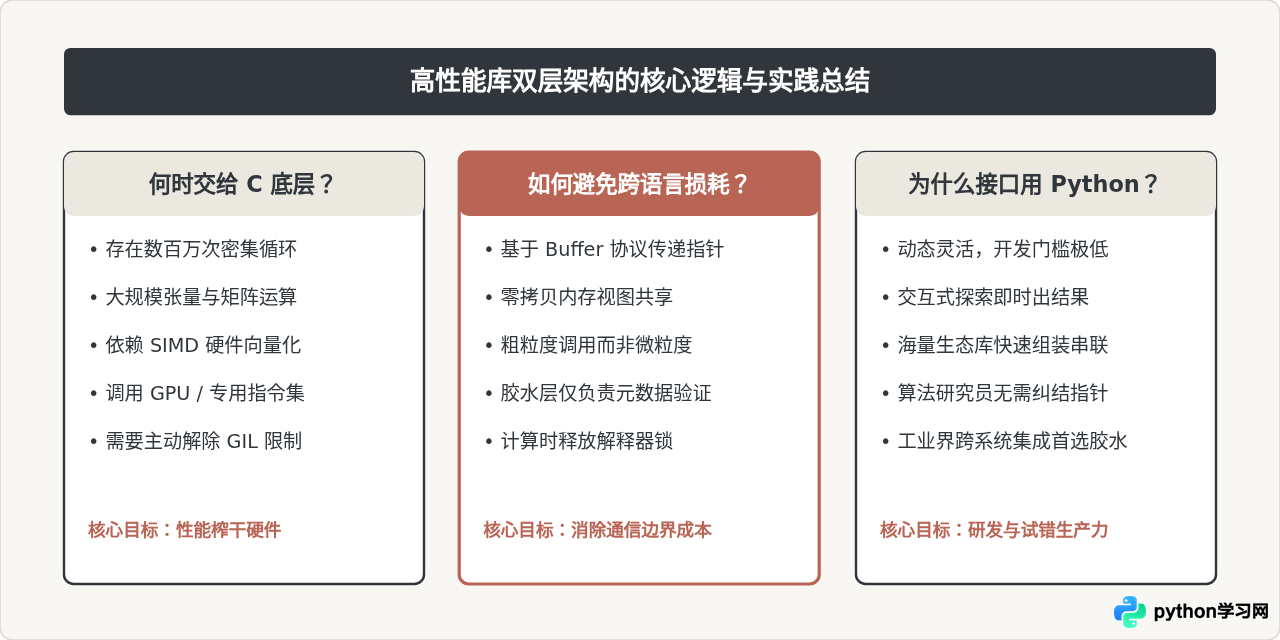
综上所述,很多高性能库采用“底层 C、外层 Python”的组合,本质上是在硬件物理极限与人类软件生产力之间做出的一种精密分工:把 1% 决定吞吐性能的热点循环托付给静态编译与连续物理内存,把 99% 的胶水组织逻辑留给心智负担极低的交互脚本。通过连续内存视图与 Buffer 协议,计算密集库成功将跨语言的数据交换成本降为零,从而成就了数据时代最为庞大繁荣的科学计算与人工智能生态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









