

Python中使用SQLAlchemy ORM进行数据查询入门

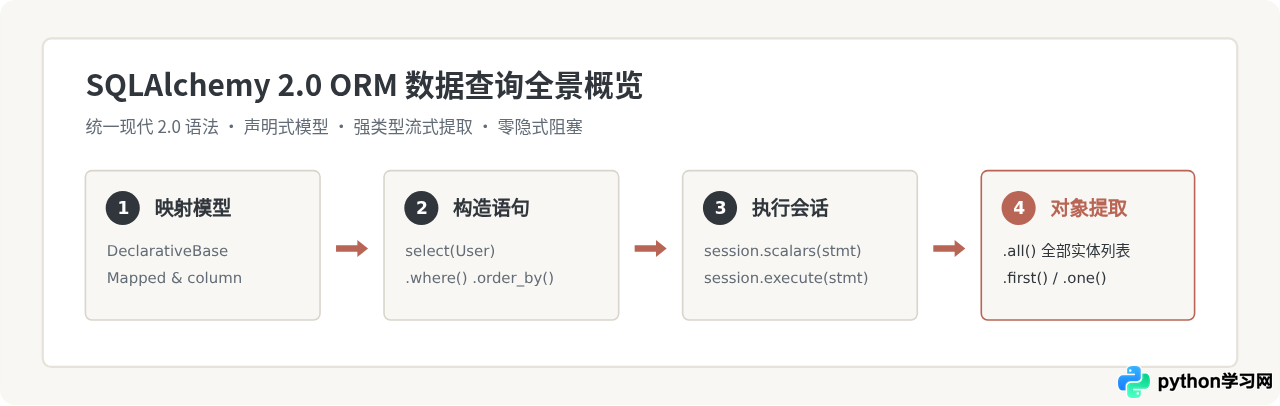
在 Python Web 开发与数据脚本编写中,SQLAlchemy 是最成熟的对象关系映射(ORM)工具之一。它允许开发者通过操作 Python 类与对象来表达关系型数据库操作,省去手动拼接原生 SQL 字符串的琐碎工作。随着 SQLAlchemy 2.0 的全面普及,旧有的 session.query(Model) 语法已逐步转为统一的 select(Model) 声明式语法。本文将以 SQLAlchemy 2.0 规范为基准,系统梳理数据查询的核心构建步骤、常用过滤方式、多表关联提取以及实战中的性能避坑点。
一、准备工作:模型声明与数据库会话建立
进行数据查询前,需要先定义数据库模型并初始化与数据库交互的引擎(Engine)和会话(Session)。在现代 SQLAlchemy 中,通常继承 DeclarativeBase,并利用 Mapped 类型注解来声明数据表列。
以下示例使用 SQLite 内存数据库建立运行环境,并声明一个基础的用户模型 User 与文章模型 Article:
from typing import List, Optional
from datetime import datetime
from sqlalchemy import create_engine, String, Integer, DateTime, ForeignKey, select
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship, Session

# 1. 声明基础模型基类
class Base(DeclarativeBase):
    pass

# 2. 定义 User 实体类
class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, index=True)
    email: Mapped[str] = mapped_column(String(120))
    age: Mapped[int] = mapped_column(Integer, default=18)
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.utcnow)

    # 一对多关联文章
    articles: Mapped[List["Article"]] = relationship(back_populates="author")

    def __repr__(self) -> str:
        return f"<User(id={self.id}, username='{self.username}', age={self.age})>"

# 3. 定义 Article 实体类
class Article(Base):
    __tablename__ = "articles"

    id: Mapped[int] = mapped_column(primary_key=True)
    title: Mapped[str] = mapped_column(String(200))
    views: Mapped[int] = mapped_column(Integer, default=0)
    user_id: Mapped[int] = mapped_column(ForeignKey("users.id"))

    author: Mapped["User"] = relationship(back_populates="articles")

    def __repr__(self) -> str:
        return f"<Article(id={self.id}, title='{self.title}', views={self.views})>"

# 4. 创建引擎并初始化数据库表
engine = create_engine("sqlite:///:memory:", echo=False)
Base.metadata.create_all(engine)
有了映射类和引擎后,后续所有查询都通过 Session 对象执行。推荐使用上下文管理器(with Session(engine) as session:)来管理会话生命周期,保证数据库连接能够被稳定释放。
二、基础查询:构建 select 语句与解析结果
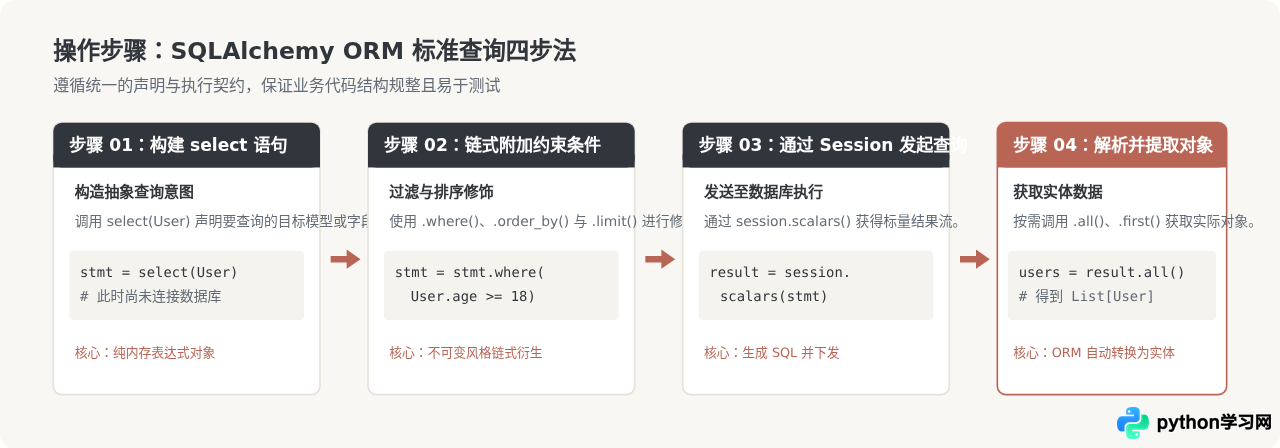
在 SQLAlchemy 2.0 中,数据查询的灵魂是 select() 函数。它并不直接触发网络请求或执行 SQL,而是构建出一个抽象语法树(AST)。只有将会话对象传递给 session.scalars() 或 session.execute() 时,底层才会真正执行数据库查询。
1. 全量数据获取(all 与迭代)
当我们要查询整张表的所有用户时,最基础的写法如下:
with Session(engine) as session:
    # 构造查询语句
    stmt = select(User)

    # 执行并获取实体列表
    users = session.scalars(stmt).all()

    for user in users:
        print(f"用户ID: {user.id}, 用户名: {user.username}")
理解 scalars() 与 execute() 的区别:session.execute(stmt) 返回的是包含行元组(Row Tuple)的结果集,每行形如 (User,);而 session.scalars(stmt) 会自动拆开元组,直接提取第一列的标量对象(即 User 实例)。当查询单个模型实体时,优先使用 session.scalars()。
2. 单条记录获取:first、one 与 one_or_none
在实际场景中,我们经常需要依据 ID 或唯一键查询单一记录。SQLAlchemy 提供了多种提取方法,需根据业务确定性选择:
result.first():获取结果集的第一条记录;若无数据则返回None。即便结果有多条也不会抛异常。result.one_or_none():预期最多只有一条结果。若有一条返回该对象;若无结果返回None;若超过一条则抛出 MultipleResultsFound 异常。result.one():严格要求有且仅有一条结果。若无记录抛出NoResultFound;若有多条抛出MultipleResultsFound。
with Session(engine) as session:
    # 查询指定用户名的单一用户
    stmt = select(User).where(User.username == "alice")
    user = session.scalars(stmt).one_or_none()

    if user:
        print(f"找到用户:{user.email}")
    else:
        print("用户不存在")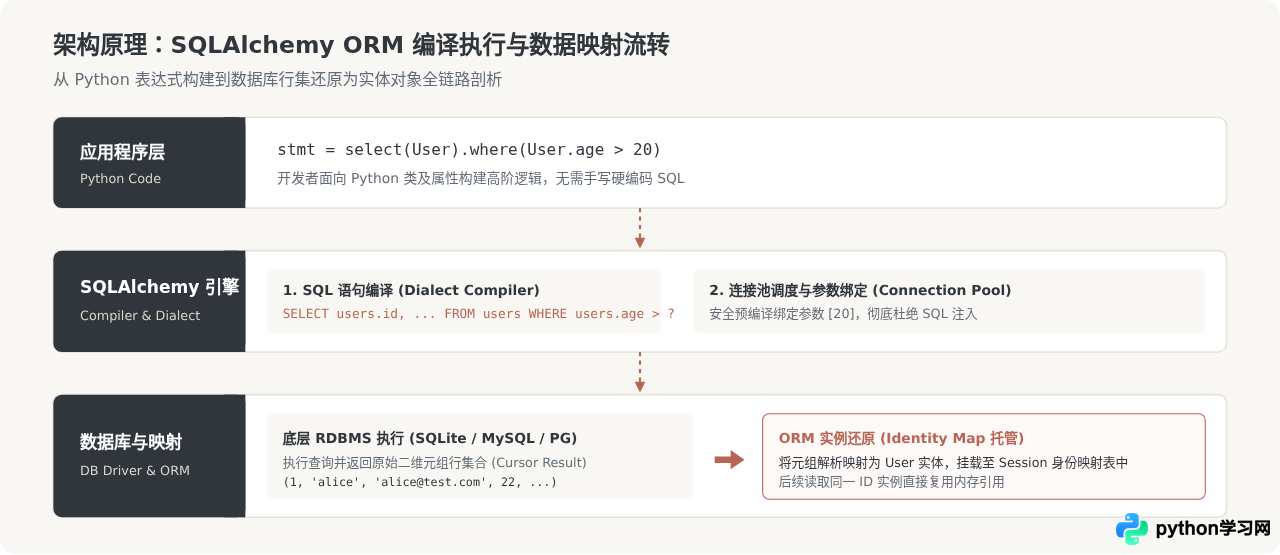
三、精准过滤与排序分页:where 条件进阶
在实际业务中,我们很少对全表进行全量扫描,而是通过各类限制条件圈定范围。SQLAlchemy 的 where() 子句支持 Pythonic 的原生运算符重载。
1. 常用逻辑与比较运算符
SQLAlchemy 巧妙地重载了 Python 的比较运算符:
- 等于与不等于:
User.age == 18,User.age != 18 - 数值范围:
User.age >= 18,User.age < 30 - 列表包含:
User.id.in_([1, 2, 3]),取反用User.id.not_in([1, 2, 3]) - 空值判断:
User.email.is_(None),非空用User.email.is_not(None) - 文本模糊匹配:
User.username.like("%admin%"),大小写不敏感可用User.username.ilike("%admin%")
2. 多条件组合(AND 与 OR)
在 where() 中传入多个逗号分隔的表达式,默认以 AND 关系连接。若需要表示 OR 或更复杂的逻辑嵌套,需显式导入 or_ 与 and_:
from sqlalchemy import and_, or_

with Session(engine) as session:
    # 场景:年龄大于20岁,或者以 test 开头的邮箱
    stmt = (
        select(User)
        .where(
            or_(
                User.age > 20,
                User.email.ilike("test%")
            )
        )
    )
    results = session.scalars(stmt).all()
3. 排序与分页控制(order_by, limit, offset)
控制结果排列与分页是 Web API 的刚需。通过链式调用 order_by()、limit() 和 offset() 可以快速达成:
with Session(engine) as session:
    # 场景:按年龄降序、创建时间升序排列,获取第 2 页数据(每页 10 条)
    page = 2
    page_size = 10

    stmt = (
        select(User)
        .order_by(User.age.desc(), User.created_at.asc())
        .offset((page - 1) * page_size)
        .limit(page_size)
    )
    users_page = session.scalars(stmt).all()
四、多表关联与连接查询:join 与数据聚合
关系型数据库的优势在于关联查询。在 SQLAlchemy 2.0 中,利用模型间定义的 relationship 可以让多表连接清晰自然。
1. 内连接(Inner Join)
若需查询发布过文章的用户,可以直接在 select() 后面挂载 join():
with Session(engine) as session:
    # 自动依据 ForeignKey 匹配连接条件
    stmt = select(User).join(User.articles).where(Article.views > 100)
    users = session.scalars(stmt).all()
2. 多列与跨表字段混合查询
有时我们不需要完整的模型实体,只需要部分字段进行轻量级展示。此时直接将字段传入 select(),并通过 session.execute() 提取:
with Session(engine) as session:
    stmt = (
        select(User.username, Article.title, Article.views)
        .join(Article, User.id == Article.user_id)
        .where(Article.views >= 50)
    )
    rows = session.execute(stmt).all()

    for row in rows:
        # row 是一个命名元组风格的对象
        print(f"作者: {row.username} | 文章: {row.title} | 阅读量: {row.views}")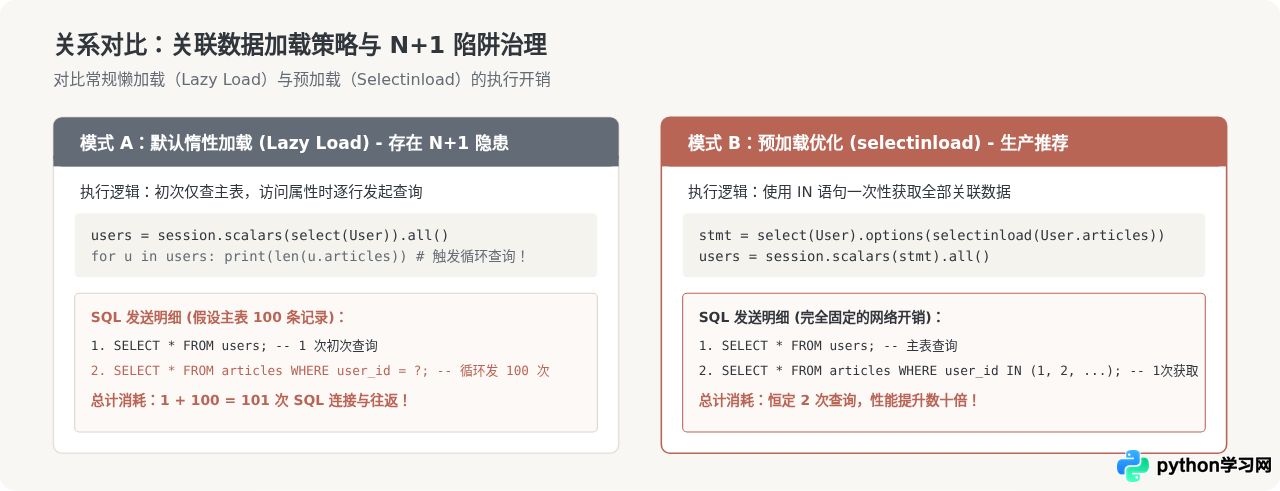
五、聚合函数与分组统计:func 的运用
统计总数、计算平均值或进行分组是报表类查询的典型需求。SQLAlchemy 通过 sqlalchemy.func 映射底层数据库的标准聚合函数。
1. 统计记录总数(count)
统计符合条件的总行数时,可以使用 func.count():
from sqlalchemy import func

with Session(engine) as session:
    # 统计成年用户总量
    stmt = select(func.count(User.id)).where(User.age >= 18)
    total_count = session.scalar(stmt)
    print(f"成年用户总数: {total_count}")
注意这里使用了 session.scalar(stmt),它是直接获取标量结果第一行第一列的快捷方式。
2. 分组(group_by)与条件筛选(having)
统计每个用户发表的文章数量,并筛选出文章数大于 3 篇的用户:
with Session(engine) as session:
    stmt = (
        select(User.username, func.count(Article.id).label("article_count"))
        .join(Article, User.id == Article.user_id)
        .group_by(User.username)
        .having(func.count(Article.id) > 3)
    )
    results = session.execute(stmt).all()

    for row in results:
        print(f"作者: {row.username}, 达标文章数: {row.article_count}")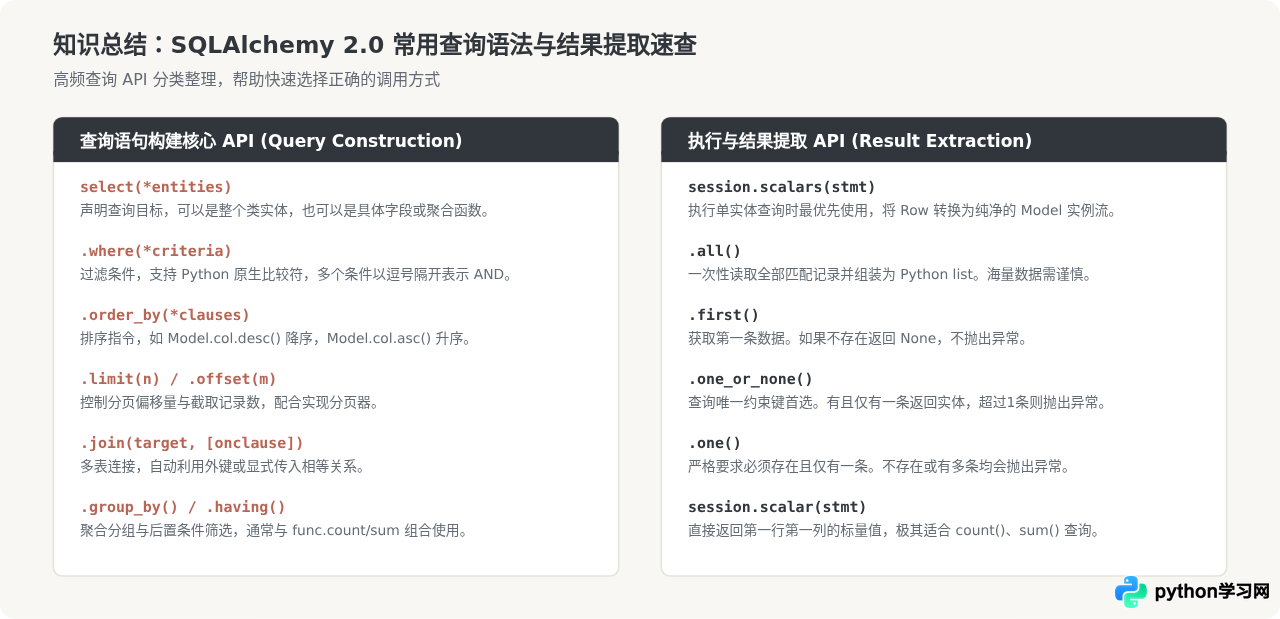
六、新手常见误区与避坑建议
掌握了基本语法之后,在实际项目中还需要注意以下细节,避免引入难以排查的 Bug 或性能瓶颈:
- 混淆 1.x 与 2.0 语法:网络上很多历史文章仍在使用
session.query(User).filter_by(...)。虽然 2.0 提供了过渡兼容,但新项目应全面统一为select(User).where(...),避免写法混杂带来的理解负担。 - 忽视 N+1 查询隐患:在模板渲染或序列化返回 JSON 时,一旦遍历用户并访问关联的
user.articles,默认的惰性加载会导致产生与用户数等量的子 SQL。对于这类批量访问场景,务必在查询时加入options(selectinload(User.articles))。 - 过度使用
all()导致内存爆破:对于数据量未知的表,不要直接session.scalars(select(LargeTable)).all()。应该通过limit()限制批次,或者使用yield_per()进行流式分批读取。 - Session 生命周期没有正确闭合:每个 Web 请求或任务单元应拥有独立的 Session。不要在全局范围共享单例 Session,否则在多线程或并发环境下极易造成连接竞争与状态污染。
七、总结
SQLAlchemy 2.0 的数据查询体系以清晰、可预测和强类型约束为核心演进方向。其核心脉络可以归纳为:“以 select() 表达意图,以 where() / join() 精确裁决范围,以 session.scalars() / execute() 发起执行,以 all() / first() / scalar() 具象化实体”。在理解这一主线的同时,结合 selectinload 预加载来防范 N+1 瓶颈,便足以应对绝大部分生产环境下的数据库查询任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









