

Python使用BeautifulSoup爬取网页信息的完整流程与代码实现
本文详细介绍利用Python和Beautiful库进行网页数据爬取的完整流程。内容涵盖查看网页源码、使用requests获取HTML、通过BeautifulSoup解析特定标签提取公司名称、职位及薪资信息,并将结果追加存储至CSV文件。此外,文章还演示了如何通过循环处理URL中的页码参数,实现多页数据的批量抓取与保存。
2026-10-13
11
本文详细介绍利用Python和Beautiful库进行网页数据爬取的完整流程。内容涵盖查看网页源码、使用requests获取HTML、通过BeautifulSoup解析特定标签提取公司名称、职位及薪资信息,并将结果追加存储至CSV文件。此外,文章还演示了如何通过循环处理URL中的页码参数,实现多页数据的批量抓取与保存。
本文介绍在Python中根据已知值查找元素索引的两种常用方法。首先讲解使用NumPy库中的np.where函数定位数组元素;其次探讨Pandas中利用df.index及isin()筛选特定行数据,并提及使用tail()查看尾部数据的技巧。文章旨在帮助开发者快速掌握基础的数据索引查询操作。
本文解析Python中slice切片对象的创建方式及其区间特性,重点介绍indices方法如何根据序列长度自动调整start、stop和step参数。通过具体代码示例展示indices在不同长度序列下的返回值差异,帮助开发者理解切片边界处理逻辑。
本文详细介绍Python中列表(数组)的基本操作方法,涵盖从创建列表、通过索引访问元素,到使用append、extend和insert方法更新列表的全过程。通过具体代码示例,帮助开发者快速掌握Python列表的核心功能与使用技巧。
本文深入解析Python列表推导式的核心语法与使用场景。通过对比传统循环与推导式的代码差异,展示如何利用简洁的表达式高效生成新列表。内容涵盖基础格式、条件过滤、函数应用及字符串处理等实例,帮助开发者提升代码可读性与执行效率。
本文介绍如何利用 Python 的 GDAL/OGR 库,基于现有的 Shapefile 模板快速创建新的矢量数据文件。通过指定输入模板路径和输出路径,程序自动复制坐标系、字段定义及几何类型,并支持向新图层添加指定坐标的点要素。代码包含中文路径与属性编码配置,适用于 GIS 数据处理场景。
本文详解如何在Python3 Tkinter应用中集成Pillow库以支持图片显示。内容涵盖Pillow库的下载与安装步骤,并通过完整代码示例演示如何创建包含菜单的窗口,实现点击菜单项分别显示图片(pic.jpg)和文本标签的功能,帮助开发者快速掌握Tkinter多媒体界面开发技巧。
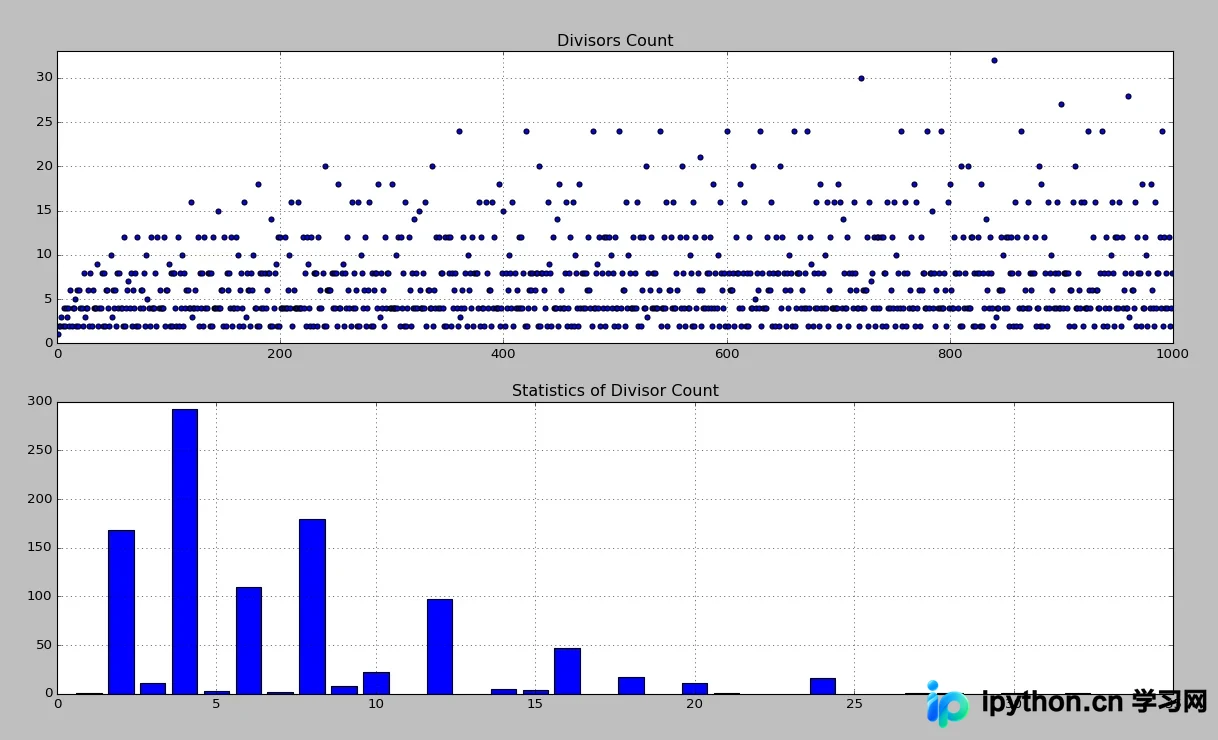
本文介绍如何使用Python的matplotlib库绘制1000以内自然数的约数个数统计图。通过自定义函数计算每个数的约数数量,利用scatter绘制散点分布,并用bar绘制统计条形图,直观展示约数个数的分布规律。
本文介绍如何使用 Python 批量为未设置过期时间的 Redis Key 添加 24 小时过期策略。通过 scan_iter 分批获取 Key,利用 ttl 命令判断是否已过期,并对未设置过期的 Key 执行 expire 命令。该方法有助于解决因 Key 未过期导致的内存暴增问题,适用于测试环境或谨慎操作的线上场景。
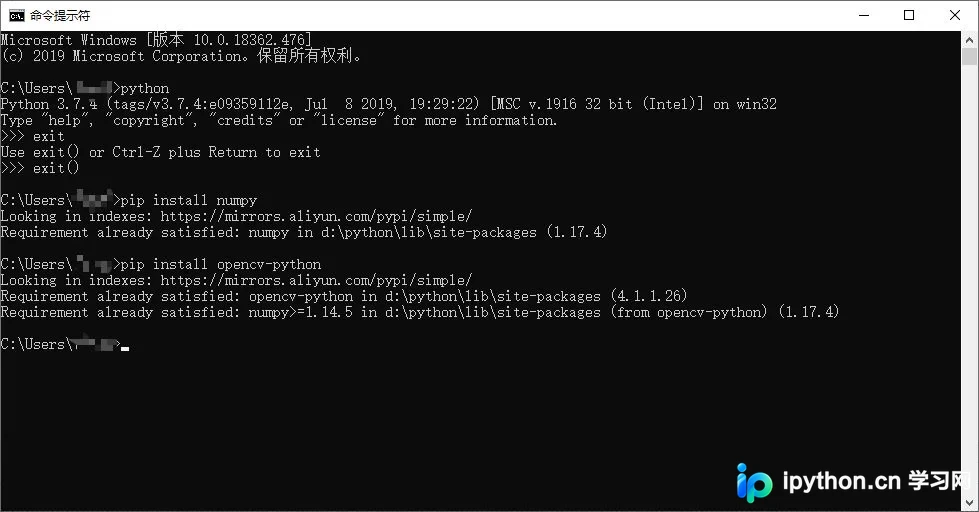
本文详细讲解如何在Windows环境下使用Python和OpenCV库调用笔记本或外接摄像头。通过安装numpy和opencv-python模块,编写基于cv2.VideoCapture的代码,实现实时灰度画面显示、ESC键退出及S键保存图片功能。注意当前opencv-python仅支持Python 3.7版本,不支持3.8及以上版本。
本文介绍在Python中处理NumPy多维数组时,如何高效提取指定维度的前几位数据。通过对比转置切片法与直接索引法,展示了利用input[:, [0, 1, 2]]直接获取第2维前三个元素的简洁方案,适用于形状为(7352, 9, 128, 1)等场景,帮助开发者优化数据处理流程。
本文介绍在Python中如何使用NumPy库随机选取矩阵或数组的指定行数。通过生成索引数组并打乱顺序,可高效实现随机抽样,适用于数据预处理及机器学习场景。