

Python中NumPy数组的高级赋值与索引技巧
本文深入解析Python中NumPy数组的赋值与索引机制。通过对比list与array在分隔符、数据类型、形状属性及乘法操作上的差异,重点演示如何利用布尔列表或数组对NumPy数组进行高效筛选赋值。文章指出列表不支持此类索引操作,并提供了具体的代码示例与错误分析,帮助开发者掌握NumPy的核心用法。
2026-10-13
12
本文深入解析Python中NumPy数组的赋值与索引机制。通过对比list与array在分隔符、数据类型、形状属性及乘法操作上的差异,重点演示如何利用布尔列表或数组对NumPy数组进行高效筛选赋值。文章指出列表不支持此类索引操作,并提供了具体的代码示例与错误分析,帮助开发者掌握NumPy的核心用法。
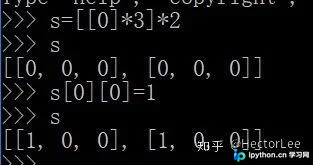
本文深入解析Python中二维数组初始化的常见错误。使用[[0]*3]*2方式初始化会导致所有子列表共享同一内存引用,修改任意元素将影响整列。文章通过机器人运动范围问题的实际案例,展示了这一Bug带来的困扰,并提供了正确的初始化方法以解决该问题,帮助开发者避免类似的内存引用错误。
本文详解NumPy中三维数组的元素位置索引规则,通过创建3x5x6数组并赋值示例,解析通道、行、列的下标对应关系。同时深入讲解多维数组axis参数的含义,结合代码演示axis=0,1,2时的求和结果,适用于深度学习特征数据处理场景。
本文解析Python、Anaconda与PyCharm三者的核心关系:Python是编程语言,Anaconda是包含常用库的发行版,PyCharm是集成开发环境。推荐先安装Anaconda再安装PyCharm,以避免手动配置依赖库的繁琐过程,提升开发效率。
本文介绍在Python中创建指定大小多维数组的两种常用方法:通过循环逐个初始化元素和使用列表推导式。重点分析了列表推导式在创建高维数组时可能引发的浅拷贝陷阱,并给出了针对三维及以上数组的推荐初始化方案,帮助开发者避免数据引用错误。
本文介绍在Python中预先初始化列表的几种常用方法。通过乘法运算符快速生成指定长度和统一初值的列表,利用list()转换range对象获取序列,以及使用列表推导式进行条件过滤。掌握这些技巧有助于提升代码执行效率并优化内存使用。
本文解析Python中`new_loss=old_loss=[]`导致的变量共享引用错误,说明两个变量将指向同一内存地址。通过对比错误写法与正确分开初始化的方式,结合代码示例展示输出差异,帮助开发者避免数据污染问题。
本文汇总了Python中生成从0到n数字列表的四种常用方法,包括基础循环拼接、append方法、列表推导式以及list构造器。通过具体代码示例对比各方法的实现逻辑与适用场景,帮助开发者根据实际需求选择最高效的列表生成方案。
本文介绍 Python 中判断自定义对象类型的两种主要方式:使用 __class__ 属性和 isinstance() 函数。重点解析两者在处理父子类关系时的差异,指出 __class__ 无法识别子类实例为父类实例,而 isinstance() 可以正确识别,帮助开发者根据实际需求选择合适的方法。
本文介绍在Python中创建元素全为0的列表的两种常用方法。第一种是利用列表乘法,如[0]*10,简洁高效;第二种是使用列表推导式,如[0 for _ in range(10)],逻辑清晰。两者均能生成指定长度的零值列表,适用于初始化数组或占位符场景。
本文介绍Python第三方库Faker的用法,该库支持生成城市、姓名等伪造数据且包含中文支持。文章详细说明了通过pip install faker进行安装的方法,并展示了初始化中文环境(locale='zh-cn')及生成姓名列表的代码示例,为需要测试数据的使用者提供参考。
本文详细解析在Flask框架下处理JSON数据的完整流程。以城市数据为例,展示如何从API获取嵌套JSON结构,分析字段后拆分存入MySQL数据库,并利用Flask-RESTful库构建API接口,将数据库中的城市信息重新序列化为标准JSON格式返回给前端用户。