

Python使用BeautifulSoup爬取网页信息的完整流程与代码实现

本文详细介绍利用Python和Beautiful库进行网页数据爬取的完整流程。内容涵盖查看网页源码、使用requests获取HTML、通过BeautifulSoup解析特定标签提取公司名称、职位及薪资信息,并将结果追加存储至CSV文件。此外,文章还演示了如何通过循环处理URL中的页码参数,实现多页数据的批量抓取与保存。
本文深入解析如何利用Python结合BeautifulSoup库高效爬取网页数据,通过详细的示例代码展示具体操作步骤,为相关学习与工作提供具有实际价值的参考指南。
网页爬取基本流程
实现网页信息的基础爬取通常遵循以下逻辑步骤:
首先,需要查看目标网页的源代码结构。
其次,利用网络请求库抓取网页内容。
接着,对获取的HTML内容进行结构化解析。
最后,将解析得到的数据保存至本地文件。
接下来,我们将以刺猬实习网站中Python岗位的薪资信息为例,演示如何使用BeautifulSoup解析库完成上述爬取任务。
源码分析与数据定位
第一步:分析网页源码结构
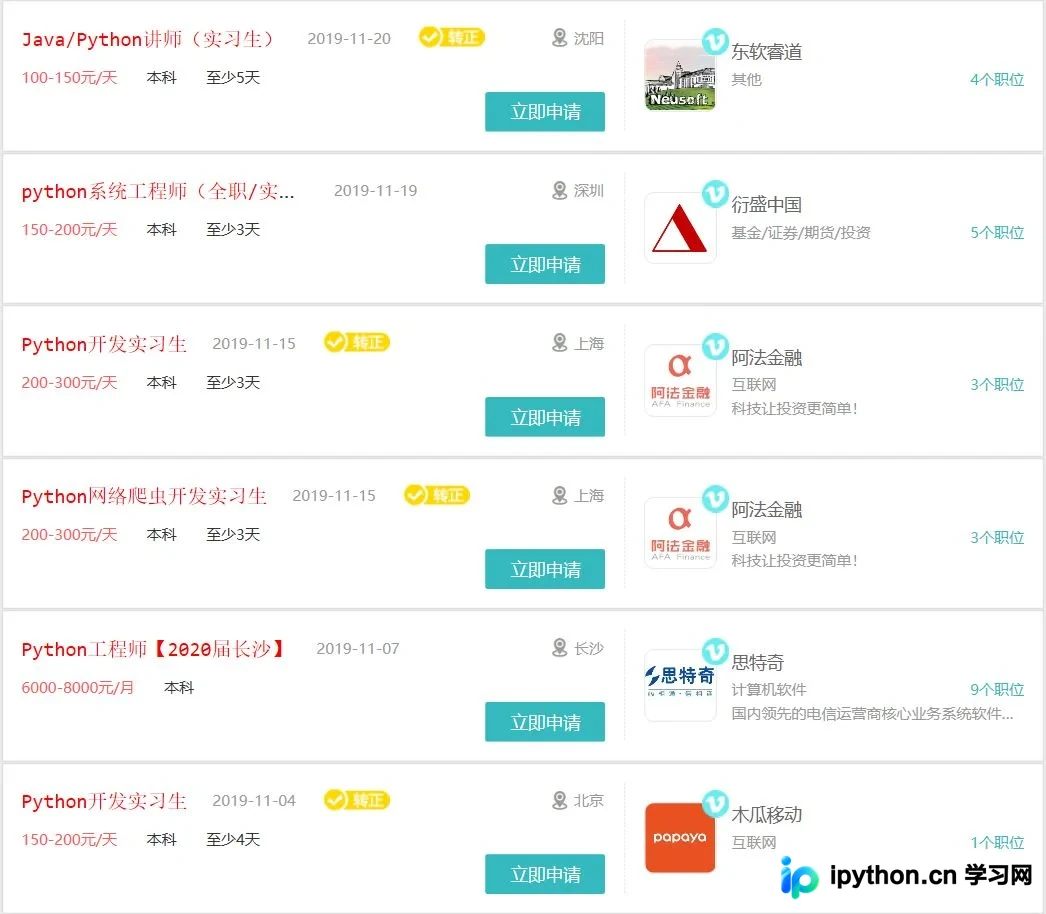
我们需要关注的核心数据区域,其在HTML源码中的对应结构如下所示:
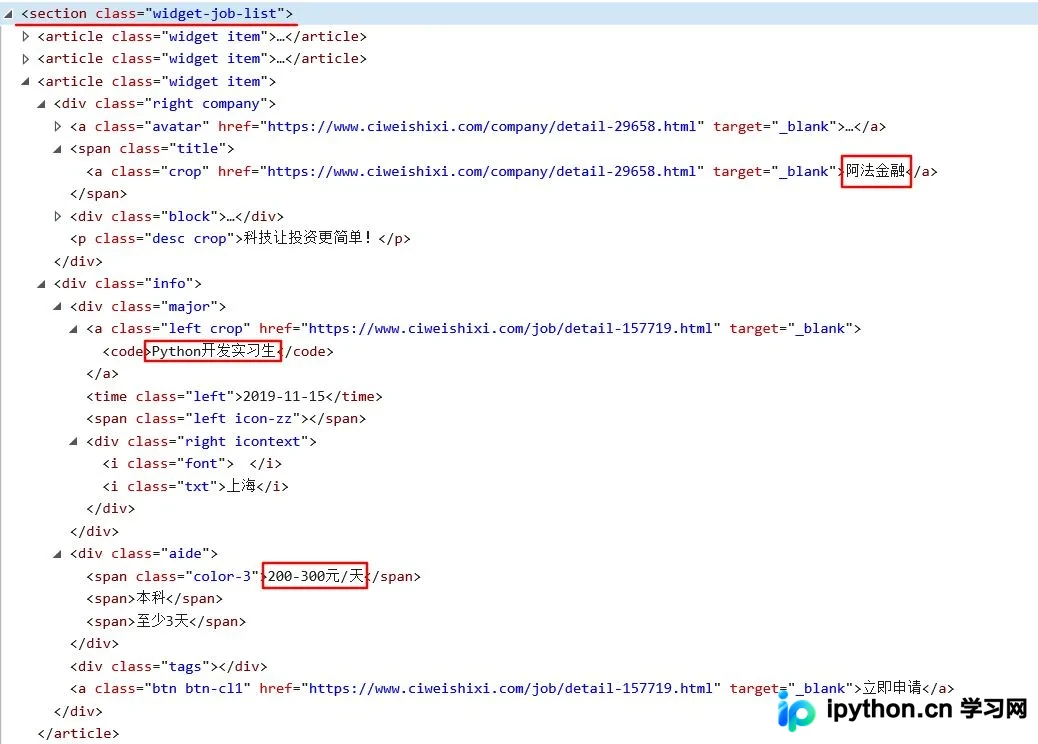
通过对源码结构的分析,我们可以得出以下关键信息:
1、所有岗位信息的列表包裹在带有class属性为“widget-job-list”的<section>标签内。
2、每一条具体的岗位信息被包含在带有class属性为“widget item”的<article>标签中。
3、针对每条岗位信息,我们需要提取的关键字段包括:公司名称、职位名称以及薪资范围。
第二步:抓取网页原始数据
使用requests库的get()方法发起请求并获取网页,随后将返回的文本内容传入BeautifulSoup进行解析,生成soup对象以便后续处理。
网页抓取与解析实现
def get_one_page(url):
  response = requests.get(url)
  soup = BeautifulSoup(response.text, "html.parser")
  return soup
第三步:解析网页内容并提取数据
1、定位到起始标签<section>,找到包含岗位列表的区域。
2、在<article>标签范围内,逐一匹配并提取各项具体信息。
3、将提取到的数据整理为列表格式,以便后续存储。
def parse_page(soup):
  #待存储的信息列表
  return_list = []
  #起始位置
  grid = soup.find('section', attrs={"class": "widget-job-list"})
  if grid:
    #找到所有的岗位列表
    job_list = soup.find_all('article', attrs={"class": "widget item"})

    #匹配各项内容
    for job in job_list:
      #find()是寻找第一个符合的标签
      company = job.find('a', attrs={"class": "crop"}).get_text().strip()#返回类型为string,用strip()可以去除空白符,换行符
      title = job.find('code').get_text()
      salary = job.find('span', attrs={"class": "color-3"}).get_text()
      #将信息存到列表中并返回
      return_list.append(company + " " + title + " " + salary)
  return return_list
第四步:将数据存储到文件
将处理好的列表数据写入名为shixi.csv的文件中,确保数据持久化保存。
数据存储与多页爬取逻辑
def write_to_file(content):
  #以追加的方式打开,设置编码格式防止乱码
  with open("shixi.csv", "a", encoding="gb18030")as f:
    f.write("\n".join(content))
第五步:实现多页信息爬取
观察网页URL结构可以发现,末尾的page参数代表了当前的页数信息。
因此,在main函数中接收page参数,并通过循环调用main(page)函数,即可实现多页数据的连续爬取。
def main(page):
  url = 'https://www.ciweishixi.com/search?key=python&page=' + str(page)
  soup = get_one_page(url)
  return_list = parse_page(soup)
  write_to_file(return_list)
if __name__ == "__main__":
  for i in range(4):
    main(i)
第六步:查看运行结果
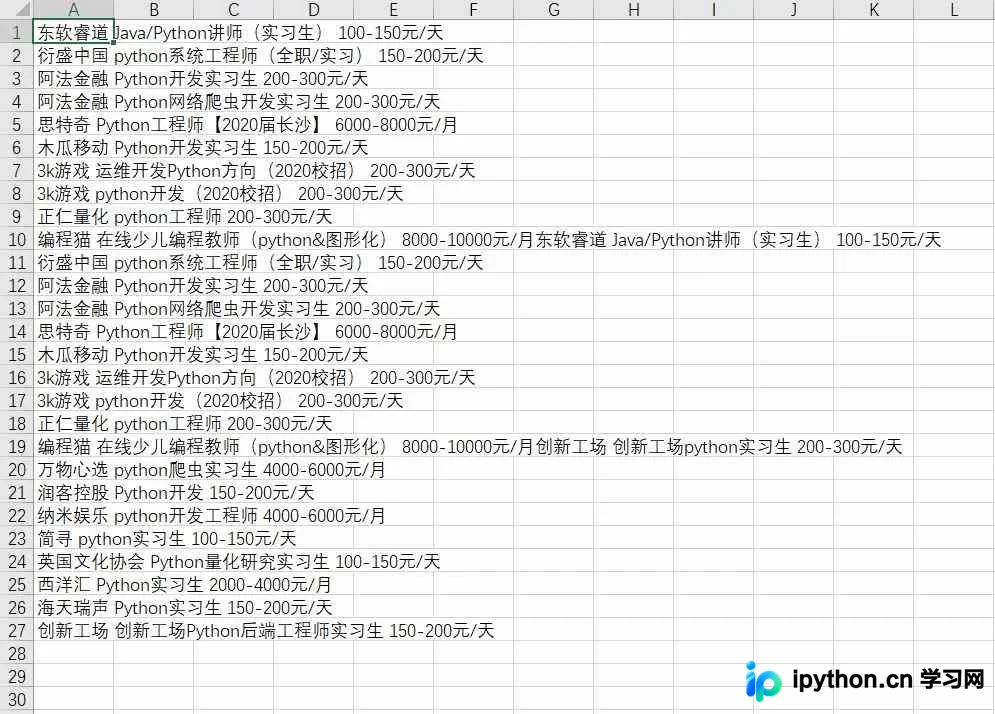
第七步:完整代码示例
完整代码汇总
import requests
import re
from bs4 import BeautifulSoup

def get_one_page(url):
  response = requests.get(url)
  soup = BeautifulSoup(response.text, "html.parser")
  return soup

def parse_page(soup):
  #待存储的信息列表
  return_list = []
  #起始位置
  grid = soup.find('section', attrs={"class": "widget-job-list"})
  if grid:
    #找到所有的岗位列表
    job_list = soup.find_all('article', attrs={"class": "widget item"})

    #匹配各项内容
    for job in job_list:
      #find()是寻找第一个符合的标签
      company = job.find('a', attrs={"class": "crop"}).get_text().strip()#返回类型为string,用strip()可以去除空白符,换行符
      title = job.find('code').get_text()
      salary = job.find('span', attrs={"class": "color-3"}).get_text()
      #将信息存到列表中并返回
      return_list.append(company + " " + title + " " + salary)
  return return_list

def write_to_file(content):
  #以追加的方式打开,设置编码格式防止乱码
  with open("shixi.csv", "a", encoding="gb18030")as f:
    f.write("\n".join(content))
def main(page):
  url = 'https://www.ciweishixi.com/search?key=python&page=' + str(page)
  soup = get_one_page(url)
  return_list = parse_page(soup)
  write_to_file(return_list)
if __name__ == "__main__":
  for i in range(4):
    main(i)
以上即为本文的全部内容,希望这些示例代码能对您的学习和工作有所帮助,欢迎继续支持本站获取更多技术资源。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









