

Pandas处理缺失值:判断、过滤与填充完整指南
本文详细介绍Pandas中处理缺失值的核心方法。涵盖如何识别Series和DataFrame中的NaN与None,使用dropna按行或列过滤数据,以及通过fillna进行指定值、前后向或均值填充。掌握这些技巧可提升数据清洗效率。
2026-10-13
12
本文详细介绍Pandas中处理缺失值的核心方法。涵盖如何识别Series和DataFrame中的NaN与None,使用dropna按行或列过滤数据,以及通过fillna进行指定值、前后向或均值填充。掌握这些技巧可提升数据清洗效率。
本文深入解析NumPy中meshgrid函数的功能与用法。详细讲解x1,x2等输入数组、indexing索引模式、sparse稀疏输出及copy视图控制等关键参数。通过具体代码示例,展示如何生成笛卡尔坐标网格、利用ravel提取坐标点,以及使用sparse=True优化内存占用的技巧,帮助开发者高效处理网格数据。
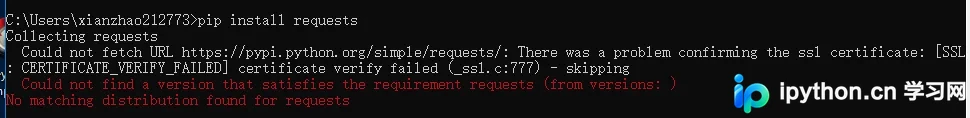
本文解决Python使用pip install时遇到的SSL证书验证失败(CERTIFICATE_VERIFY_FAILED)错误。该问题通常因国内网络限制导致无法连接官方源。通过创建用户目录下的pip.ini文件并配置豆瓣镜像源,可快速修复此问题,适用于Windows系统。
本文详细介绍pandas库中DataFrame的append方法,涵盖其函数签名、核心参数如ignore_index和verify_integrity的作用。通过字典、Series及列表三种数据结构的添加示例,演示如何处理索引冲突及列名扩展,帮助开发者高效进行数据合并操作。
本文探讨Python爬虫在抓取需验证码页面时遇到的验证码同步难题,并提供三种解决方案:利用Session保持会话、通过Cookie传递凭证以及使用Selenium结合手动构造Cookie。重点解析了Selenium中Cookie的增删改查API,并指出识别加密Cookie键名的难点,旨在帮助开发者绕过验证码识别的高成本或低成功率限制。
本文详解Django项目中配置和使用多个数据库的方法。涵盖在settings中定义DATABASES、通过app_label指定模型归属,以及编写Database Routers类实现读写分离和迁移控制。包含AuthRouter与PrimaryReplicaRouter完整示例,讲解migrate命令的--database参数使用,以及手动指定using、处理主键冲突和对象转移的具体代码实现。
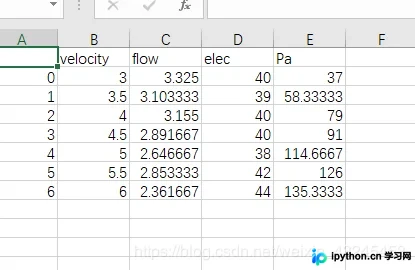
本文介绍在Python中向CSV文件追加新列的两种常用方法。第一种利用Pandas库读取数据后直接赋值新列并保存;第二种通过csv模块逐行读取并修改。文章包含代码示例及注意事项,帮助开发者高效处理CSV数据追加任务。
本文深入解析Python中psutil模块的使用方法。psutil是一个跨平台的库,支持Linux、Windows、macOS等系统,用于获取CPU、内存、磁盘、网络及传感器等系统利用率信息。文章通过具体代码示例,演示如何获取系统性能参数及管理进程资源,涵盖从基础信息获取到进程状态监控的完整操作流程,帮助开发者实现高效的系统监视与流程控制。
本文深入探讨Python中self参数的必要性。尽管“显式优于隐式”是Python的核心哲学,但强制在方法定义中显式列出self被视为一种冗余。文章分析了方法定义与调用时的隐式传递机制,指出这导致了定义与调用逻辑的不一致,并提出了将self作为关键字的改进建议,以消除这种非Pythonic的设计矛盾。
本文介绍如何利用Python的Pandas库高效处理超过140MB、170万行的CSV文件。对比MySQL导入卡顿和R语言加载缓慢的问题,展示Pandas在快速读取、列操作、分组聚合及生成透视表方面的优势,并提供完整的代码示例与处理流程。
本文详细解析如何使用Python的requests库进行视频文件的流式下载,解决内存占用问题。通过引入contextlib.closing处理上下文管理器缺失,并优化文件写入策略以实时保存数据。最后结合多线程与队列机制,实现高效的多线程并发下载,包含断点判断与进度显示功能。
本文详细介绍Python中读写CSV文件的多种方法,包括使用csv模块和pandas库。重点讲解如何在现有CSV文件中增加新的列(如label和is_cc)并写入数据,同时提供解决writerows产生多余空行的技巧。内容涵盖基础代码实现、数据框操作及常见错误排查,适合需要处理结构化数据的开发者参考。