

Python循环内频繁使用with打开文件的性能影响与优化
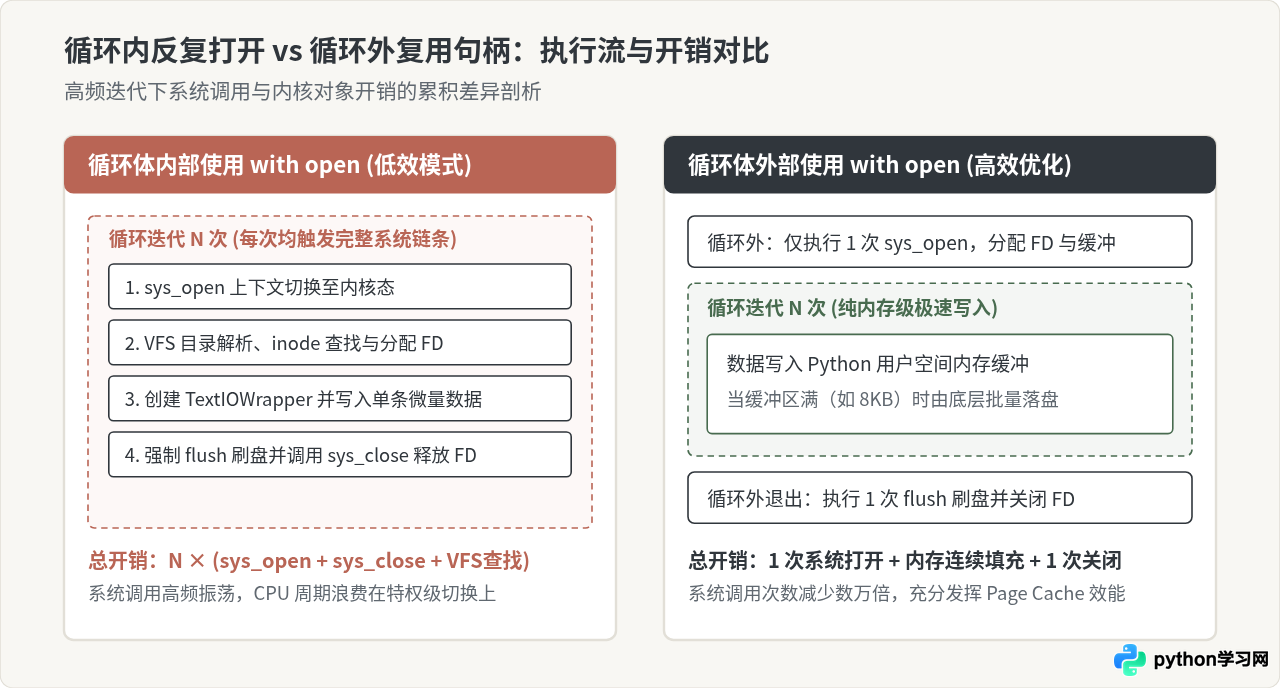
with open(...) 放置于循环体内部是一种常见但隐蔽的性能杀手。每执行一次上下文打开操作,系统都会触发内核态上下文切换、文件路径解析、文件描述符分配以及 Python I/O 缓冲区的重构。在处理海量小数据时,这种重复动作会导致程序吞吐量严重下降。本文将深入分析这层开销的物理根源,并提供句柄外提、批量分块与流式缓冲的具体重构方案。
一、循环内反复打开文件的性能损耗根源
Python 的 with 语句通过上下文管理器协议(__enter__ 与 __exit__)极大地降低了文件资源泄露的风险。然而,许多初学者误以为 with 是轻量级的语法糖,从而在遍历列表或生成器时写出在每次迭代内部打开文件的代码。
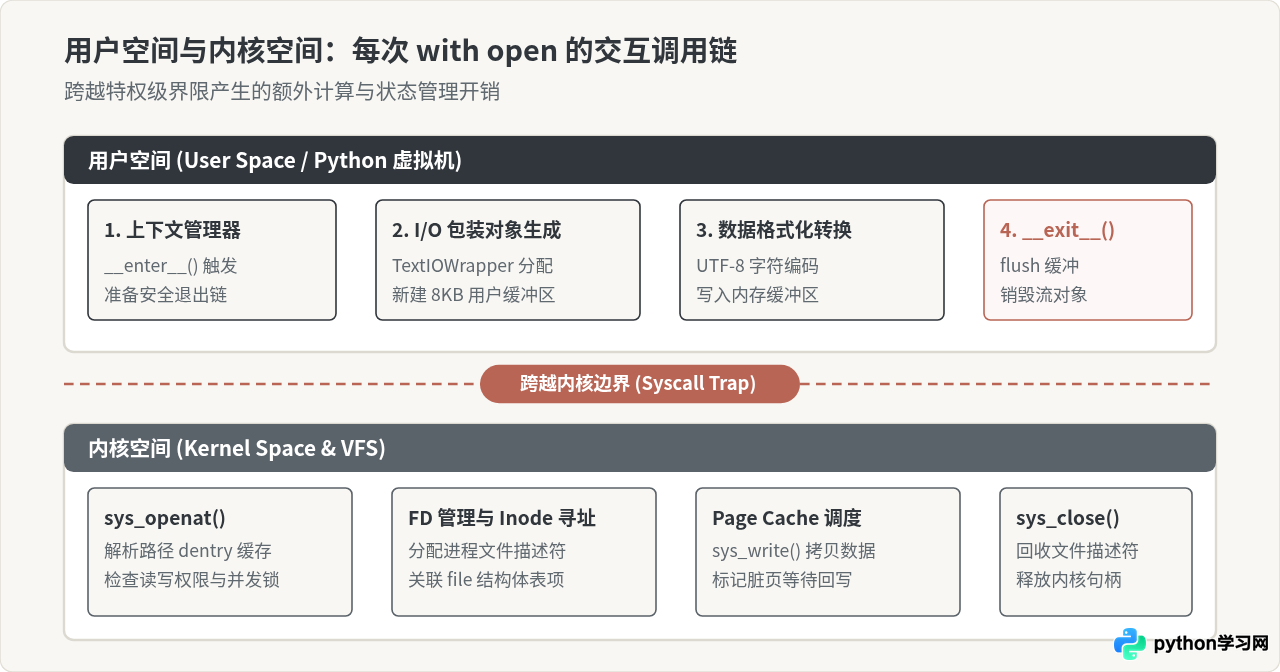
从计算机体系结构来看,单纯的内存计算与系统级 I/O 存在数量级上的性能差异。当程序在循环内反复调用 with open(filepath, 'a') 时,底层经历的不是简单的“向磁盘写一段字节”,而是一套完整的操作系统与运行时调用链:
- 系统调用与特权级切换:每次
open()都会触发从用户空间(Ring 3)到内核空间(Ring 0)的软中断或syscall指令。内核需要暂停当前程序上下文,保存寄存器状态,处理系统调用后再恢复。 - 虚拟文件系统(VFS)解析:内核必须根据提供的路径逐级遍历目录项(dentry),检查权限,查找 inode 节点并锁定对应资源。即使操作系统拥有 dentry 缓存,重复的路径寻址依然消耗 CPU 周期。
- 文件描述符(FD)分配与回收:操作系统需要从进程的文件描述符表中查找可用槽位,建立文件打开表项;在退出
with块时,再调用close()递减引用计数并清理资源。 - Python I/O 对象生命周期开销:在 Python 层面,每一次
open()都会实例化底层的二进制流(如FileIO)、带缓冲流(如BufferedWriter)以及上层的字符编码转换层(TextIOWrapper),并在退出时强制刷新缓冲区并销毁对象。
二、典型代码反例与性能损耗场景辨析
为了直观展示性能影响,我们来看一段常见的反模式代码。在处理日志聚合或数据清洗时,部分开发者习惯于在处理每条记录时追加写入:
# 典型反例:循环内部频繁调用 with open
import time

records = [f"data_record_payload_{i}\n" for i in range(50000)]

# 反例实现
start_time = time.perf_counter()
for item in records:
    # 每次迭代都会创建并销毁一个文件对象,触发系统调用
    with open("output_slow.txt", "a", encoding="utf-8") as f:
        f.write(item)
print(f"循环内 open 耗时: {time.perf_counter() - start_time:.3f} 秒")
在常规 SSD 硬盘与主流操作系统环境下,执行上述 50,000 次循环内写入,耗时通常在 2 秒到 5 秒之间;而如果在循环外打开文件,耗时仅需约 0.015 秒。两者相差超过 100 倍。
性能损耗何时显著?何时可以忽略?
尽管频繁打开文件存在显著开销,但在实际工程中我们需要依据具体条件来判断优化优先级:
- 致命损耗场景:循环迭代次数达到万级以上(如爬虫解析、ETL流水线、高频传感器数据处理);写入目标位于网络共享文件系统(如 NFS、Samba)或分布式文件系统(每次 open 伴随网络往返延迟);或者部署在受限容器环境中。
- 开销不明显场景:循环总次数仅有十几次或几十次;单次迭代中包含数秒的高耗时任务(如大型机器学习模型推理、复杂远程 API 调用),此时几毫秒的文件打开开销在总耗时中占比不足 0.1%。
- 安全与隔离诉求:在需要极高容灾级别、进程随时可能断电或被
kill -9强杀的场景下,循环内即时关闭文件能确保最后一条记录立即落盘。但这种需求通常应使用显式flush()或os.fsync()解决,而非依赖低效的重复打开。
三、四种核心优化方案与工程实现
方案一:句柄外提(基本优化)
当所有循环迭代都操作同一个目标文件时,最简洁有效的优化是直接提升 with 的作用域,将文件打开动作置于循环外部。
# 优化方案一:提升 with open 作用域到循环外
start_time = time.perf_counter()
with open("output_fast.txt", "w", encoding="utf-8") as f:
    for item in records:
        f.write(item)
print(f"句柄外提耗时: {time.perf_counter() - start_time:.3f} 秒")
核心收益:系统调用从 50,000 次骤降至 1 次。此时 Python 内部的 TextIOWrapper 会维护一个默认 8KB 大小的内存缓冲区,只有当数据填满缓冲区时,底层才会触发一次批量的内核写调用,写入效率获得质的飞跃。
方案二:内存分块聚合与 writelines 批量写入
如果每条记录内容较短(例如仅几十个字节),即使在循环外打开文件,频繁调用 f.write() 也会产生较多的 Python 字节码解释开销。可以通过在内存中累积小批次,再使用 writelines() 一次性交付。
# 优化方案二:分批聚合写入
batch_size = 5000
buffer = []

with open("output_batch.txt", "w", encoding="utf-8") as f:
    for item in records:
        buffer.append(item)
        if len(buffer) >= batch_size:
            f.writelines(buffer)
            buffer.clear()
    if buffer:
        f.writelines(buffer)
        buffer.clear()
方案三:生成器流式处理(兼顾吞吐量与内存占用)
对于超大规模数据集,把全部数据一次性读入列表会撑爆内存,而逐条写入又嫌太慢。此时推荐使用生成器分块产生数据流,结合上下文管理器实现高吞吐流式管道:
# 优化方案三:生成器管道流式写入
def chunked_data_stream(data_source, chunk_size=2000):
    chunk = []
    for row in data_source:
        chunk.append(row)
        if len(chunk) >= chunk_size:
            yield "".join(chunk)
            chunk.clear()
    if chunk:
        yield "".join(chunk)

with open("output_stream.txt", "w", encoding="utf-8") as f:
    for text_block in chunked_data_stream(records):
        f.write(text_block)
方案四:动态多文件场景下的句柄池缓存
实际开发中还存在另一类复杂情况:循环内的每条记录需要根据某个字段分流写入不同的文件(例如按日期或用户 ID 分流)。如果在循环内部按文件名称频繁打开,同样会导致剧烈卡顿。此时可构建简易的打开文件缓存池,配合 contextlib.ExitStack 实现统一的资源释放。
# 优化方案四:使用 ExitStack 维护多目标文件的句柄缓存
from contextlib import ExitStack

file_cache = {}

with ExitStack() as stack:
    for item in records:
        # 假设依据某个前缀决定写入目标
        target_name = f"log_partition_{hash(item) % 5}.txt"

        # 仅在初次遇到该文件时打开,并注册到 stack 中
        if target_name not in file_cache:
            file_cache[target_name] = stack.enter_context(
                open(target_name, "a", encoding="utf-8")
            )

        file_cache[target_name].write(item)
# 退出 with ExitStack 时,所有打开的文件句柄会被自动且安全地统一关闭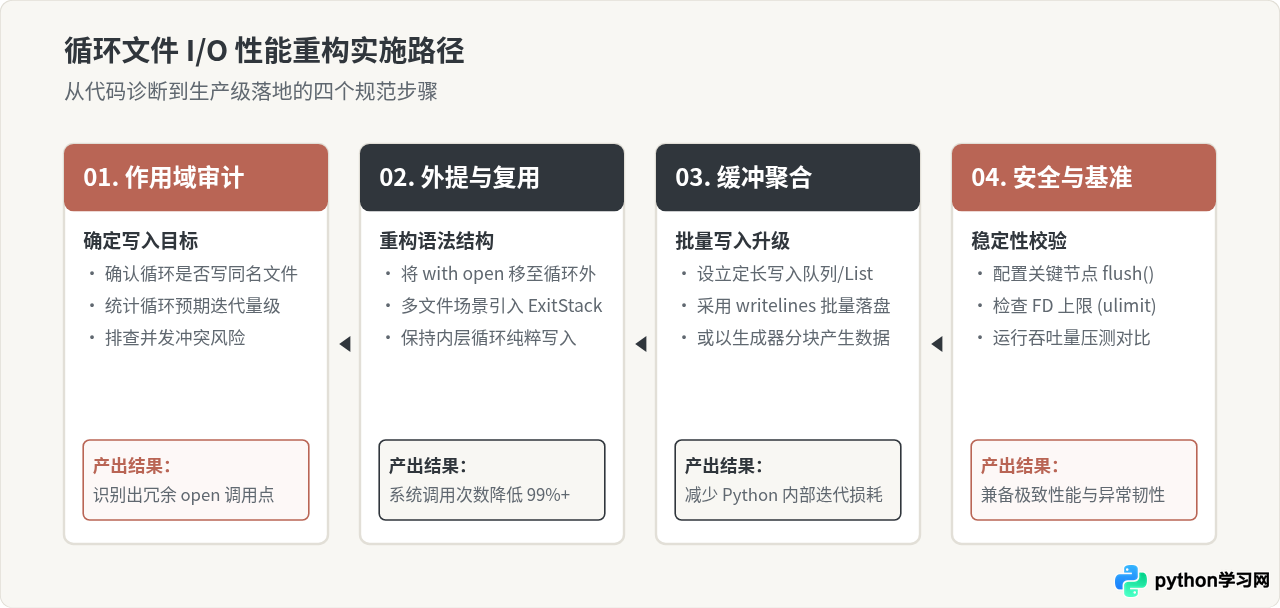
四、异常安全、缓冲区丢失与边界控制
在优化性能的同时,我们必须警惕盲目追求高吞吐带来的数据安全风险。将文件句柄提升至循环外部后,数据流的行为发生了本质变化:
1. 数据滞留与崩溃丢失风险
在原先循环内频繁 with open 的写法中,虽然性能极差,但每次退出 with 都会隐式调用 f.close(),促使缓冲区全部写回操作系统。
而将句柄外提后,Python 的默认缓冲机制(通常为 4KB~8KB)会将多次 write 的内容暂存在内存中。如果程序在运行到第 9999 次循环时突然抛出未捕获异常崩溃或被物理断电,内存中尚未被刷新的脏数据将会永久丢失。
if idx % 1000 == 0: f.flush()。这样既保留了批处理的性能优势,又将潜在数据丢失窗口严格限制在可控范围内。
2. 文件描述符泄漏与操作系统配额限制
在处理“根据分类动态写入多个文件”的场景中,如果简单使用字典缓存已打开的文件句柄,必须警惕文件描述符耗尽问题。在 Linux 系统下,单个进程的打开文件数上限默认通常为 1024(可通过 ulimit -n 查看)。如果分类数量达到数千个,无节制地保持所有文件句柄处于打开状态,会直接引发 OSError: [Errno 24] Too many open files 报错。
针对该边界条件,应当采用两级策略:
- 预先分组/排序:在写入之前,先对数据流按目标文件标识进行排序或分桶处理,确保同一时间只处理并打开一个目标文件。
- LRU 句柄池淘汰机制:当需要打开的文件数量超过安全阈值(如 200 个)时,基于最近最少使用(LRU)原则关闭最久未写入的文件句柄。
五、优化策略选型与决策总结
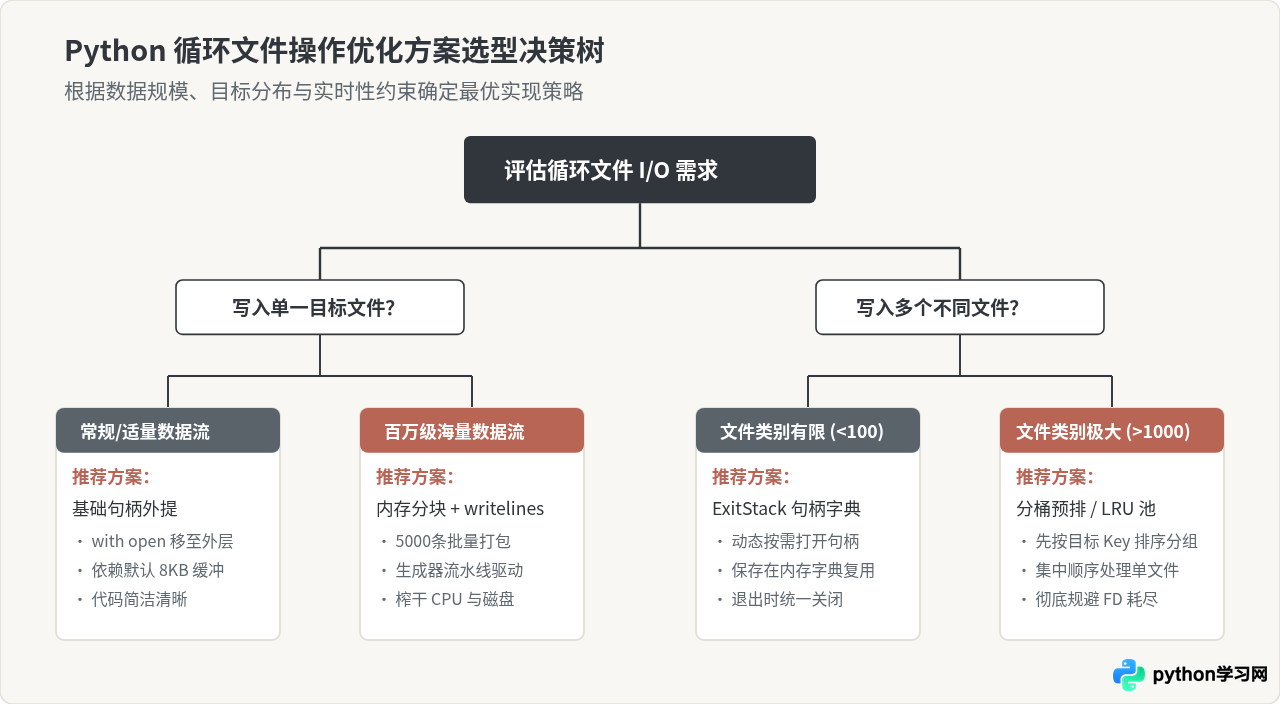
针对不同业务体量与环境特征,工程上并不存在“放之四海皆准”的唯一写法。下方的决策树总结了面对循环内文件 I/O 需求时的推荐技术路径:
| 方案类型 | 系统调用次数 | 内存占用 | 适用数据量级 | 主要优势与注意点 |
|---|---|---|---|---|
| 循环内 with open (反例) | N 次 (极高) | 极低 | 仅适合 < 50 次微量写入 | 实现直观但开销严重,高频下吞吐量极差 |
| 句柄外提 (推荐基准) | 1 次 + 缓冲自动 flush | 低 (~8KB 缓冲) | 千级至数十万级记录 | 改动最小,性能提升 50~100 倍以上 |
| 批处理与 writelines | 大幅缩减系统写调用 | 可控 (受 batch_size 决定) | 百万级及以上记录 | 显著减少 Python 解释器内部执行损耗 |
| ExitStack 句柄池 | 等于不同目标文件总数 | 中等 (受文件数限制) | 多分类分流写入场景 | 解决多文件动态写入难题,需留意 FD 配额 |
总结而言,在 Python 中处理文件时,with 语句应当扮演资源生命周期管理者而非单次动作的瞬时包装器。通过将 with open 提升至循环边界之外,或者采用批聚合与句柄复用模式,能够将原本充斥在用户态与内核态之间的无谓系统调用彻底消除,让程序的执行瓶颈真正回归到实际的计算逻辑中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









