

通过5个Python小项目巩固基础:从计算器到简单爬虫
一、认知辨析:语法记忆与工程实操的鸿沟
很多初学者常有这样的体会:“看教程里的变量、列表推导式、函数定义时觉得全都听懂了,但让自己写个几行代码的小工具,大脑却一片空白。”
这种现象之所以发生,是因为阅读教程和编写程序依赖的是两种截然不同的思维模型:阅读测试的是“被动模式识别”,只要逻辑大致通顺,大脑就会默认理解;而编写程序则是“主动状态推演”,你必须确切知道每一行代码执行后,内存里的变量值发生了什么改变、可能遭遇什么异常、循环何时收敛。单纯刷语法练习题通常只针对单一孤立点,缺乏上下文状态维度的锻炼。因此,通过小项目将离散知识组织成完整系统,是跨越这道鸿沟最务实的手段。
二、项目一:命令行交互计算器(变量、运算与异常防护)
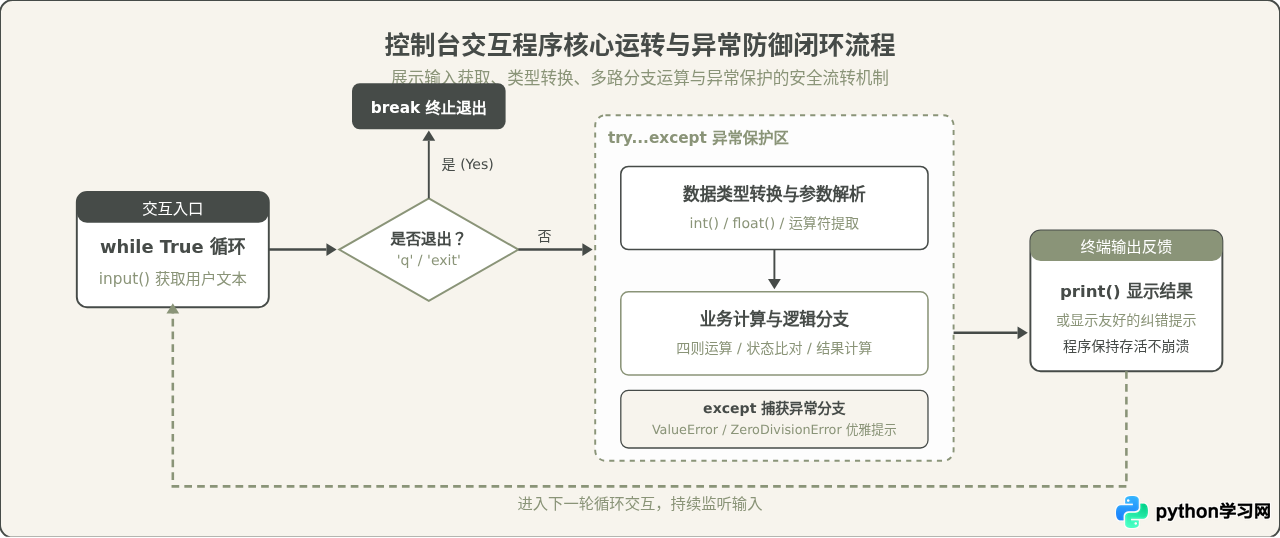
这个项目的核心价值在于理解主事件循环与异常防御。一个合格的计算器程序绝不仅是执行简单的 a + b,而必须具备持续接收输入、判断输入类型是否合法、处理除零错误并在计算完成后等待下一次指令的能力。
1. 完整实现代码
# calculator.py
def run_calculator():
    print("=== 简易命令行多功能计算器 ===")
    print("支持运算: +、-、*、/  | 输入 'q' 或 'exit' 退出程序\n")

    while True:
        op = input("请输入运算符 (+, -, *, /) 或输入 q 退出: ").strip()
        if op.lower() in ('q', 'exit'):
            print("计算器已退出。")
            break

        if op not in ('+', '-', '*', '/'):
            print("【输入警告】不支持该运算符,请重新输入!\n")
            continue

        # 捕获数值转换与除零异常
        try:
            num1_str = input("请输入第一个数值: ").strip()
            num1 = float(num1_str)
            num2_str = input("请输入第二个数值: ").strip()
            num2 = float(num2_str)

            if op == '+':
                result = num1 + num2
            elif op == '-':
                result = num1 - num2
            elif op == '*':
                result = num1 * num2
            elif op == '/':
                if num2 == 0:
                    raise ZeroDivisionError("除数不能为 0!")
                result = num1 / num2

            print(f"计算结果: {num1} {op} {num2} = {result:.4g}\n")

        except ValueError:
            print("【格式错误】输入的数值无效,请输入合法的整数或浮点数!\n")
        except ZeroDivisionError as err:
            print(f"【数学错误】{err}\n")

if __name__ == "__main__":
    run_calculator()
2. 核心技术点解析
- 输入类型提升:
input()始终返回字符串,必须用float()显式转换。若用户误输入文字,float()会引发ValueError,通过try...except捕获可防止程序异常崩溃。 - 循环控制:通过
while True维持交互生命周期,使用break响应退出命令,使用continue在遇到非法符号时直接跳入下一轮等待,避免多层条件嵌套。 - 格式化输出:
{result:.4g}智能保留有效数字,兼顾整数呈现与浮点数精度。
三、项目二:猜数字小游戏(随机数生成与二分分支控制)
如果说计算器练习的是被动运算,猜数字游戏则引入了状态保持与动态反馈。程序需要维护目标数字、当前猜测次数以及猜值区间的上下界。
1. 完整实现代码
# guess_number.py
import random

def play_guessing_game():
    target = random.randint(1, 100)
    max_attempts = 7
    attempts = 0
    low_bound = 1
    high_bound = 100

    print("=== 猜数字对决 (范围: 1 - 100) ===")
    print(f"你一共有 {max_attempts} 次猜测机会,系统会给出动态区间提示。\n")

    while attempts < max_attempts:
        attempts += 1
        remaining = max_attempts - attempts + 1
        prompt = f"第 {attempts} 次尝试 (剩余 {remaining} 次,当前有效区间 [{low_bound}, {high_bound}]): "

        user_input = input(prompt).strip()
        try:
            guess = int(user_input)
        except ValueError:
            print("【输入无效】请输入合法的整数!本次不计入次数。")
            attempts -= 1
            continue

        if guess < low_bound or guess > high_bound:
            print(f"【超界提醒】你的输入不在当前有效区间 [{low_bound}, {high_bound}] 内,但消耗一次机会。")

        if guess == target:
            print(f"\n🎉 太棒了!你在第 {attempts} 次成功猜中了数字 {target}!")
            return
        elif guess < target:
            print("太小了!")
            if guess >= low_bound:
                low_bound = guess + 1
        else:
            print("太大了!")
            if guess <= high_bound:
                high_bound = guess - 1

    print(f"\n很遗憾,次数已用尽!正确答案其实是: {target}。再接再厉!")

if __name__ == "__main__":
    play_guessing_game()
2. 核心技术点解析
- 标准库调用:
random.randint(a, b)产生闭区间[a, b]内的随机整数。 - 状态收敛逻辑:每次根据用户猜大或猜小,动态收窄
low_bound和high_bound,体现了二分查找算法的物理直觉。 - 条件容错设计:输入无效字符时不消耗宝贵的尝试次数,体现良好的用户体验设计。
四、项目三:轻量控制台待办事项清单(数据结构与 JSON 本地持久化)
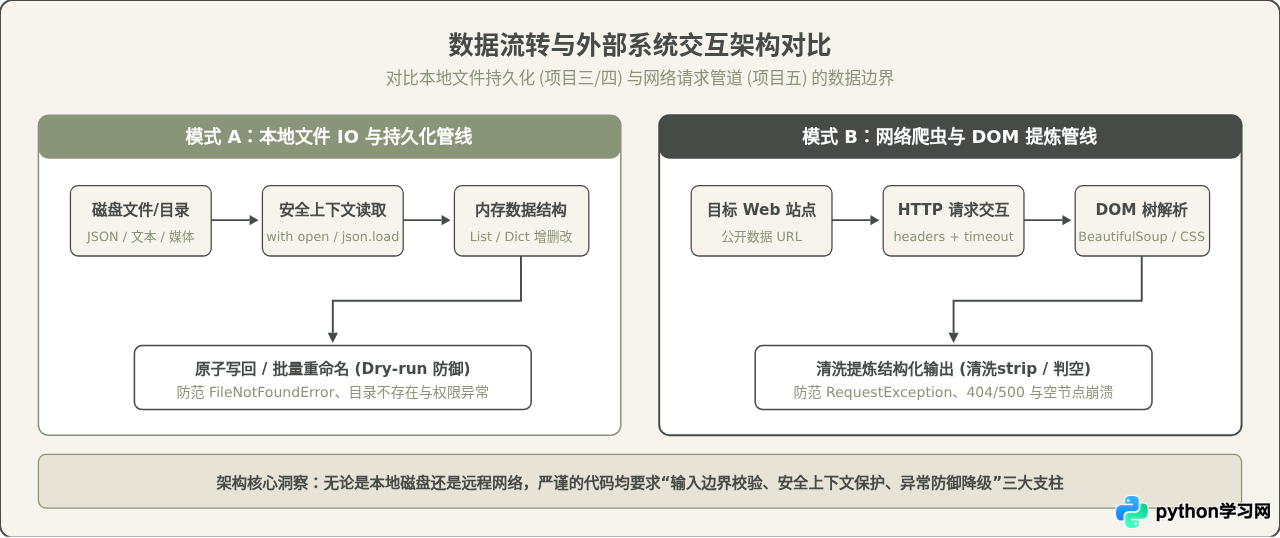
前两个项目的数据均存在于内存中,一旦程序关闭数据随即丢失。项目三引入复合数据结构(列表嵌套字典)与文件持久化(JSON),这是迈向真正实用软件的核心一步。
1. 完整实现代码
# todo_manager.py
import json
import os

DATA_FILE = "todo_data.json"

def load_tasks():
    """从磁盘加载任务列表,若文件不存在则初始化为空列表"""
    if not os.path.exists(DATA_FILE):
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, IOError):
        print("【警告】待办数据读取异常,已初始化为空列表。")
        return []

def save_tasks(tasks):
    """将任务列表持久化保存至 JSON 文件"""
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        json.dump(tasks, f, ensure_ascii=False, indent=2)

def show_tasks(tasks):
    """格式化展示当前所有任务"""
    if not tasks:
        print("\n当前没有待办事项,清单是空的。")
        return
    print("\n--- 当前待办事项清单 ---")
    for idx, item in enumerate(tasks, 1):
        status = "[已完成]" if item["done"] else "[未完成]"
        print(f"{idx}. {status} {item['title']}")
    print("------------------------\n")

def main():
    tasks = load_tasks()
    while True:
        print("\n待办管理: 1.查看 | 2.添加 | 3.标记完成 | 4.删除 | 5.保存并退出")
        choice = input("请选择操作编号 (1-5): ").strip()

        if choice == "1":
            show_tasks(tasks)
        elif choice == "2":
            title = input("请输入新任务内容: ").strip()
            if title:
                tasks.append({"title": title, "done": False})
                save_tasks(tasks)
                print(f"已添加: {title}")
            else:
                print("任务内容不能为空!")
        elif choice == "3":
            show_tasks(tasks)
            idx_str = input("请输入要标记完成的任务编号: ").strip()
            if idx_str.isdigit() and 1 <= int(idx_str) <= len(tasks):
                tasks[int(idx_str) - 1]["done"] = True
                save_tasks(tasks)
                print("已更新任务状态。")
            else:
                print("无效的任务编号!")
        elif choice == "4":
            show_tasks(tasks)
            idx_str = input("请输入要删除的任务编号: ").strip()
            if idx_str.isdigit() and 1 <= int(idx_str) <= len(tasks):
                removed = tasks.pop(int(idx_str) - 1)
                save_tasks(tasks)
                print(f"已删除任务: {removed['title']}")
            else:
                print("无效的任务编号!")
        elif choice == "5":
            save_tasks(tasks)
            print("所有更改已保存,再见!")
            break
        else:
            print("未知选项,请重新选择。")

if __name__ == "__main__":
    main()
2. 核心技术点解析
- 上下文管理器:
with open(...) as f保证在发生异常或写入结束时自动关闭文件句柄,避免资源泄漏。 - 结构化序列化:使用
json.dump()保存结构化字典,配合ensure_ascii=False保证中文字符直接可读,indent=2让文件排版清晰。 - CRUD 模式雏形:实现了创建(Create)、读取(Read)、更新(Update)、删除(Delete)的基本数据生命周期。
五、项目四:批量文件重命名工具(pathlib 路径操作与安全预演机制)
这个项目带读者走出纯数据逻辑,直接操作计算机文件系统。对于初学者而言,写自动化脚本最容易犯的错误是缺乏安全防护,导致误改或覆盖重要文件。因此本项目重点引入了 Dry-run(试运行预览) 机制。
1. 完整实现代码
# batch_rename.py
from pathlib import Path

def batch_rename(target_dir, extension, prefix, dry_run=True):
    """
    对指定目录下的特定格式文件进行批量前缀与序号重命名
    :param target_dir: 目标文件夹路径
    :param extension: 目标文件后缀,例如 '.txt' 或 '.jpg'
    :param prefix: 新文件名前缀
    :param dry_run: 是否为试运行模式 (默认 True,不实际写入磁盘)
    """
    dir_path = Path(target_dir)
    if not dir_path.exists() or not dir_path.is_dir():
        print(f"【错误】路径 '{target_dir}' 不存在或不是一个有效的文件夹!")
        return

    # 获取并过滤指定后缀的文件列表,排序以确保顺序一致
    files = sorted([f for f in dir_path.iterdir() if f.is_file() and f.suffix.lower() == extension.lower()])

    if not files:
        print(f"未找到后缀为 '{extension}' 的文件。")
        return

    print(f"共发现 {len(files)} 个符合条件的文件。当前模式: {'【试运行预览】' if dry_run else '【正式执行】'}\n")

    rename_plan = []
    for index, file_path in enumerate(files, start=1):
        # 构造新名称,例如 photo_001.jpg
        new_name = f"{prefix}_{index:03d}{file_path.suffix.lower()}"
        target_path = file_path.parent / new_name
        rename_plan.append((file_path, target_path))
        print(f"计划变更: {file_path.name}  -->  {new_name}")

    if dry_run:
        print("\n提示:当前处于试运行模式,磁盘未发生任何改变。")
        confirm = input("确认按照上述方案执行重命名吗?(输入 yes 确认执行): ").strip().lower()
        if confirm == 'yes':
            # 递归调用自身,关闭 dry_run 正式执行
            batch_rename(target_dir, extension, prefix, dry_run=False)
        else:
            print("操作已取消。")
    else:
        # 正式执行重命名,防范重名冲突
        success_count = 0
        for src, dst in rename_plan:
            if dst.exists() and src != dst:
                print(f"【跳过】目标文件已存在,防止覆盖: {dst.name}")
                continue
            src.rename(dst)
            success_count += 1
        print(f"\n重命名完成!成功重命名 {success_count} 个文件。")

if __name__ == "__main__":
    # 使用示例:将当前目录下的 test_docs 文件夹中的所有 txt 文件重命名为 doc_001.txt ...
    sample_dir = "./test_docs"
    # 可根据测试需求调用:
    # batch_rename(sample_dir, ".txt", "doc")
2. 核心技术点解析
- 现代面向对象路径库:使用标准库
pathlib.Path替代传统的os.path,支持用/运算符自然拼接路径,具有跨平台(Windows/macOS/Linux)原生兼容性。 - 格式化序号对齐:
{index:03d}保证数字补零对齐(001, 002...),避免在按文件名排序时出现“1, 10, 2”的错乱排序问题。 - 防御性编程思维:通过
dry_run打印方案并让用户二次确认,重命名时检查dst.exists(),彻底避免因代码逻辑失误造成不可挽回的文件覆盖。
六、项目五:简单网页信息爬虫(HTTP 请求与 DOM 解析)
完成前四个项目后,读者已经具备处理本地数据与控制流的能力。项目五将场景延伸到互联网,利用成熟生态库 requests 和 BeautifulSoup4 编写一个合规的微型爬虫,提取公开网页的列表数据。
1. 环境准备与依赖安装
# 在终端中安装基础三方库
pip install requests beautifulsoup4
2. 完整实现代码
# simple_scraper.py
import requests
from bs4 import BeautifulSoup

def fetch_top_stories(target_url):
    """
    爬取指定页面的新闻标题与对应链接
    """
    # 模拟真实浏览器的请求头,避免被服务器直接识别为非人类脚本
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    print(f"正在发起请求: {target_url} ...")
    try:
        # 设置 timeout 防止网络挂起无限等待
        response = requests.get(target_url, headers=headers, timeout=10)
        # 验证 HTTP 状态码是否为 200,若为 4xx 或 5xx 会主动抛出异常
        response.raise_for_status()

        # 确保编码正确解析
        response.encoding = response.apparent_encoding
        html_content = response.text

    except requests.exceptions.Timeout:
        print("【网络超时】请求服务器超时,请检查网络或稍后重试。")
        return []
    except requests.exceptions.RequestException as err:
        print(f"【网络错误】请求失败: {err}")
        return []

    # 解析 HTML 文档树
    soup = BeautifulSoup(html_content, "html.parser")
    results = []

    # 假设目标网页的新闻列表容器为文章或带有特定样式的超链接
    # 此处使用通用选择器寻找页面中的典型文章超链接
    links = soup.find_all("a", href=True)

    for a in links:
        title = a.get_text(strip=True)
        href = a['href']
        # 过滤过短的导航链接或纯锚点链接
        if len(title) >= 8 and href.startswith("http"):
            results.append({"title": title, "url": href})
            if len(results) >= 10:  # 限制提取前10条
                break

    return results

def main():
    # 使用 Hacker News 首页作为规范合规的公开数据源进行演示
    target = "https://news.ycombinator.com/"
    stories = fetch_top_stories(target)

    if stories:
        print(f"\n成功提取到 {len(stories)} 条热门资讯:")
        for idx, item in enumerate(stories, 1):
            print(f"{idx:02d}. {item['title']}")
            print(f"    链接: {item['url']}")
    else:
        print("未提取到有效数据。")

if __name__ == "__main__":
    main()
3. 核心技术点解析
- 网络防挂起:
requests.get()必须配置timeout。没有超时的网络请求一旦遭遇丢包,程序会永久阻塞。 - 请求头伪装:提供基础的
User-Agent是 Web 开发与调试的标准礼节,能够避免许多服务端针对无头客户端的硬拦截。 - DOM 提炼与容错:使用
BeautifulSoup的 CSS 选择器或find_all()定位标签,使用get_text(strip=True)清洗首尾空白字符,并对属性是否存在做校验,防止抛出KeyError。
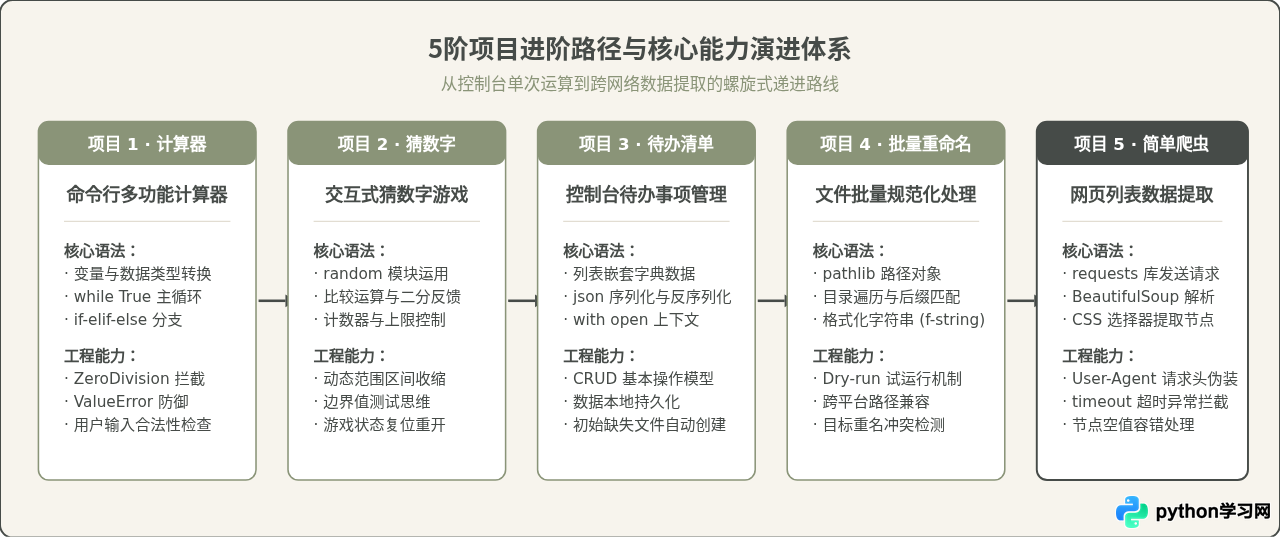
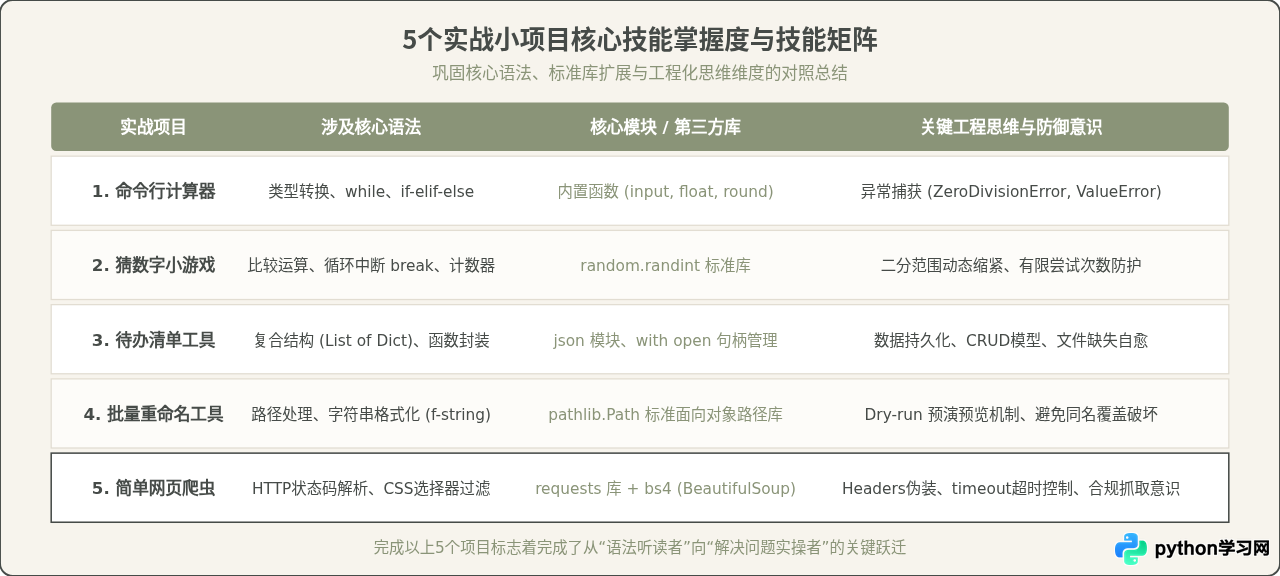
七、5个项目核心技能对照与成长矩阵
回顾这 5 个项目,难度曲线并不是随意堆砌的,而是严格按照软件工程中“数据输入 → 内部处理 → 外部持久化 → 操作系统管理 → 分布式网络提取”的递进逻辑设计的:
八、总结与后续进阶建议
通过亲手敲出并调试通这 5 个项目,你所获得的不仅是 5 个脚本文件,更重要的是掌握了以下三项不可或缺的底层编程能力:
- 防御性编码本能:在每一个涉及输入、除法、文件 IO、网络调用的节点,都主动预判“如果用户输错”、“如果文件不存在”、“如果网络超时”该如何兜底。
- 标准库与生态库的权衡:学会先用好 Python 强大的内置武器(如
random,json,pathlib),在遇到专业领域问题时(如 HTTP 解析)再精准引入高质量三方库(如requests,bs4)。 - 从脚本到工程的模块化意识:将程序划分为清晰的函数职责边界(如
load_tasks、save_tasks、show_tasks),为未来开发复杂大型项目打下坚实的基础。
当这 5 个项目全部能够独立编写和调优后,下一步建议尝试面向对象编程(OOP)、引入 SQLite 数据库替代普通文件,以及尝试编写带有图形界面的轻量小应用。编程的世界自此真正为你打开。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









