


Python 2.7环境下Scrapy框架完整安装指南
本文详细记录了在Python 2.7环境下安装Scrapy框架的全过程。针对Scrapy不支持Python 3.x的特性,介绍了从环境配置到依赖库安装的步骤。重点解决了pip安装时因中文用户目录导致的编码异常,以及lxml编译所需的VC环境依赖问题,提供了通过sitecustomize.py和VcForPython解决报错的具体方案,确保用户能顺利部署爬虫框架。
2026-10-13
7
本文详细记录了在Python 2.7环境下安装Scrapy框架的全过程。针对Scrapy不支持Python 3.x的特性,介绍了从环境配置到依赖库安装的步骤。重点解决了pip安装时因中文用户目录导致的编码异常,以及lxml编译所需的VC环境依赖问题,提供了通过sitecustomize.py和VcForPython解决报错的具体方案,确保用户能顺利部署爬虫框架。
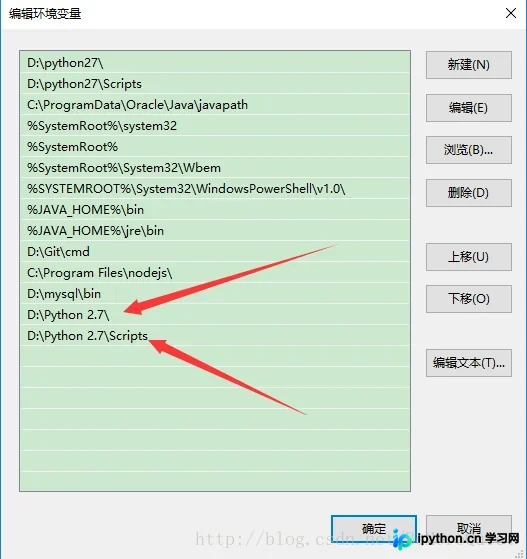
本文深入解析Python反射机制,重点介绍如何通过类名动态获取类的实例对象,以及如何通过方法名动态获取并调用方法。文章详细对比了两种主要实现方式:利用globals字典直接访问类,以及使用__import__结合getattr函数动态加载模块。通过具体代码示例,帮助开发者理解反射在提高代码灵活性和扩展性方面的实际应用。
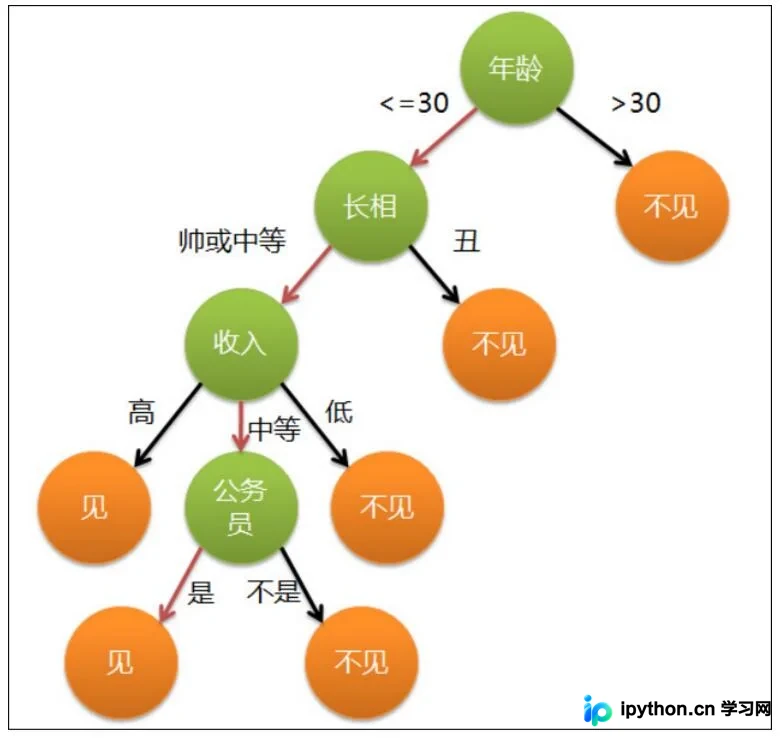
本文详细介绍基于Python实现的决策树分类算法。通过通俗案例解析决策树构建逻辑,深入讲解信息熵与信息增益的计算方法,并展示如何利用Python代码自动构建最优决策树,适用于数据分类与预测场景。
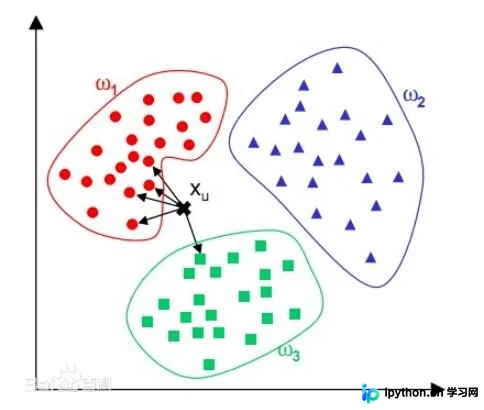
本文详细解析Python中KNN(K-Nearest Neighbor)分类算法的实现原理与代码。通过鸢尾花数据集,演示如何加载数据、计算欧拉与曼哈顿距离,并完成分类预测。文章包含完整Python代码示例及测试集结果分析,探讨算法鲁棒性与计算开销,适合机器学习初学者参考。
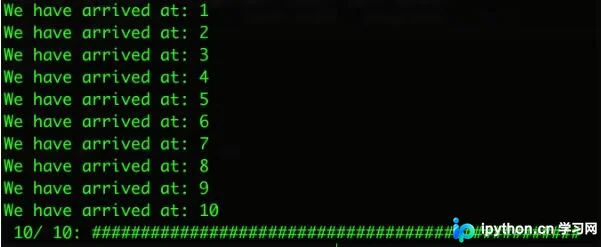
本文详解如何在Python控制台实现动态进度条。核心在于利用sys.stdout.write替代print,配合\r转义符将光标移至行首,并通过sys.stdout.flush()强制刷新缓冲区。文章涵盖解决旧字符残留、固定底部输出及封装类实现等常见问题,适用于爬虫、机器学习等耗时任务的可视化监控。
本文深入解析Python中eval()与exec()函数的核心区别,详细阐述globals()、locals()及compile()函数的定义、参数与返回值机制。通过代码实例说明命名空间在动态执行中的作用,并对比Python 2与Python 3中exec语句的变化,帮助开发者安全高效地使用动态代码执行功能。
本文详细介绍Python中字典的多种遍历方式,包括items()与iteritems()的区别,以及利用zip()合并序列。重点讲解如何使用sorted函数结合lambda表达式对字典按键或键值进行升序和降序排序,并提供完整代码示例与参数说明。
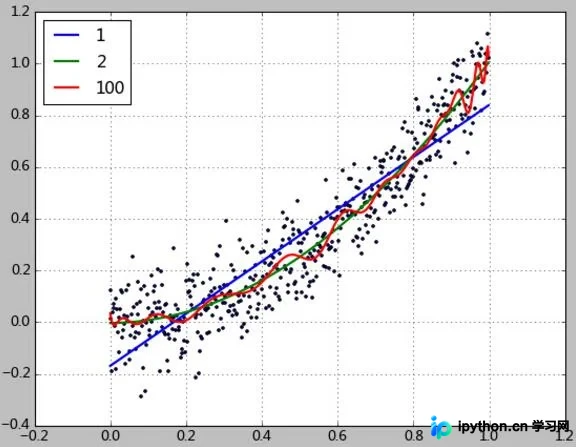
本文详解Python中多项式回归的实现与误差评估,通过对比1次、2次及100次多项式拟合结果,深入剖析过拟合现象。文章指出高次多项式虽提升训练集R2值但预测能力极差,并引入岭回归等正则化方法,通过限制系数大小有效解决过拟合问题,提升模型泛化能力。
本文介绍如何利用Python的函数式编程特性处理Splunk导出的CSV日志数据。通过封装DictReader、应用生成器过滤与投影、使用SimpleNamespace简化属性访问,以及构建Map-Reduce管道,实现灵活的数据探索。文章详细讲解了如何动态调整转换逻辑以分析RESTful API性能,并展示了如何结合Counter和statistics模块进行统计聚合。
本文分享了Python中获取最大最小值的两种赋值方式。通过对比max/min函数与sorted排序,展示了在比较两个数时,使用sorted((dx, dy))能减少代码输入,提升简洁性。
本文详细讲解在 Windows 环境下安装 Python 3.4.4 及 NumPy 库的完整流程。内容涵盖从官网下载、环境变量 PATH 配置、pip 工具安装,到通过 .whl 文件安装 NumPy 的具体命令行操作。特别针对 Windows 系统用户,提供了验证安装成功及解决常见报错的实用步骤,旨在帮助用户高效完成开发环境搭建。
本文详细介绍Python中列表的三种创建方式:普通列表、混合类型列表及空列表。重点解析向列表添加元素的三种核心方法:append用于追加单个元素,extend用于合并列表需注意括号内需为列表形式,以及insert用于在指定索引位置插入元素。通过代码示例展示各方法的具体操作与结果差异。