

Python多项式回归与过拟合分析:从基础拟合到正则化解决方案

本文详解Python中多项式回归的实现与误差评估,通过对比1次、2次及100次多项式拟合结果,深入剖析过拟合现象。文章指出高次多项式虽提升训练集R2值但预测能力极差,并引入岭回归等正则化方法,通过限制系数大小有效解决过拟合问题,提升模型泛化能力。
在机器学习领域,预测任务主要划分为回归与分类两大类别。
简而言之,回归旨在预测连续数值,而分类则是为数据分配标签并进行归类。
本文将介绍如何利用Python执行基本的数据拟合操作,并深入分析拟合结果的误差表现。
本示例通过构建一个二次函数并叠加随机扰动,生成500个数据点,随后分别尝试使用1次、2次以及100次多项式对这些数据进行拟合处理。
拟合的核心目标在于基于训练数据构建出一个多项式函数,该函数需既能精准匹配现有数据,又能对未知数据进行有效预测。
具体实现代码如下:
import matplotlib.pyplot as plt
import numpy as np
import scipy as sp
from scipy.stats import norm
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn import linear_model

''''' 数据生成 '''
x = np.arange(0, 1, 0.002)
y = norm.rvs(0, size=500, scale=0.1)
y = y + x**2

''''' 均方误差根 '''
def rmse(y_test, y):
 return sp.sqrt(sp.mean((y_test - y) ** 2))

''''' 与均值相比的优秀程度,介于[0~1]。0表示不如均值。1表示完美预测.这个版本的实现是参考scikit-learn官网文档 '''
def R2(y_test, y_true):
 return 1 - ((y_test - y_true)**2).sum() / ((y_true - y_true.mean())**2).sum()


''''' 这是Conway&White《机器学习使用案例解析》里的版本 '''
def R22(y_test, y_true):
 y_mean = np.array(y_true)
 y_mean[:] = y_mean.mean()
 return 1 - rmse(y_test, y_true) / rmse(y_mean, y_true)


plt.scatter(x, y, s=5)
degree = [1,2,100]
y_test = []
y_test = np.array(y_test)


for d in degree:
 clf = Pipeline([('poly', PolynomialFeatures(degree=d)),
     ('linear', LinearRegression(fit_intercept=False))])
 clf.fit(x[:, np.newaxis], y)
 y_test = clf.predict(x[:, np.newaxis])

 print(clf.named_steps['linear'].coef_)
 print('rmse=%.2f, R2=%.2f, R22=%.2f, clf.score=%.2f' %
  (rmse(y_test, y),
  R2(y_test, y),
  R22(y_test, y),
  clf.score(x[:, np.newaxis], y)))

 plt.plot(x, y_test, linewidth=2)

plt.grid()
plt.legend(['1','2','100'], loc='upper left')
plt.show()
程序运行后的显示结果如下:
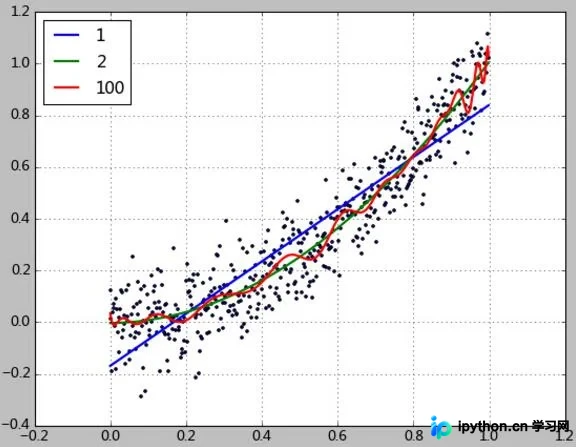
[-0.16140183 0.99268453] rmse=0.13, R2=0.82, R22=0.58, clf.score=0.82 [ 0.00934527 -0.03591245 1.03065829] rmse=0.11, R2=0.88, R22=0.66, clf.score=0.88 [ 6.07130354e-02 -1.02247150e+00 6.66972089e+01 -1.85696012e+04 ...... -9.43408707e+12 -9.78954604e+12 -9.99872105e+12 -1.00742526e+13 -1.00303296e+13 -9.88198843e+12 -9.64452002e+12 -9.33298267e+12 -1.00580760e+12] rmse=0.10, R2=0.89, R22=0.67, clf.score=0.89 输出中的coef_即为多项式的参数。以1次拟合为例,其结果可表示为 y = 0.99268453x -0.16140183
在此过程中,需要重点关注以下几个方面:
1、误差分析。
在回归分析中,常用的误差指标包括均方误差根(RMSE)和R-平方(R2)。
RMSE是预测值与真实值之间误差平方根的均值。这种度量方式应用广泛(例如Netflix机器学习比赛的评价标准),属于一种定量的权衡评估方法。
R2方法通过比较预测值与仅使用均值预测的情况,来评估模型的性能提升程度。其取值区间通常在(0,1)之间。0表示模型表现不如直接取均值,而1表示所有预测值与真实结果完美匹配。 R2的具体计算方法在不同文献中略有差异。本文中的R2函数依据scikit-learn官网文档实现,与clf.score函数的结果保持一致。
而R22函数的实现源自Conway的著作《机器学习使用案例解析》,其区别在于采用两个RMSE的比值来计算R2。 从结果可见,当多项式次数为1时,尽管拟合效果不佳,R2仍能达到0.82。2次多项式将其提升至0.88。然而,当次数增加到100次时,R2仅微增至0.89。
2、过拟合。
使用100次多项式进行拟合,虽然训练效果有所提升,但该模型的预测能力却极其糟糕。 此外,观察多项式系数可以发现,出现了大量极大数值,甚至高达10的12次方。 为此,我们修改代码,从训练集中移除500个样本中的最后2个,但在测试阶段仍使用全部500个样本进行验证。 clf.fit(x[:498, np.newaxis], y[:498]) 经过上述修改后,多项式拟合结果如下:
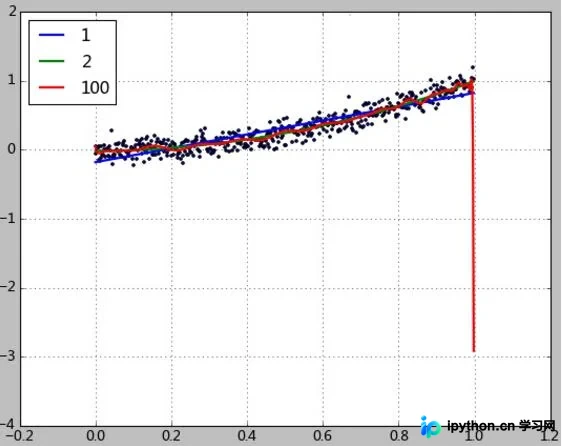
[-0.17933531 1.0052037 ] rmse=0.12, R2=0.85, R22=0.61, clf.score=0.85 [-0.01631935 0.01922011 0.99193521] rmse=0.10, R2=0.90, R22=0.69, clf.score=0.90 ... rmse=0.21, R2=0.57, R22=0.34, clf.score=0.57
仅仅缺失了最后2个训练样本,红线(代表100次多项式拟合结果)的预测便发生了剧烈偏差,R2值也急剧下降至0.57。 相比之下,1次和2次多项式的拟合结果中,R2反而略有上升。
这表明高次多项式过度拟合了训练数据,包括其中的大量噪声,导致其完全丧失了对数据趋势的预测能力。前文也提到,100次多项式拟合出的系数数值极其巨大。人们自然想到,通过在拟合过程中限制这些系数数值的大小,来避免生成这种畸形的拟合函数。
其基本原理是将拟合多项式的所有系数绝对值之和(L1正则化)或者平方和(L2正则化)作为惩罚项加入模型,并指定一个惩罚力度因子w,从而避免产生这种畸形系数。 这一思想应用于岭(Ridge)回归(使用L2正则化)、Lasso法(使用L1正则化)、弹性网(Elastic net,使用L1+L2正则化)等方法中,均能有效避免过拟合。更多原理可参考相关资料。
下面以岭回归为例,验证100次多项式拟合的有效性。修改代码如下:
clf = Pipeline([('poly', PolynomialFeatures(degree=d)), ('linear', linear_model.Ridge ())]) clf.fit(x[:400, np.newaxis], y[:400])
运行结果如下:
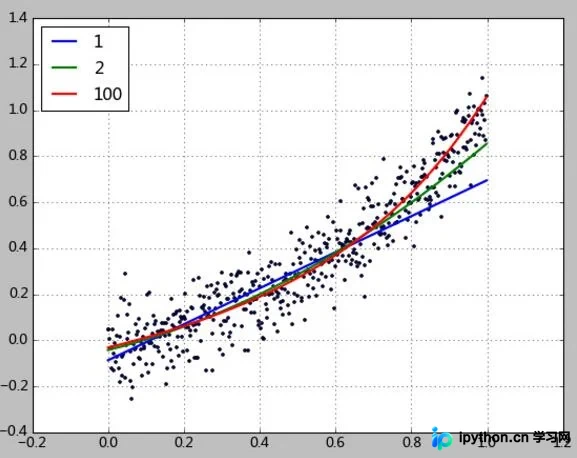
[ 0. 0.75873781] rmse=0.15, R2=0.78, R22=0.53, clf.score=0.78 [ 0. 0.35936882 0.52392172] rmse=0.11, R2=0.87, R22=0.64, clf.score=0.87 [ 0.00000000e+00 2.63903249e-01 3.14973328e-01 2.43389461e-01 1.67075328e-01 1.10674280e-01 7.30672237e-02 4.88605804e-02 ...... 3.70018540e-11 2.93631291e-11 2.32992690e-11 1.84860002e-11 1.46657377e-11] rmse=0.10, R2=0.90, R22=0.68, clf.score=0.90
可以看到,100次多项式的系数参数变得非常小,大部分接近于0。 另外值得注意的是,在使用岭回归等惩罚模型后,1次和2次多项式回归的R2值可能会略低于基本线性回归。
然而,这样的模型即使使用100次多项式,在训练400个样本并预测500个样本的情况下,不仅拥有更小的R2误差,还具备优秀的预测能力。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









