

Python实现决策树分类算法详解:从原理到代码

本文详细介绍基于Python实现的决策树分类算法。通过通俗案例解析决策树构建逻辑,深入讲解信息熵与信息增益的计算方法,并展示如何利用Python代码自动构建最优决策树,适用于数据分类与预测场景。
本文分享使用Python实现决策树分类算法的具体代码示例,供读者参考学习。
1、概述
决策树(decision tree)是一种应用广泛的分类算法。
与贝叶斯算法相比,决策树在构建过程中无需依赖特定的领域知识或进行参数预设。
在实际应用中,特别是在探索性知识发现场景下,决策树具有更高的适用性。
2、算法思想
通俗理解,决策树的分类逻辑类似于人们寻找伴侣时的决策过程。假设一位母亲为女儿介绍男朋友,双方对话如下:
女儿:多大年纪了?
母亲:26岁。
女儿:长得帅不帅?
母亲:挺帅的。
女儿:收入高吗?
母亲:不算很高,属于中等水平。
女儿:是公务员吗?
母亲:是,在税务局工作。
女儿:好的,我去见见。
这个女孩的决策过程就是一个典型的分类树决策实例。
其本质是通过年龄、外貌、收入以及是否公务员这几个特征,将男性分为“见”与“不见”两类。
假设该女孩对男性的筛选标准为:30岁以下、长相中等以上,且满足高收入或中等以上收入的公务员条件。这一逻辑可通过下图展示:
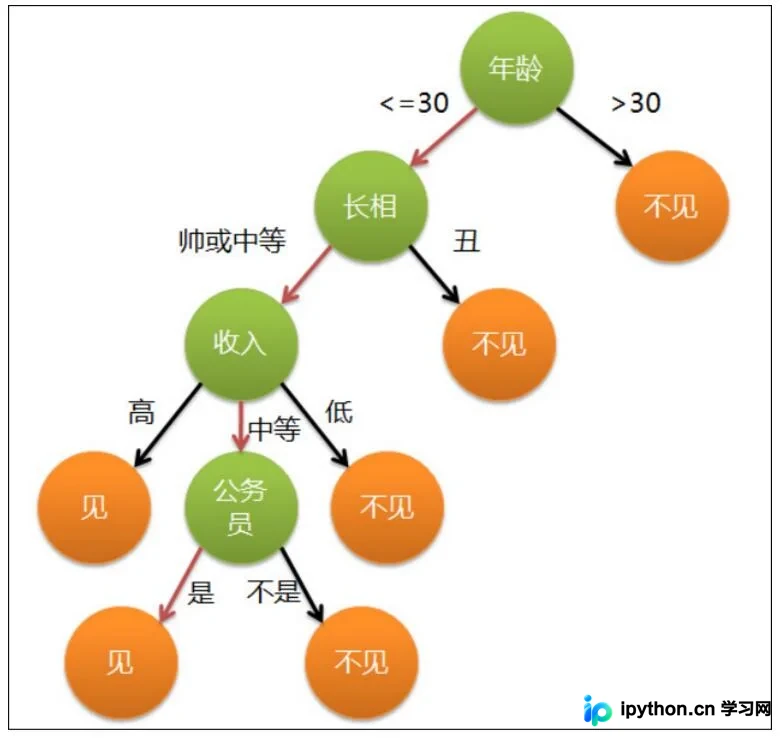
上图完整表达了该女孩决定是否见面的策略,其中:
◊绿色节点代表判断条件
◊橙色节点代表决策结果
◊箭头表示在不同判断条件下所走的决策路径
图中红色箭头标示了上述例子中女孩的具体决策路径。
这幅图基本构成了一颗决策树,之所以称其“基本可以算”,是因为图中的判定条件尚未量化(如收入的高、中、低等),因此还达不到严格意义上的决策树标准;若将所有条件量化,则成为真正的决策树。
决策树分类算法的核心在于根据“先验数据”构建一棵最优决策树,从而用于预测未知数据的类别。
决策树是一个树形结构,可以是二叉树也可以是非二叉树。每个非叶节点代表对某个特征属性的测试,每个分支代表该特征属性在特定值域上的输出,而每个叶节点存储一个类别标签。使用决策树进行决策的过程是从根节点开始,测试待分类项对应的特征属性,并根据其值选择输出分支,直到到达叶子节点,将叶子节点存储的类别作为最终决策结果。
3、决策树构造
假设有以下判断苹果好坏的数据样本:
样本 红 大 好苹果
0 1 1 1
1 1 0 1
2 0 1 0
3 0 0 0
样本包含两个属性:A0表示是否红苹果,A1表示是否大苹果。若需根据此数据样本构建一棵能自动判断苹果好坏的决策树。
由于本例数据仅有两个属性,我们可以穷举所有可能构造出的决策树,共2棵,如下图所示:
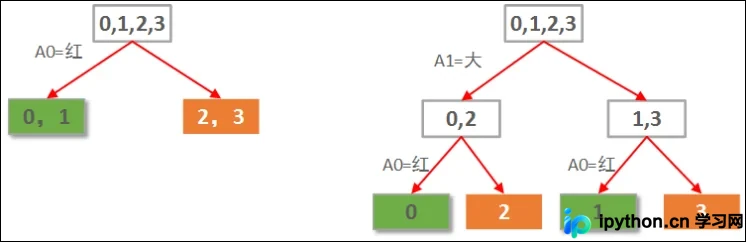
显然,左侧先使用A0(红色)作为划分依据的决策树优于右侧使用A1(大小)作为划分依据的决策树。
这仅是直觉判断,而直觉难以直接转化为程序实现,因此需要一种定量评估方法来评价这两棵树的性能优劣。
决策树评估所采用的定量考察方法为计算每种划分情况的信息熵增益:
若经过某个选定属性进行数据划分后,信息熵下降幅度最大,则该划分属性为最优选择。
属性划分选择(即构造决策树)的依据:
简而言之,熵衡量的是“无序”或“混乱”的程度。
通过具体计算来理解:
1、原始样本数据的熵:
样例总数:4
好苹果:2
坏苹果:2
熵: -(1/2 * log(1/2) + 1/2 * log(1/2)) = 1
信息熵为1表示当前处于最混乱、最无序的状态。
2、两颗决策树的划分结果熵增益计算
树1先选A0作划分,各子节点信息熵计算如下:
0,1叶子节点有2个正例,0个负例。信息熵为:e1 = -(2/2 * log(2/2) + 0/2 * log(0/2)) = 0。
2,3叶子节点有0个正例,2个负例。信息熵为:e2 = -(0/2 * log(0/2) + 2/2 * log(2/2)) = 0。
因此选择A0划分后的信息熵为每个子节点信息熵所占比重的加权和:E = e1*2/4 + e2*2/4 = 0。
选择A0做划分的信息熵增益G(S, A0)=S - E = 1 - 0 = 1。
事实上,决策树叶子节点表示数据已属于相同类别,因此其信息熵必然为0。
树2先选A1作划分,各子节点信息熵计算如下:
0,2子节点有1个正例,1个负例。信息熵为:e1 = -(1/2 * log(1/2) + 1/2 * log(1/2)) = 1。
1,3子节点有1个正例,1个负例。信息熵为:e2 = -(1/2 * log(1/2) + 1/2 * log(1/2)) = 1。
因此选择A1划分后的信息熵为每个子节点信息熵所占比重的加权和:E = e1*2/4 + e2*2/4 = 1。也就是说,划分后的效果与未划分相同。
选择A1做划分的信息熵增益G(S, A1)=S - E = 1 - 1 = 0。
因此,每次划分前,只需计算出信息熵增益最大的那种划分方式即可。
先做A0划分时的信息熵增益为1,大于先做A1划分时的信息熵增益,因此先做A0划分是最优选择。
4、算法指导思想
经过决策属性的划分后,数据的无序度逐渐降低,即信息熵逐渐减小。
5、算法实现
梳理数据中的属性。
比较按特定属性划分后数据的信息熵增益,选择信息熵增益最大的属性作为第一划分依据,随后继续选择第二属性,以此类推。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









