Python取余与取整操作详解:%、divmod及规则解析
本文详细介绍Python中实现取余操作的方法,包括使用求模运算符(%)和divmod()函数。内容涵盖利用余数判断奇偶数、获取商与余数,并深入解析Python中//、int()及round()的取整规则,以及%运算符余数符号由被除数决定的特性,附带代码示例说明。
2026-10-14
22
本文详细介绍Python中实现取余操作的方法,包括使用求模运算符(%)和divmod()函数。内容涵盖利用余数判断奇偶数、获取商与余数,并深入解析Python中//、int()及round()的取整规则,以及%运算符余数符号由被除数决定的特性,附带代码示例说明。
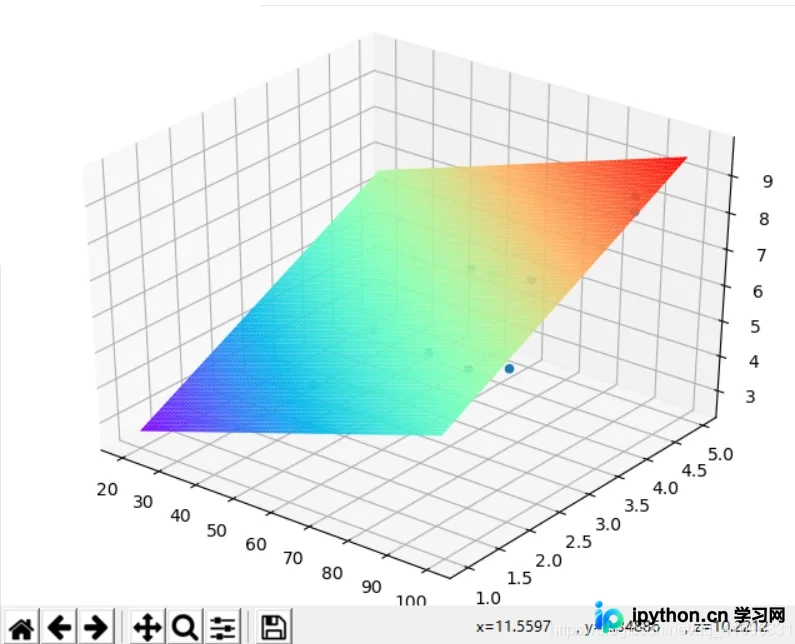
本文详细介绍如何使用Python实现梯度下降算法。通过SymPy库进行符号变量定义与偏导数自动求解,结合Matplotlib绘制3D散点图与拟合平面,直观验证算法结果。文章涵盖Python版本选择、数据集构建及核心代码实现,适合机器学习初学者参考。
本文深入解析Python中的高阶函数概念,通过实例演示map、reduce和filter三大内置函数的具体用法。文章详细说明了如何将函数作为参数传递,并展示了如何利用map进行元素映射、reduce进行累积计算以及filter进行条件过滤,帮助开发者掌握Python函数式编程的核心技巧。
本文深入解析Python内置sys模块的核心功能。通过sys.argv实现外部参数传递,利用sys.path动态添加模块搜索路径以优化import机制,并介绍sys.exit进行程序控制退出。此外,涵盖sys.stdin/stdout/stderr对标准I/O流的直接操作及sys.modules缓存机制,帮助开发者掌握Python运行环境的关键变量与函数。
Python是一种跨平台的高级脚本语言,兼具解释性与编译性特征,并深度支持面向对象编程。它广泛应用于Web开发、人工智能、科学计算及自动化脚本等领域。本文解析Python作为解释型语言的运行机制、语法简洁性及其在AI开发中的独特优势,帮助初学者理解其核心价值。
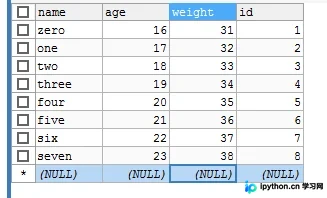
本文介绍在Python中利用多线程和数据库连接池优化大量数据查询的方法。通过对比普通循环查询与多线程并发查询的执行结果,展示如何限制最大连接数和线程数,从而减少CPU等待IO的时间,提升程序运行效率。
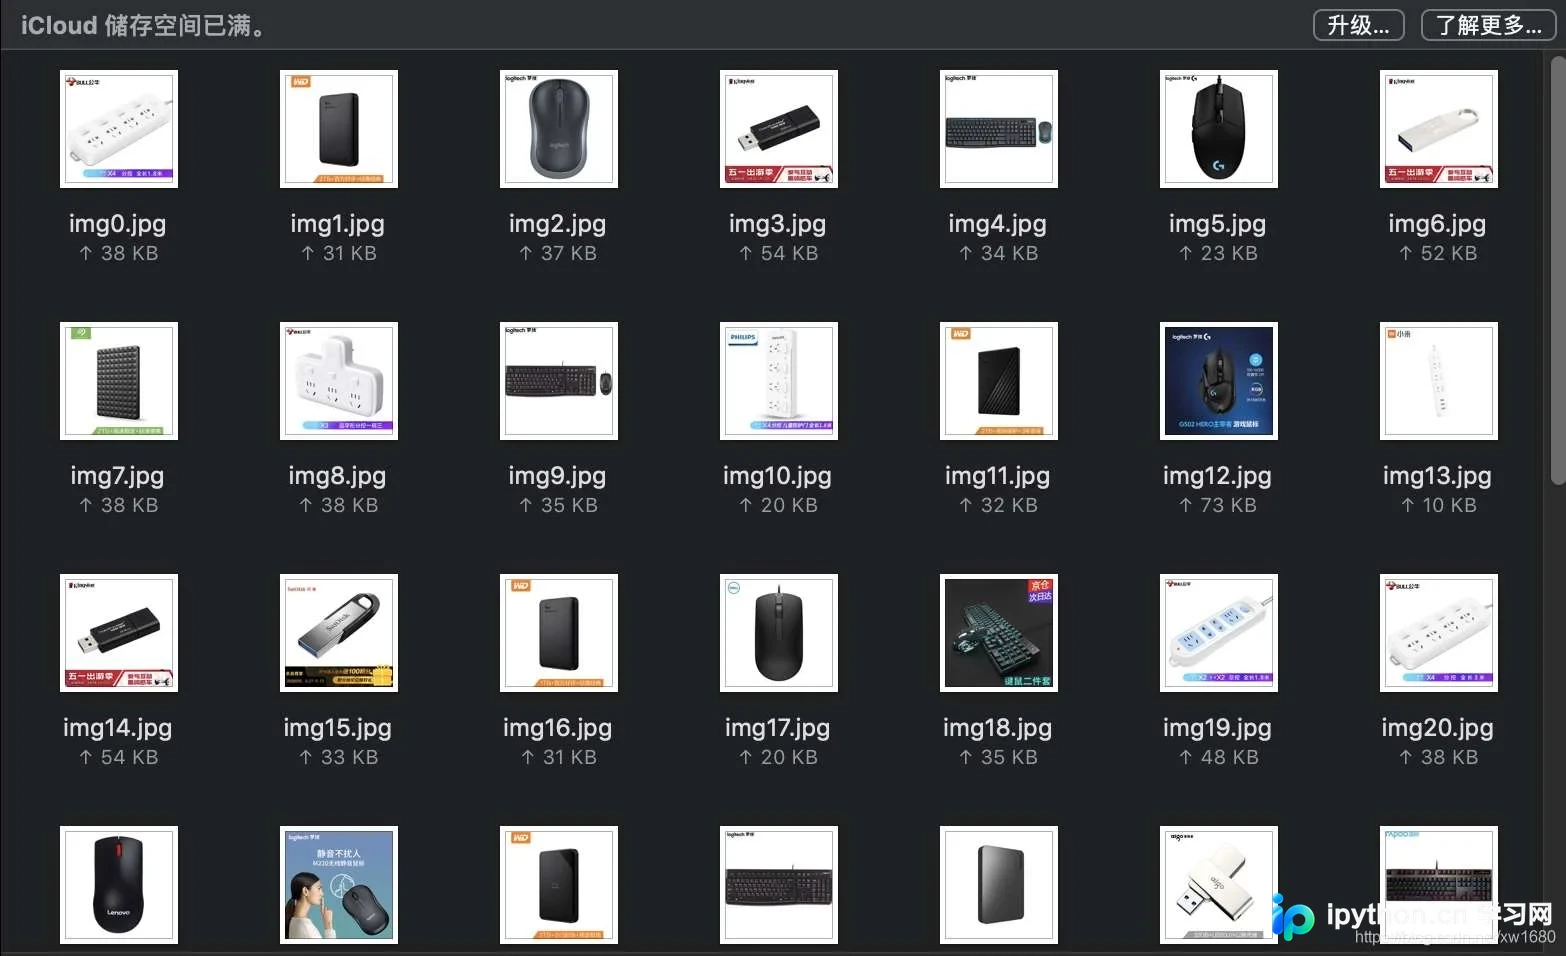
本文介绍如何在Python中使用urllib模块的urlretrieve函数直接下载远程图片。通过示例演示了如何指定本地保存路径、利用回调函数显示下载进度,以及处理POST数据。代码示例展示了抓取网页图片并保存至本地的完整流程,包含进度监控和文件管理逻辑。
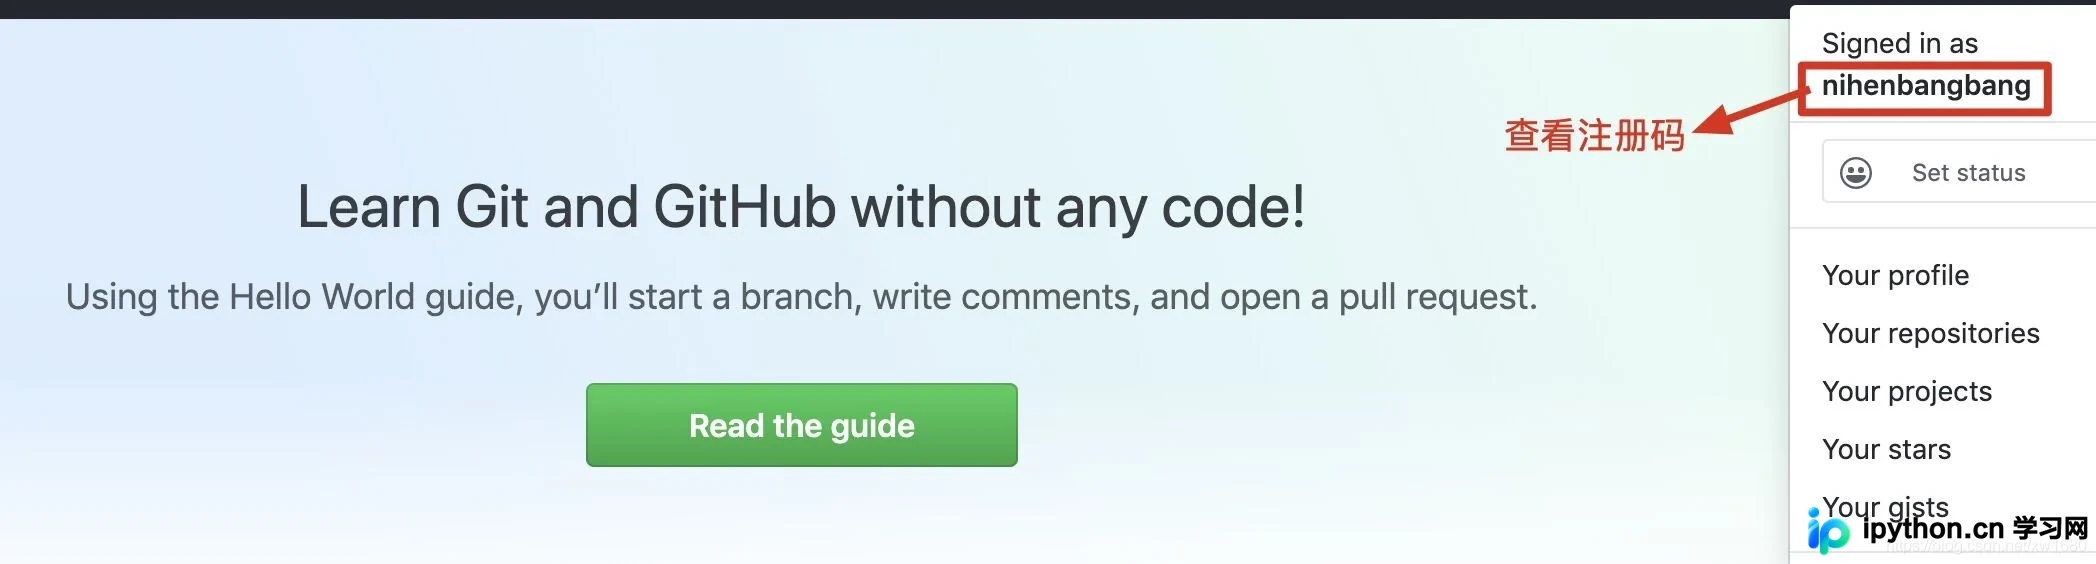
本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
本文详细介绍如何利用 Python 内置的 zipfile 和 tarfile 标准库处理压缩包。无需安装第三方软件,即可实现 zip 和 tar 格式文件的读取、列表获取、单文件及批量解压,以及创建包含不同压缩算法(如 gzip、bzip2)的压缩包。内容涵盖核心类 ZipFile 和 TarFile 的使用方法及代码示例,帮助开发者高效管理文件归档。
本文详解如何在Python中使用多线程加速pandas的apply操作。通过对比多线程与多进程,介绍利用multiprocessing.Pool进行数据分割与并行执行的方法,包含进程初始化、共享变量设置及完整代码示例,帮助提升数据处理效率。
本文详解 Python 标准库 logging 模块的核心用法。从基础日志打印到高级配置,涵盖 Logger、Handler、Formatter 三大组件协作机制,演示 basicConfig 与文件配置两种方式,帮助开发者建立规范的日志记录习惯,提升系统调试与故障排查效率。
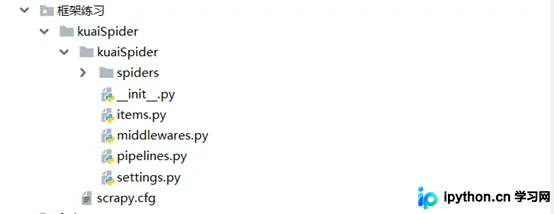
本文深入解析Python Scrapy框架的核心架构与工作流程。Scrapy基于Twisted异步网络库,由引擎、调度器、下载器、爬虫及管道等组件协同工作,高效实现网页数据抓取。文章详细阐述了各组件职责,并提供了从创建项目到生成爬虫的完整命令示例,帮助开发者快速掌握这一强大爬虫工具的基础应用。