

Python读取文件大小的两种方法:os.path.getsize与pathlib
详细介绍在Python中读取文件大小的两种主流方法:经典模块os.path.getsize与现代面向对象模块pathlib,剖析底层机制、异常处理、可读单位换算及实际开发中的选型建议。
在 Python 开发中,获取磁盘上某个文件占用的字节大小是一项高频基础任务。标准库主要提供了两条途径:历史悠久、直接便捷的 os.path.getsize() 函数,以及 Python 3.4 引入、现代风格的 pathlib.Path.stat().st_size。两者的核心目标完全一致,底层均调用操作系统的 stat 系统调用读取文件元数据并返回整数形式的字节数(Bytes),但在编程范式、调用链路以及周边功能的组合能力上存在鲜明的风格差异。
一、方法一:使用 os.path.getsize 读取文件大小
os.path.getsize 属于 Python 经典的文件路径处理工具,定义在 os.path 模块中。该函数接收文件路径(支持字符串或 PathLike 对象)作为参数,直接返回目标文件的字节数。
1. 基础用法与代码示例
在确认文件存在的前提下,直接调用 os.path.getsize(path) 即可获得结果:
import os

# 定义待读取的目标文件路径
file_path = "sample_data.csv"

# 检查路径是否存在且确为文件
if os.path.isfile(file_path):
    file_bytes = os.path.getsize(file_path)
    print(f"文件大小为:{file_bytes} 字节 (Bytes)")
else:
print(f"路径不存在或非普通文件:{file_path}")文件大小为:245760 字节 (Bytes)
2. 异常捕获与健壮性处理
在实际生产环境中,若传入的路径不存在,或当前程序进程缺少对应目录的访问读取权限,os.path.getsize 会直接抛出 FileNotFoundError 或 PermissionError(它们都继承自 OSError)。先做 os.path.exists() 检查在并发环境下存在“检查时存在但读取时已删除”(TOCTOU 竞态条件)的风险,因此推荐使用 try...except 结构:
import os

file_path = "app.log"

try:
    size_in_bytes = os.path.getsize(file_path)
    print(f"读取成功,文件大小: {size_in_bytes} 字节")
except FileNotFoundError:
    print(f"错误:指定的文件不存在 -> {file_path}")
except PermissionError:
    print(f"错误:当前权限不足,无法访问该文件 -> {file_path}")
except OSError as err:
    print(f"读取文件元数据失败: {err}")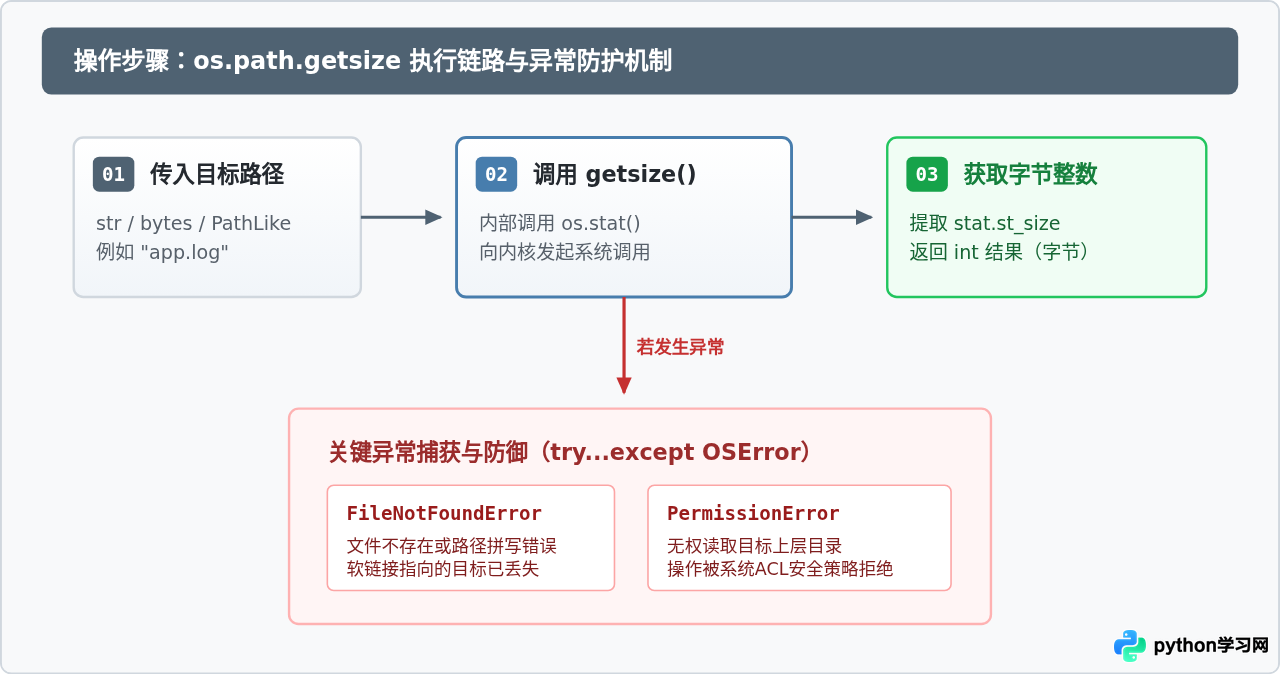
二、方法二:使用 pathlib 模块读取文件大小
Python 3.4 开始引入了 pathlib 模块(并在 PEP 519 之后深度整合进标准库各个组件)。它采用面向对象的设计思想,将文件系统中的路径建模为对象,而不是普通的字符串。
1. 基础用法与对象调用
使用 pathlib 时,首先基于路径字符串构造一个 Path 实例,随后调用其实例方法 stat()。stat() 会返回一个包含丰富元数据的 os.stat_result 对象,其中的 st_size 属性即为文件的大小:
from pathlib import Path

# 构建 Path 对象
file_path = Path("sample_data.csv")

# 检查文件是否存在且确为文件
if file_path.is_file():
    # 通过 stat() 读取元数据对象并提取 st_size 属性
    file_bytes = file_path.stat().st_size
    print(f"Pathlib 读取大小为:{file_bytes} 字节 (Bytes)")
else:
print(f"路径无效或非文件:{file_path}")Pathlib 读取大小为:245760 字节 (Bytes)
2. 为什么 pathlib 更适合现代代码?
Path 对象的优势在于它的聚合性。在获取大小的同时,往往还需要判断文件扩展名、获取父目录、或者检查最后修改时间。如果使用 os 模块,开发者需要在 os.path.getsize、os.path.splitext、os.path.dirname、os.path.getmtime 之间反复切换并传递字符串;而 pathlib 将所有相关能力内聚在同一个对象中:
from pathlib import Path
from datetime import datetime

p = Path("sample_data.csv")

if p.exists():
    stat_info = p.stat()
    print("文件名:", p.name)
    print("扩展名:", p.suffix)
    print("父目录:", p.parent)
    print("文件大小:", stat_info.st_size, "Bytes")
    print("最后修改时间:", datetime.fromtimestamp(stat_info.st_mtime))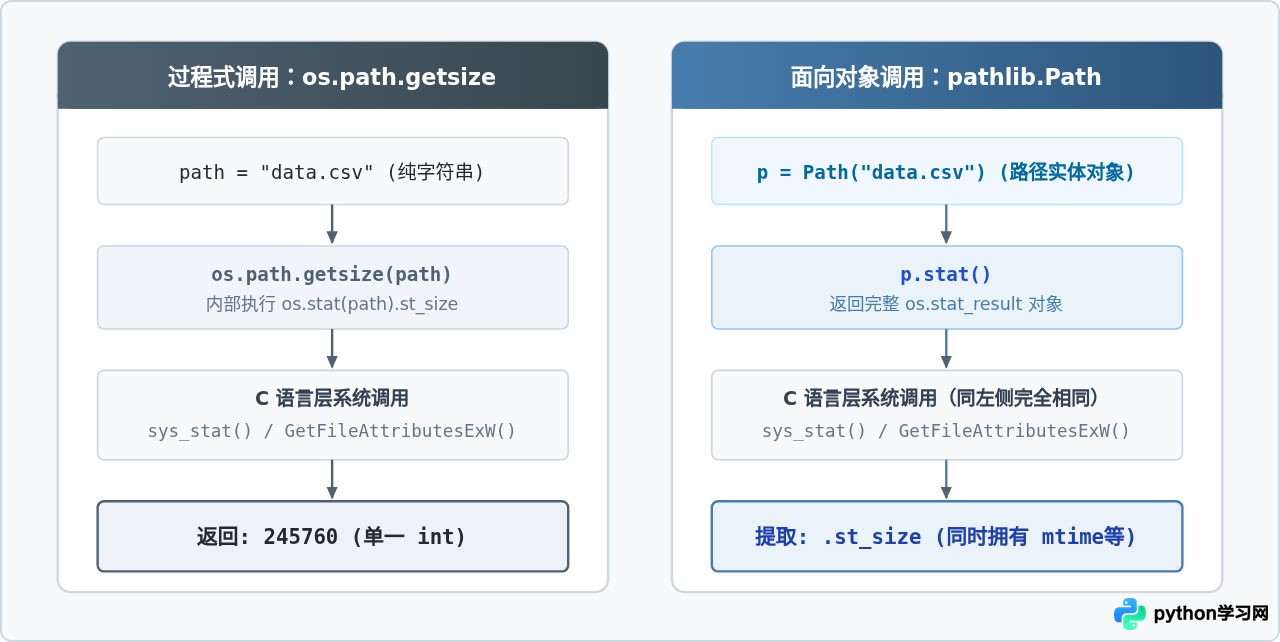
三、实用进阶:将原始字节转换为易读格式 (KB/MB/GB)
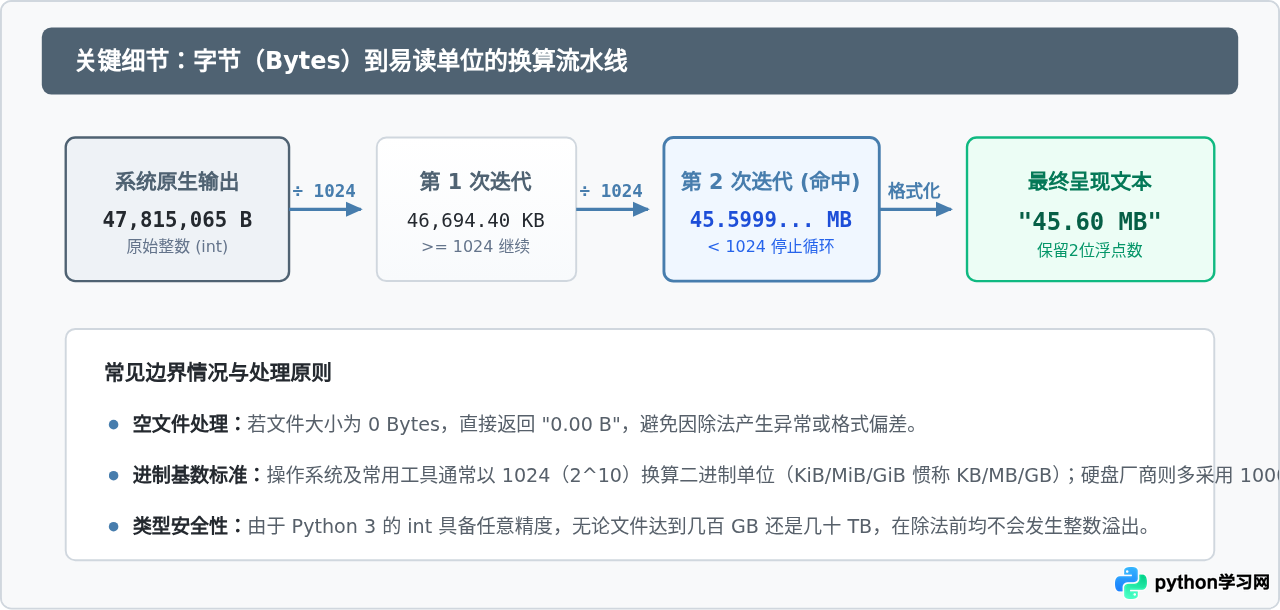
无论是 os.path.getsize() 还是 pathlib.Path.stat().st_size,返回的结果始终为未加工的字节数(Bytes)。例如一个 150 MB 的视频文件,其返回值为 157286400,不利于人眼直观阅读。在实际输出或日志记录时,需要将其格式化为具有适当单位的字符串。
1. 格式化换算实现
根据计算机存储规范,二进制计量单位每阶换算基数为 1024(即 1024 Bytes = 1 KiB,1024 KiB = 1 MiB)。我们可以通过循环递除或对数运算,编写一个轻量通用的换算函数:
def format_file_size(size_bytes: int) -> str:
    """
    将字节大小格式化为人类易读单位(B, KB, MB, GB, TB)

    :param size_bytes: 非负整数形式的字节数
    :return: 带两位小数和单位的字符串
    """
    if size_bytes < 0:
        raise ValueError("文件大小不能为负数")
    if size_bytes == 0:
        return "0.00 B"

    units = ["B", "KB", "MB", "GB", "TB", "PB"]
    current_size = float(size_bytes)
    unit_index = 0

    while current_size >= 1024.0 and unit_index < len(units) - 1:
        current_size /= 1024.0
        unit_index += 1

    return f"{current_size:.2f} {units[unit_index]}"
2. 整合进 pathlib 的实际运行效果
调用示例from pathlib import Path
target = Path("sample_archive.zip")
if target.is_file():
raw_size = target.stat().st_size
readable_size = format_file_size(raw_size)
print(f"原始字节: {raw_size} Bytes")
print(f"易读格式: {readable_size}")原始字节: 47815065 Bytes
易读格式: 45.60 MB
四、两种方法的维度对比与技术选型
为了在工程实践中作出合理的决策,下表详细梳理了两者的核心差异:
| 对比维度 | os.path.getsize(path) | pathlib.Path(path).stat().st_size |
|---|---|---|
| 引入版本 | Python 1.4+(经典标准库) | Python 3.4+(PEP 428,现代标准) |
| 调用范式 | 面向过程的独立函数,接收字符串/路径 | 面向对象的实例方法,内聚在 Path 实体上 |
| 返回值类型 | 直接返回 int 整数 |
返回 stat_result 元组对象后取属性 |
| 路径组合能力 | 弱,需配合 os.path.join 等字符串操作 |
强,原生支持 / 运算符与链式调用 |
| 多重元数据获取 | 每次单独查询,多次触发 stat 开销 |
一次 stat() 调用即可解构全部属性 |
| 软链接跟随机制 | 跟随符号链接,获取源目标大小 | stat() 跟随符号链接;lstat() 获取链接本身 |
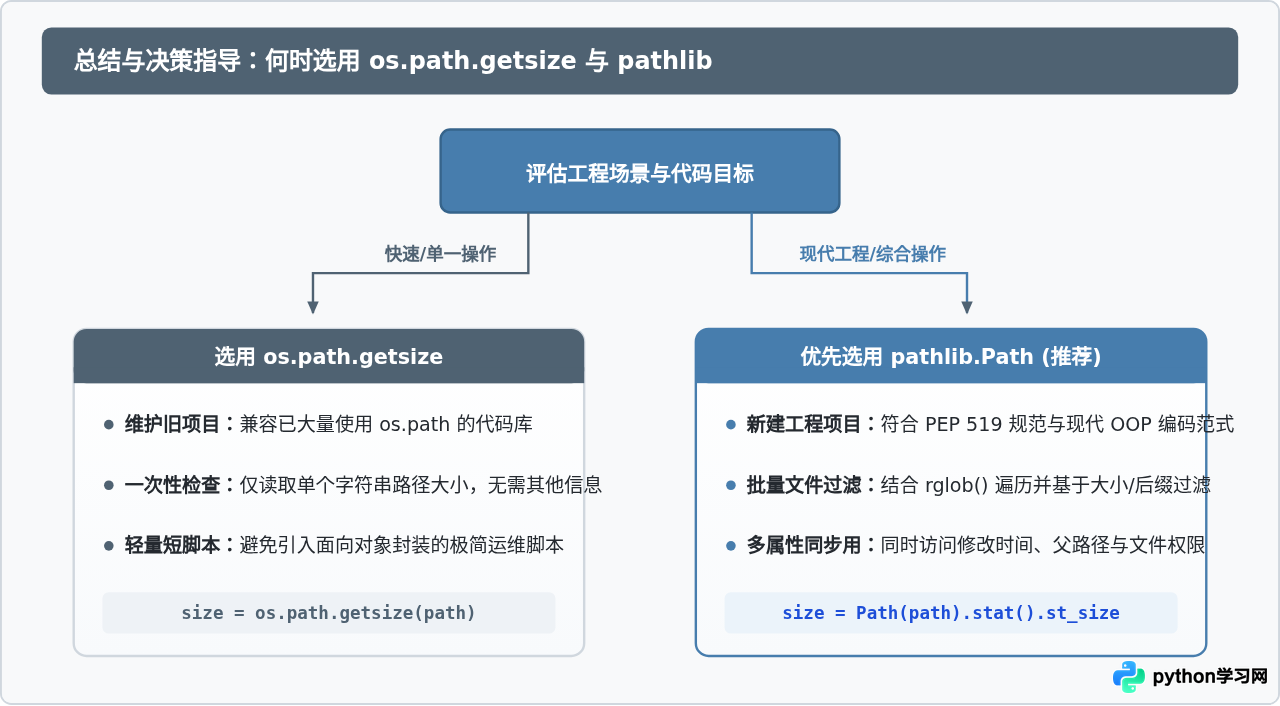
| 适用场景 | 旧代码维护、单次极简查询、轻量脚本 | 现代化工程、复杂目录遍历、多属性同时处理 |
在 Python 3.6+ 的现代项目中,推荐优先选用 pathlib.Path。它不仅使代码结构更加优雅、语义更清晰,还能在需要获取文件扩展名、父路径、修改时间等元数据时避免重复触发系统调用。如果仅仅是在维护一段遗留脚本,或只需对传入的单个字符串路径进行一次性大小查询,os.path.getsize 依然是简洁、免导包实例化的有效选择。
五、开发中常见陷阱与注意事项
-
目录与普通文件的区别:
对一个目录路径调用
os.path.getsize()或Path.stat().st_size,返回的并不是该目录下所有文件的总大小,而是该目录元数据结构在文件系统中占用的块空间(在 Linux/macOS 下通常固定为4096字节,在 Windows 下也非递归汇总)。若需要计算目录的总体积,必须通过循环遍历累加其中普通文件的大小(例如使用os.walk()或Path.rglob('*'))。 -
软链接(符号链接)的行为:
默认情况下,
os.path.getsize(path)和Path.stat().st_size均会跟随软链接(follow symlinks),返回其指向的目标文件的真实大小。若软链接指向的目标文件已被删除,调用会抛出FileNotFoundError。如果你的诉求是获取软链接本身符号数据的大小,应改用os.lstat(path).st_size或Path.lstat().st_size。 -
高并发批量扫描的性能提示:
如果需要扫描成千上万个文件的大小,反复对每个路径调用
os.path.getsize()或构造Path会引起大量系统调用。在遍历目录时,更推荐使用os.scandir(),其返回的DirEntry对象在支持的操作系统上会在扫描目录树的同时缓存stat信息,直接调用entry.stat().st_size可大幅提升批量读取的吞吐性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









